
دو ستون با هم مخلوط میشوند، فرمولها جابهجا میشوند، متن داخل فایل اسکنشده قابل انتخاب نیست و جدولها بعد از ترجمه دیگر شبیه نسخه اصلی نیستند. اگر با مقالههای علمی، گزارشهای فنی یا PDFهای اسکنشده کار کرده باشید، احتمالاً یکی از این مشکلات را دیدهاید.
در چنین شرایطی معمولاً اولین چیزی که به ذهن میرسد کیفیت مترجم است. اما همیشه مشکل از خود ترجمه نیست. گاهی خطا خیلی زودتر اتفاق میافتد؛ زمانی که ابزار تلاش میکند محتوای PDF را استخراج و ساختار صفحه را تشخیص دهد.
PDF برخلاف یک صفحه وب یا فایل متنی ساده، فقط مجموعهای از جملهها نیست. جای متن، ترتیب ستونها، جدولها، پاورقیها، تصاویر و فرمولها هم بخشی از اطلاعات سند هستند. اگر این ساختار در مرحله استخراج از بین برود، حتی ترجمهای که از نظر زبانی درست است میتواند نتیجهای نامرتب و دشوار برای خواندن ایجاد کند.
در یک PDF ساده معمولاً متن بهصورت واقعی داخل فایل ذخیره شده است. میتوانید آن را انتخاب کنید، کپی کنید و ترتیب جملهها هم تقریباً همان چیزی است که روی صفحه میبینید. چنین فایلهایی معمولاً دردسر زیادی برای ترجمه ایجاد نمیکنند.
اما مقالههای علمی و گزارشهای حرفهای اغلب ساختار پیچیدهتری دارند. ممکن است صفحه دو یا سه ستون داشته باشد، کنار متن جدول قرار گرفته باشد یا بخشی از توضیحات در پاورقی آمده باشد. اگر ابزار فقط همه متنهای صفحه را پشت سر هم استخراج کند، ترتیب واقعی خواندن میتواند از بین برود.
مثلاً ممکن است انتهای یک جمله از ستون چپ مستقیماً به ابتدای جملهای از ستون راست متصل شود. از نظر ظاهری هنوز متن وجود دارد، اما ساختار منطقی آن دیگر همان ساختار مقاله اصلی نیست.
همه PDFها واقعاً «متن» ندارند. بعضی فایلها در اصل مجموعهای از تصاویر اسکنشده هستند. شما نوشتهها را روی صفحه میبینید، اما کامپیوتر آنها را بهعنوان تصویر میشناسد.
در این حالت ابتدا باید نوشتههای داخل تصویر تشخیص داده شوند. کیفیت اسکن، اندازه فونت، زاویه صفحه، لکهها و حتی نوع قلم میتوانند روی نتیجه تأثیر بگذارند. اگر این مرحله بخشی از متن را اشتباه تشخیص دهد، ترجمه روی همان متن اشتباه انجام میشود.
به همین دلیل است که تغییر مدل ترجمه همیشه مشکل PDF اسکنشده را حل نمیکند. اگر ورودی از ابتدا ناقص یا اشتباه باشد، مرحله ترجمه نمیتواند همه آن خطاها را جبران کند.
فرض کنید یک مقاله علمی دو ستونه دارید. برای یک خواننده انسانی، ترتیب واضح است: ابتدا ستون اول خوانده میشود و سپس ستون دوم.
اما برای یک ابزار استخراج متن، صفحه فقط مجموعهای از بلوکهای مختلف است. اگر رابطه میان این بلوکها درست تشخیص داده نشود، متن دو ستون ممکن است با هم ترکیب شود.
این مشکل گاهی خطرناکتر از یک ترجمه ضعیف است، چون خروجی ممکن است از نظر دستوری کاملاً طبیعی به نظر برسد. شما جملهای روان میخوانید، اما نمیدانید که آن جمله از دو بخش نامرتبط ساخته شده است.
در مقالههای علمی، همین اتفاق میتواند معنی یک پاراگراف یا حتی نتیجه یک بخش را تغییر دهد.
جدول فقط چند خط متن کنار هم نیست. موقعیت هر سلول، عنوان ستونها، واحدها و رابطه میان ردیفها اهمیت دارد. اگر محتوای جدول به شکل متن ساده استخراج شود، مشخص نیست هر عدد یا عبارت متعلق به کدام ستون بوده است.
فرمولها هم وضعیت مشابهی دارند. نمادهای ریاضی، متغیرها، توانها، زیرنویسها و واحدها معمولاً نباید مانند جملههای عادی پردازش شوند. حتی تغییر جای یک نماد میتواند معنی فرمول را عوض کند.
به همین دلیل، هنگام ترجمه اسناد فنی تنها کیفیت زبان مهم نیست. حفظ رابطه میان بخشهای مختلف صفحه هم اهمیت دارد.
یکی از سادهترین راهها برای فهمیدن میزان پیچیدگی یک PDF این است که بخشی از متن آن را کپی و در یک ویرایشگر ساده Paste کنید.
اگر جملهها به همان ترتیب باقی ماندند، احتمالاً فایل ساختار سادهای دارد. اما اگر ترتیب متن تغییر کرد، ستونها با هم مخلوط شدند یا بعضی بخشها اصلاً کپی نشدند، احتمالاً سند به پردازش بیشتری نیاز دارد.
برای PDFهای اسکنشده نیز اگر اصلاً امکان انتخاب متن وجود ندارد، فایل ابتدا به تشخیص متن از تصویر نیاز خواهد داشت.
این آزمایش ساده میتواند خیلی زود مشخص کند که مشکل اصلی احتمالاً در ترجمه است یا در خواندن خود فایل.
در یک متن معمولی، طبیعی بودن جملهها اهمیت زیادی دارد. اما در مقاله علمی، گزارش مالی یا سند فنی، محل قرار گرفتن اطلاعات هم بخشی از معنی است.
وقتی یک پاراگراف به Figure 2 یا Table 4 اشاره میکند، خواننده باید بتواند آن شکل یا جدول را پیدا کند. اگر متن ترجمه شود اما ارتباط آن با اجزای صفحه از بین برود، نتیجه از نظر زبانی قابل خواندن است ولی برای مطالعه واقعی چندان کاربردی نیست.
به همین دلیل ترجمه PDFهای پیچیده بیشتر شبیه پردازش یک سند کامل است تا ترجمه چند پاراگراف مستقل.
نه. بیشتر PDFهای ساده را میتوان بدون مشکل خاصی ترجمه کرد. اگر فایل چند صفحه متن معمولی دارد، متن قابل انتخاب است و جدول یا فرمول زیادی ندارد، روشهای استاندارد معمولاً کافی هستند.
تفاوت زمانی مشخص میشود که سند اسکنشده باشد، ساختار چندستونه داشته باشد یا عناصر مختلف صفحه ارتباط نزدیکی با هم داشته باشند. در چنین فایلهایی، نحوه تحلیل و بازسازی ساختار سند میتواند به اندازه خود مدل ترجمه اهمیت داشته باشد.
برای همین بعضی ابزارهای ترجمه PDF حالتهای جداگانهای برای پردازش فایلهای پیچیده ارائه میکنند. برای مثال، قابلیت PDF Plus در SelectTranslate برای فایلهایی طراحی شده که پیش از ترجمه به تحلیل دقیقتری از ساختار صفحه نیاز دارند.
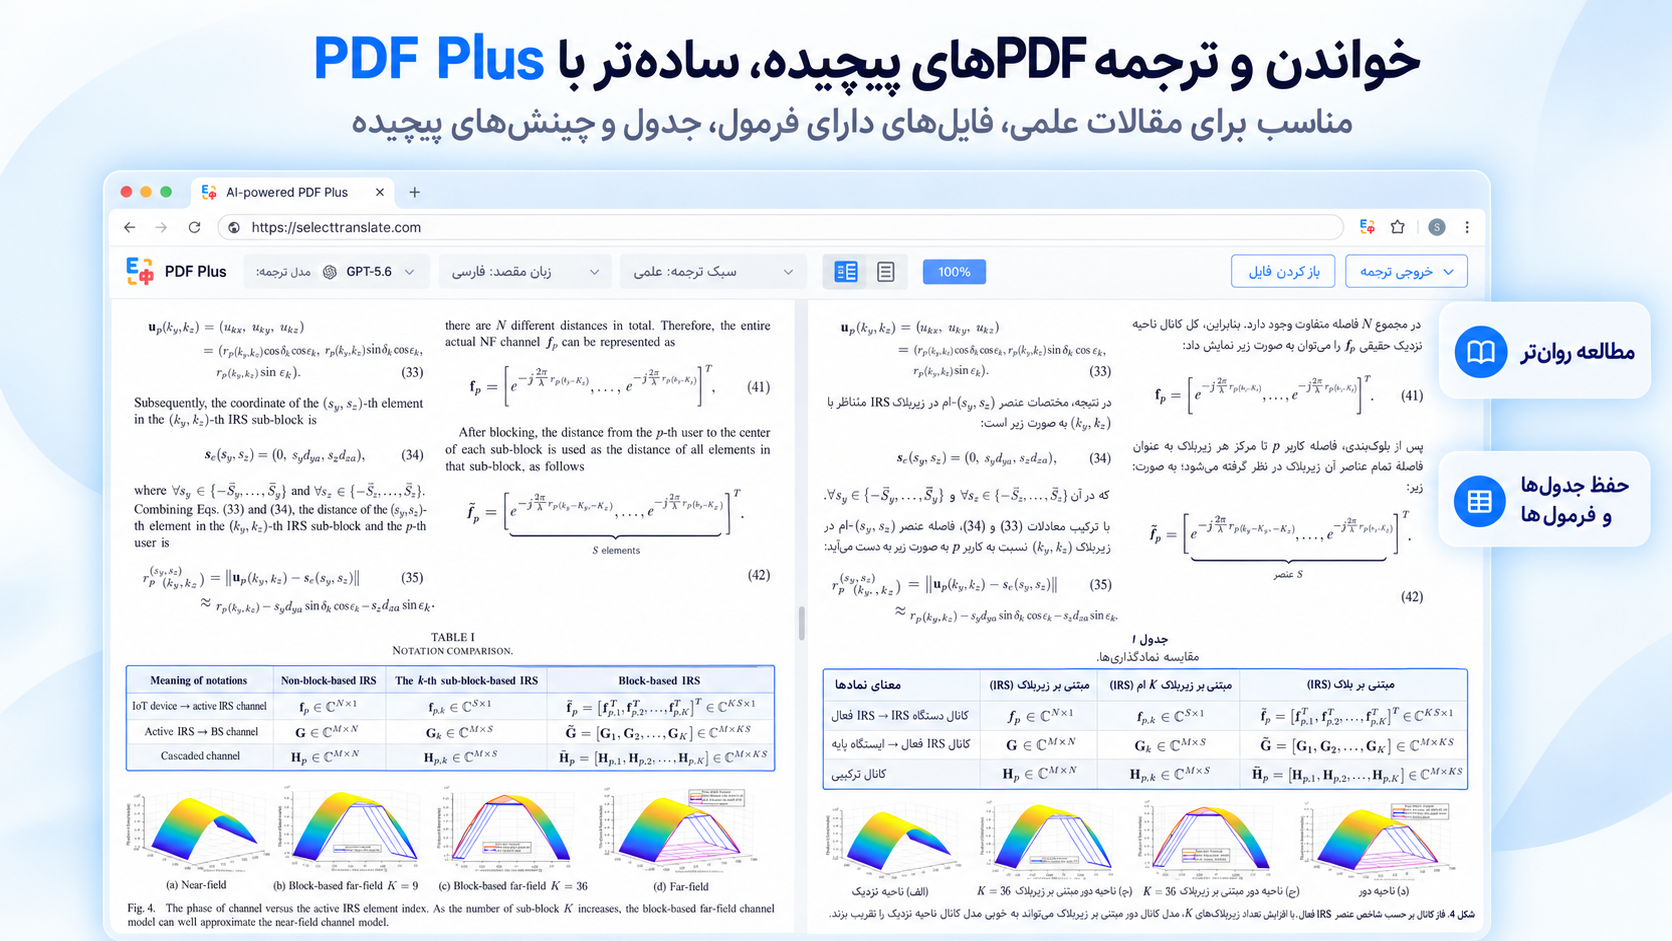
وقتی ترجمه یک PDF بههمریخته به نظر میرسد، همیشه لازم نیست ابتدا مدل ترجمه را عوض کنید.
ممکن است مشکل اصلی این باشد که ترتیب ستونها درست تشخیص داده نشده، متن اسکنشده ناقص خوانده شده یا جدول و فرمول بهصورت متن معمولی استخراج شدهاند.
برای PDFهای ساده معمولاً ترجمه مستقیم کافی است. اما هرچه ساختار فایل پیچیدهتر باشد، کیفیت مرحله قبل از ترجمه اهمیت بیشتری پیدا میکند.
در نهایت، ترجمه خوب PDF فقط این نیست که جملهها درست به زبان دیگری تبدیل شوند؛ مهم است که بعد از ترجمه هنوز بتوانید همان سند را درست بخوانید و دنبال کنید.

