
منتشرشده در: وبلاگ SyncedReview به تاریخ ۲۲ سپتامبر ۲۰۲۰
لینک منبع: Adobe’s DL-Based ‘HDMatt’ Handles Image Details Thinner Than Hair
پرداخت تصویر نقش مهمی در ویرایش و ترکیب تصویر و ویدیو بازی میکند. اگر چه روشهای یادگیری عمیق موجود میتوانند نتایج قابل قبولی از تطابق تصویر ایجاد کنند، اما عملکرد آنها در کاربردهای دنیای واقعی، که در آن تصاویر ورودی اکثرا تفکیک پذیری (رزولوشن) بالایی دارند، دچار مشکل میشود. برای پرداختن به این موضوع، گروهی از محققان از UIUC، ادوبی ریسرچ و دانشگاه اورگان، HDMatt، اولین رویکرد تصویر مبتنی بر یادگیری عمیق برای ورودیهای تصویر با وضوح بالا را ارائه کردهاند.
به طور کلی، رویکردهای یادگیری عمیق یک تصویر ورودی کامل و یک نقشه سه تایی مربوط به آن را برای تطبیق آلفا با استفاده از شبکههای عصبی کانولوشنی در بر میگیرند. با این حال، چنین روشهایی ممکن است در هنگام برخورد با تصاویر ورودی با وضوح بالا در اندازه ۵۰۰۰×۵۰۰۰ پیکسل یا بالاتر به دلیل محدودیتهای سختافزاری، شکست بخورند.
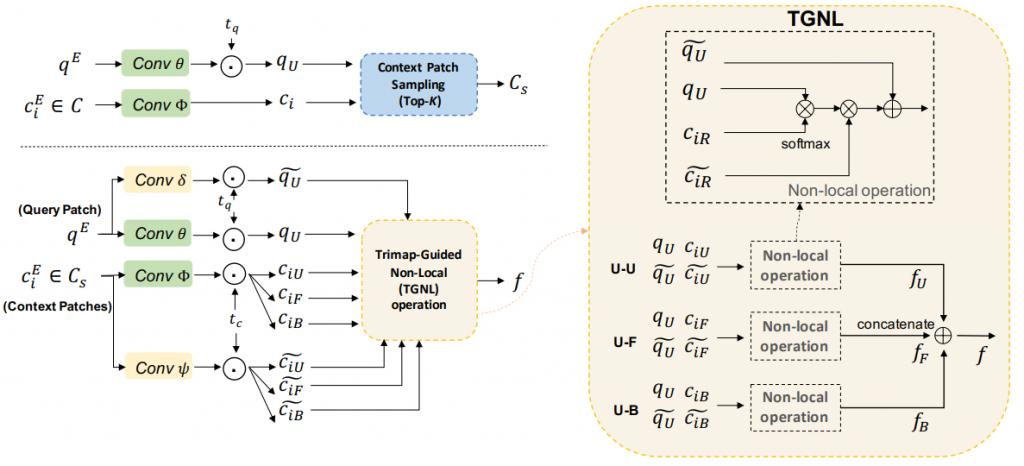
محققان HDMatt را طراحی کردند تا یک تصویر ورودی را کراپ کرده و به تکههای کوچک تقسیم کنند، سپس مقادیر آلفای هر قطعه را تخمین بزنند. با در نظر گرفتن اطلاعاتی که بخاطر استفاده از تنها یک بخش از دست میرود و تناقض پیشبینی بین تکههای مختلف، HDMatt یک ماژول جدید برای استفاده موثر از اطلاعات میانبخشی برای هر بخش کوئری (جاری) معرفی میکند. سپس مقادیر آلفای برآورد شده برای هر قطعه به هم متصل میشوند تا تطبیق آلفای نهایی کل تصویر را تولید کنند.
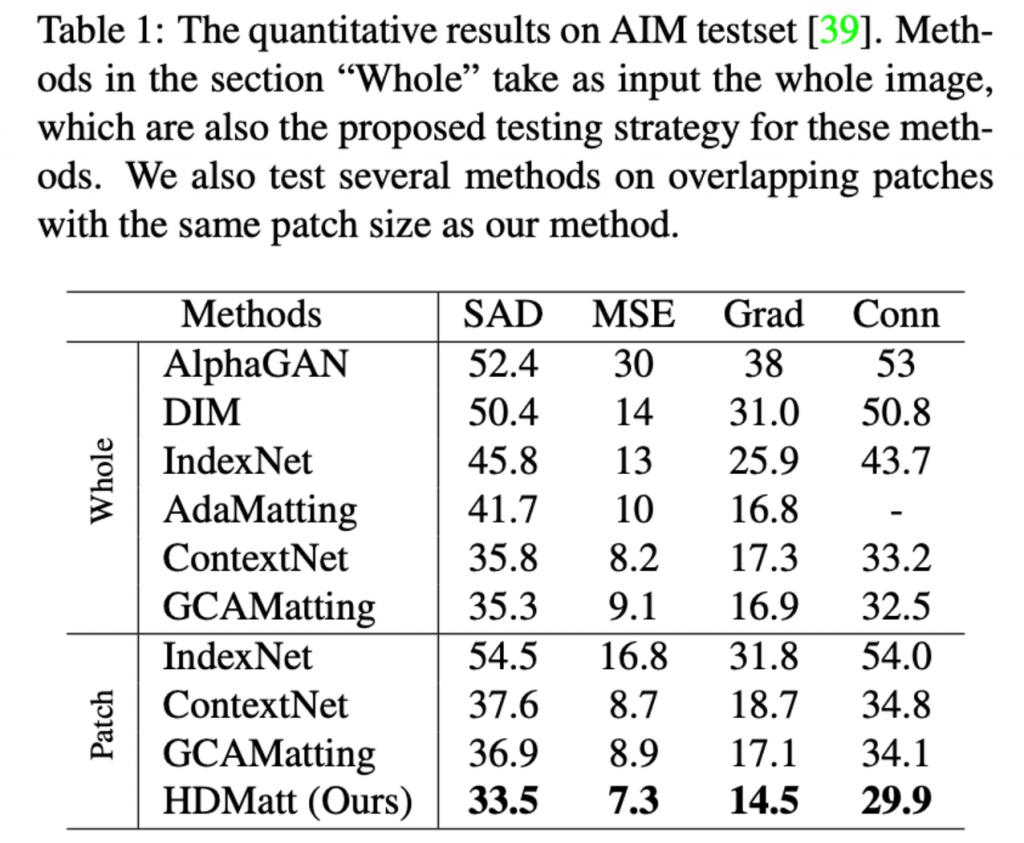
این تیم، قابلیت HDMatt را با استفاده از ادوبی ایمیج متتینگ (AIM) و معیارهای AlphaMatting آزمایش کرد، که نتایج کمی آن همگی برتر از رویکردهای SOTA موجود بودند.
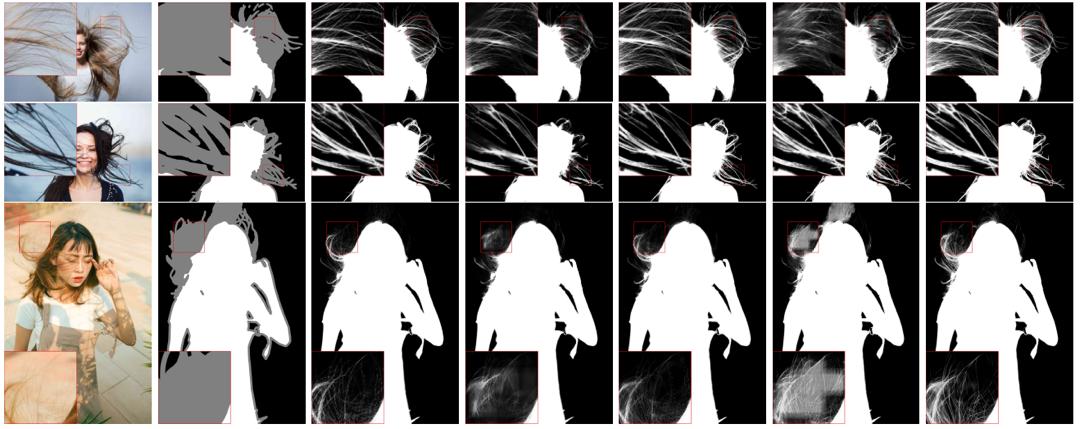
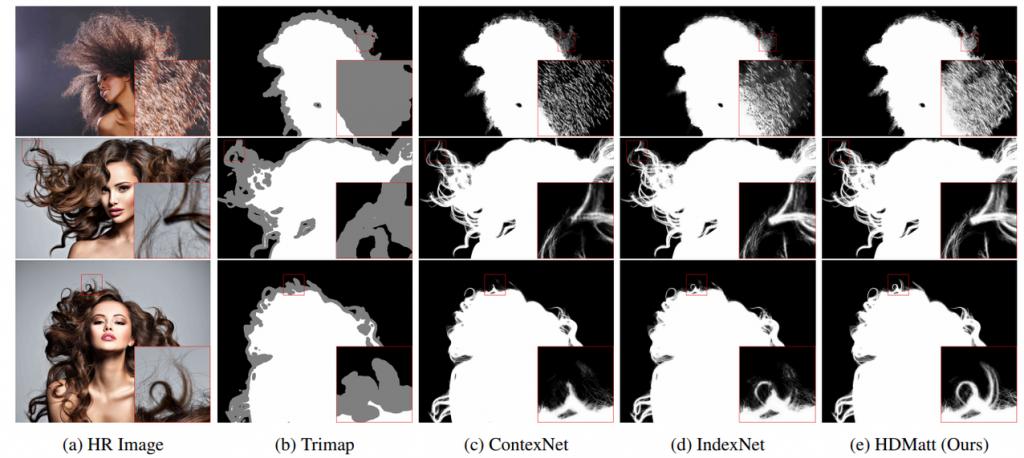
این تیم همچنین با استفاده از تصاویر ورودی با قدرت تفکیک تا ۶۰۰۰×۶۰۰۰ پیکسل، ارزیابیهای مقایسهای را با روشهای تطبیق تصویر SOTA،از جمله IndexNet و ContextNet انجام داد، که در آن HDMatt توانست جزئیات دقیقتر و ریزتری را تشخیص دهد.
این متن با استفاده از ربات مترجم مقالات یادگیری عمیق ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.


