
منتشرشده در towardsdatascience به تاریخ ۱۹ ژوئن ۲۰۲۱
لینک منبع How To Capitalize Words Using AI
آیا تا به حال با مجموعه بزرگی از متون مواجه شدهاید که حروف بزرگ کلمات را از دست دادهاند؟ شما باید قبل از انتشار متن، هزاران کلمه را بزرگ کنید. در این پست، من نحوه تعمیر خودکار اطلاعات پرونده در اسناد را نشان میدهم.
در اصل Truecasing یک پردازش زبان طبیعی برای مشکل پیدا کردن حروف بزرگ مناسب کلمات در متنی است که در آن چنین اطلاعاتی در وجود ندارد.
موارد استفاده شامل رونوشتهای منابع صوتی مختلف، تشخیص خودکار صحبت، تشخیص نوری شخصیت، سوابق پزشکی، پیامهای آنلاین و بازی است. منابع متن خام اغلب با عجله تولید میشوند و بیشتر کلمات در حروف کوچک نوشته میشوند.
چندین روش عملی برای مساله Truecasing وجود دارد:
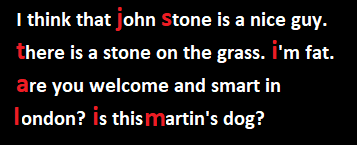
من ترکیب ساده جداسازی جمله و تکنیکهای بخشی از گفتار را به صورت زیر پیشنهاد میکنم.
الگوریتم به درستی اولین مثال کلمه استون را به عنوان نام یک شخص، که باید بزرگ نوشته شود، شناسایی میکند.
این روش در مجموعه بزرگی از اسناد حساس به پرونده چگونه عمل میکند؟ در زیر من کد را با استفاده از بررسیهای معروف Yelp Dataset تست میکنم. متن قبل از اینکه توسط کد من پردازش شود، کوچک است. متن بزرگ حاصل با نسخه اصلی با استفاده از امتیاز BLEU مقایسه میشود.
ما ۸۶.۷۱ % را به عنوان معیاری برای کیفیت تعمیر truecasing بدست میآوریم، با مقایسه تعداد n-gram بین سرمایهگذاری پیشبینیشده و سرمایهگذاری حقیقی.
در این مقاله، من در مورد دنبال کردن، فرآیند بازیابی اطلاعات موردی به متنی که به طور بد نوشته شده یا نشده است، بحث کردهام، و یک پاککن واقعی را پیشنهاد کردهام که دارای توافق ۸۶٪ با بررسیهای کاری نوشته شده حرفهای است. اعتماد به سایر وظایف NLP مانند استخراج خودکار محتوا و ترجمه ماشینی کمک میکند تا دقت را افزایش دهید.
این متن با استفاده از ربات مترجم مقالات علم داده ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.
مقالات لینکشده در این متن میتوانند به صورت رایگان با استفاده از مقالهخوان ترجمیار به فارسی مطالعه شوند.


