
منتشرشده در towardsdatascience به تاریخ ۱ مه ۲۰۲۱
لینک منبع Build Your Own Movie Recommender System Using BERT4Rec
الگوریتمهای توصیه بخش اصلی بسیاری از خدماتی هستند که ما هر روز از آنها استفاده میکنیم، از پیشنهادهای ویدئویی در یوتیوب گرفته تا خرید اقلام در آمازون، بدون فراموش کردن Netflix.در این مقاله، ما یک سیستم توصیه ساده اما قدرتمند به نام BERT4Rec را به همراه توصیه متوالی با دو جهت اجرا خواهیم کرد.
ما این مدل را برای توصیههای فیلم بر روی یک پایگاهداده از حدود ۶۰۰۰۰ فیلم اعمال خواهیم کرد.
مطالعه مقاله تحلیل انگیزه رسانههای اجتماعی با VADER توصیه میشود.
هدف ما این است که با توجه به تاریخچه فیلمهایی که در گذشته دیدهاند، فیلم را به کاربران معرفی کنیم. این توصیه به طور مستقیم از دادهها یاد گرفته میشود و برای هر کاربر شخصیسازی میشود.
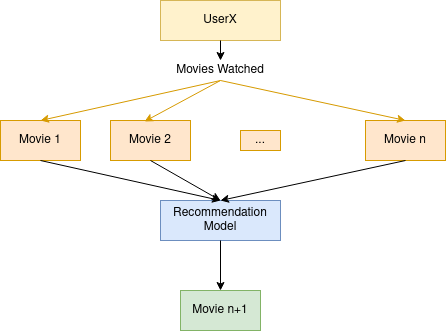
ما از مجموعه داده MovieLens-25m استفاده خواهیم کرد. (https://grouplens.org/datasets/movielens/25m/). این یک مجموعه داده است که تعامل بین ۱۶۲۵۴۱ کاربر و ۶۲۴۲۳ فیلم را گزارش میدهد. ما میتوانیم توالی مرتب شدهای از لحاظ زمانی از فیلمها را بسازیم که آنها با هر کاربر تعامل دارند. ما از این دنبالهها برای آموزش سیستم توصیه خود استفاده خواهیم کرد.
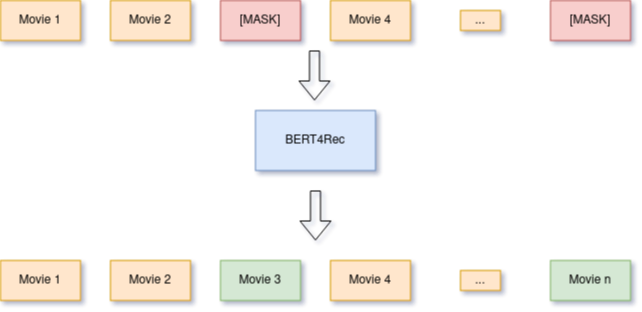
مدل BERT4Rec شبیه برت معمولی برای NLP است. این یک شبکه ترانسفورمر است که برای پیشبینی فیلمهای «نقابدار (masked)» از تاریخ کاربر آموزشدیده است. اولین مرحله ساخت تاریخ کاربر در قالب یک لیست مرتب شده زمانی از فیلمها است.

برخی از این فیلمها با یک توکن جایگزین شدهاند [ MASK ].

سپس کار مدل BERT4Rec برای پیشبینی مقادیر صحیح آیتمهای [ MASK ] آموزش داده میشود. با انجام این کار، این مدل نمایشهای مفیدی را برای هر فیلم و همچنین الگوهای مهمی که بین فیلمها وجود دارند، یاد میگیرد.
و سپس برای نتیجهگیری، تنها میتوانیم یک [ MASK ] را در پایان توالی کاربر اضافه کنیم تا فیلمی را پیشبینی کنیم که به احتمال زیاد در آینده میخواهند.
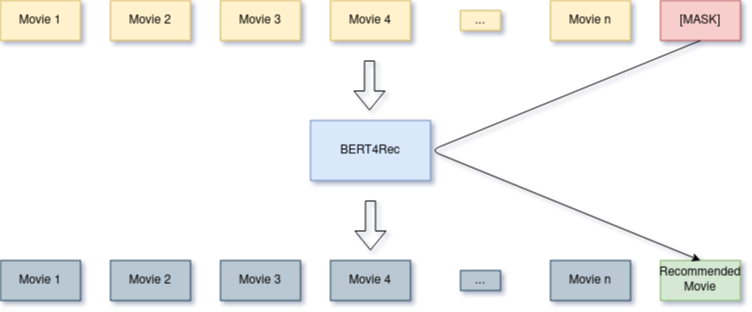
در حقیقت BERT4Rec یک معماری معمول ترانسفورمر مانند معماری مورد استفاده درNLP است:
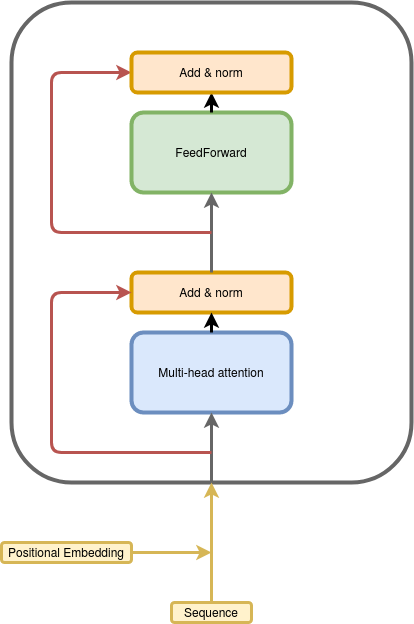
هر فیلم در توالی به یک بردار جایگزاری نگاشت میشود.
src_items = self.item_embeddings(src_items)
سپس، توجه به خود چیزی است که به این معماری اجازه میدهد تا وابستگیهای بلندمدت بین عناصر توالی ورودی را مدل کند. ترتیب با تعبیه موقعیت مدلسازی میشود، که در آن ما یک «بردار موقعیت» را در هر مرحله زمانی یاد میگیریم.
batch_size, in_sequence_len = src_items.size(0), src_items.size(1)
 pos_encoder = (
 torch.arange(0, in_sequence_len, device=src_items.device)
 .unsqueeze(0)
 .repeat(batch_size, 1)
 )
 pos_encoder = self.input_pos_embedding(pos_encoder)

 src_items += pos_encoder
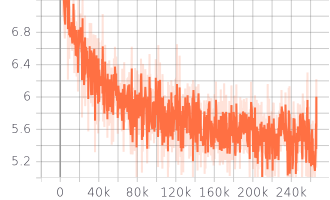
در نهایت، در هر مرحله زمانی، نمرات پیشبینی خروجیهای مدل برای هر گزینه ممکن از مجموع ۶۲۴۲۳ فیلم باشد. ما از این نمرات برای بهینهسازی از دست دادن آنتروپی متقابل قطعی استفاده میکنیم.
ممکن است به مطالعه مقاله استفاده از پایتون برای فرانتاند علاقمند باشید.
اکنون ما از مدل آموزشدیده خود برای ارائه پیشنهادها بر اساس سه سناریو استفاده خواهیم کرد:
مدل قابل توصیه:
['Ice Age (2002)',
"Pirates of the Caribbean: Dead Man's Chest (2006)",
'Avatar (2009)',
'Star Wars: Episode III - Revenge of the Sith (2005)',
'Shrek 2 (2004)',
'Ratatouille (2007)',
'Bruce Almighty (2003)',
'I, Robot (2004)',
'Last Samurai, The (2003)',
'Up (2009)',
'Matrix Revolutions, The (2003)',
'Men in Black II (a.k.a. MIIB) (a.k.a. MIB 2) (2002)',
'Iron Man (2008)',
'Spirited Away (Sen to Chihiro no kamikakushi) (2001)',
'300 (2007)',
'Big Fish (2003)',
"Bridget Jones's Diary (2001)",
'My Big Fat Greek Wedding (2002)',
'Pianist, The (2002)',
'Interstellar (2014)',
'Shaun of the Dead (2004)',
'Moulin Rouge (2001)',
'Juno (2007)',
'WALL·E (2008)',
'Casino Royale (2006)',
'School of Rock (2003)',
'40-Year-Old Virgin, The (2005)',
'Harry Potter and the Order of the Phoenix (2007)',
'Bourne Supremacy, The (2004)',
'Miss Congeniality (2000)']
ما میتوانیم ببینیم که این مدل برخی توصیههای جالب را در ژانر ماجراجویی / فانتزی ایجاد میکند. توجه داشته باشید که این مدل به ژانر فیلم دسترسی ندارد.
تاریخچه کاربر->
توصیه مدل->
['Avengers: Infinity War - Part II (2019)',
'Deadpool 2 (2018)',
'Thor: Ragnarok (2017)',
'Spider-Man: Into the Spider-Verse (2018)',
'Captain Marvel (2018)',
'Incredibles 2 (2018)',
'Untitled Spider-Man Reboot (2017)',
'Ant-Man and the Wasp (2018)',
'Guardians of the Galaxy 2 (2017)',
'Iron Man 2 (2010)',
'Thor (2011)',
'Guardians of the Galaxy (2014)',
'Captain America: The First Avenger (2011)',
'X-Men Origins: Wolverine (2009)',
"Ocean's 8 (2018)",
'Wonder Woman (2017)',
'Iron Man 3 (2013)',
'Pirates of the Caribbean: The Curse of the Black Pearl (2003)',
'Amazing Spider-Man, The (2012)',
'Aquaman (2018)',
'Dark Knight, The (2008)',
'Mission: Impossible - Fallout (2018)',
'Avengers: Age of Ultron (2015)',
'Jurassic World: Fallen Kingdom (2018)',
'Iron Man (2008)',
'Coco (2017)',
'Lord of the Rings: The Two Towers, The (2002)',
'Rogue One: A Star Wars Story (2016)',
'X-Men: The Last Stand (2006)',
'Venom (2018)']
این توصیهها به سرعت در حال اجرا هستند! بیشتر آنها از دنیای مارول هستند، درست مثل تاریخ کاربر.
تاریخچه کاربر->
توصیه مدل->
['Home Alone (1990)',
"Bug's Life, A (1998)",
'Toy Story 2 (1999)',
'Nightmare Before Christmas, The (1993)',
'Babe (1995)',
'Inside Out (2015)',
'Mask, The (1994)',
'Toy Story (1995)',
'Back to the Future (1985)',
'Back to the Future Part II (1989)',
'Simpsons Movie, The (2007)',
'Forrest Gump (1994)',
'Austin Powers: International Man of Mystery (1997)',
'Monty Python and the Holy Grail (1975)',
'Cars (2006)',
'Kung Fu Panda (2008)',
'Groundhog Day (1993)',
'American Pie (1999)',
'Men in Black (a.k.a. MIB) (1997)',
'Dumb & Dumber (Dumb and Dumber) (1994)',
'Back to the Future Part III (1990)',
'Big Hero 6 (2014)',
'Mrs. Doubtfire (1993)',
'Clueless (1995)',
'Bruce Almighty (2003)',
'Corpse Bride (2005)',
'Deadpool (2016)',
'Up (2009)',
"Ferris Bueller's Day Off (1986)"]
در این مورد، این مدل توانست برخی از فیلمهای بزرگ مانند توی استوری ۱ یا تنهایی در خانه را پیشنهاد کند که با موضوع تاریخ کاربر هم خوانی دارند.
در این پروژه، ما یک سیستم قدرتمند توصیه فیلم به نام «BERT4Rec» ساختیم. این یک مدل مبتنی بر لایههای ترانسفورماتور است و با استفاده از یک طرح بسیار مشابه باberT آموزش داده میشود، که در آن برخی از عناصر توالی تاریخچه فیلم کاربر را ماسک میکنیم و سپس سعی میکنیم ارزش واقعی آن آیتمها را پیشبینی کنیم.
نگاهی به جزئیات پیادهسازی در کد زیر بیاندازید:
کد: https://github.com/CVxTz/reco
این متن با استفاده از ربات مترجم مقاله علوم کامپیوتر ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.
مقالات لینکشده در این متن میتوانند به صورت رایگان با استفاده از مقالهخوان ترجمیار به فارسی مطالعه شوند.


