
منتشرشده در: towardsdatascience به تاریخ ۱۵ ژوئن ۲۰۲۱
لینک منبع Estimating Uncertainty with CatBoost Classifiers
این دومین بخش برنامه آموزشی ما در مورد برآورد عدم قطعیت در مدلهای درخت تصمیم مبتنی بر گرادیان (GBDT) است. بخش اول برآوردهای عدم قطعیت در مسائل رگرسیون را مورد بحث قرار میدهد. در این مقاله، ما نشان میدهیم که چه کاری برای مشکلات طبقهبندی و چگونه عدم قطعیت میتواند در کارهای عملی واقعی استفاده شود. یک مخزنGithub که شامل آزمایشها شرحدادهشده در این پست است، در دسترس است. class="el kj" rel="noopener nofollow">here .
در کاربردهای با ریسک بالای ماشین، تشخیص زمانی که سیستم نامشخص است و میتواند اشتباه باشد، مهم است. چنین کاربردهایی عبارتند از تشخیص پزشکی، پیشبینی مالی و غیره. دادهها اغلب به شکل جدولی با ویژگیهای طبیعت و مقیاس متفاوت نشان داده میشوند. برای چنین دادههایی، بهترین نتایج معمولا با مدلهای GBDT مانند، کاتابوست حاصل میشوند.
به یاد داشته باشید که دو منبع اصلی عدم قطعیت وجود دارد: دادهها و دانش. عدم قطعیت دادهها ناشی از نویز در دادهها است (واریانس بالای مقدار هدف یا کلاسهای همپوشان). عدم قطعیت دانش زمانی ایجاد میشود که به مدل یک ورودی دور از دادههای آموزشی داده شود. از آنجا که مدل اطلاعات کمی در مورد این منطقه دارد، میتواند اشتباه کند. بنابراین، عدم قطعیت دانش میتواند برای تشخیص نمونههای غیرعادی استفاده شود.
ما در یک مثال عملی نشان خواهیم داد که چگونه تشخیص ناهنجاری میتواند با استفاده از کاتابوست انجام شود. برای این کار، ما مجموعه داده تشخیص نفوذKDD-۹۹ را در نظر میگیریم. وظیفه، تشخیص نفوذهای شبکه به منظور محافظت از شبکه کامپیوتری در برابر کاربران غیر مجاز است. مدلها برای طبقهبندی فعالیت شبکه به صورت عادی یا به عنوان یکی از چندین نوع نفوذ آموزش داده میشوند. به طور کلی، مجموعه آزمایش شامل چندین نوع حمله است که در مجموعه قطار مشاهده نمیشوند-این امر به خوبی با سناریوهای عملی واقعی مطابقت دارد. برای یک سیستم ML، مهم است که قادر به تشخیص رفتارهای غیرعادی کاربر-رفتار در طول زمان باشیم و هکرهای مخرب همیشه در حال تلاش برای یافتن روشهای جدید حمله به یک سیستم هستند.
بنابراین، هدف ما این است:
برای این آزمایش ما دادهها را همانطور که در [ ۳ ] توضیح داده شد پیش پردازش میکنیم. ما دادههای تست اصلی را به دو زیر مجموعه تقسیم میکنیم: یک زیر مجموعه به نام «تست در دامنه» که شامل انواع حملههایی است که در دادههای آموزشی وجود دارند و زیر مجموعه دیگری به نام «تست خارج از دامنه» که تنها شامل انواع حملات ناشناخته است. سپس وظیفه طبقهبندی براساس معیارهای عدم قطعیت است که آیا یک نمونه ورودی به مجموعههای تست درون دامنه یا خارج از دامنه تعلق دارد. ما مجموعهای از ۱۰ مدل شتابدهنده SGLB را بر روی دادههای آموزشی آموزش میدهیم. یک اسکریپت که به طور کامل این تنظیمات را دوباره ایجاد میکند در Github در دسترس است.
با توجه به مجموعهای از مدلهای طبقهبندی SGLB، میتوان عدم قطعیت را به صورت زیر محاسبه کرد. هر مدل یک توزیع بر روی کلاسهای شناختهشده بدست میدهد. ما میتوانیم تمام مدلها را در یک مجموعه با میانگینگیری از توزیع پیشبینی آنها ترکیب کنیم تا پیشبینی خلفی را بدست آوریم:
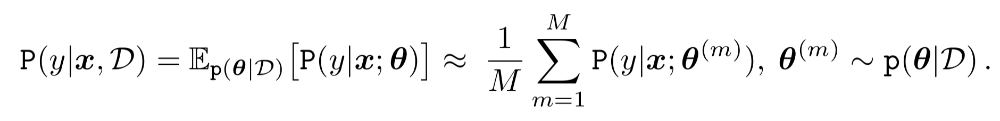
آنتروپی پسینی پیشبینیکننده، مجموعهای از عدم قطعیت کل است. عدم قطعیت کل، مجموع دادهها و عدم قطعیت دانش است که در بالا توضیح داده شد (ما برای جزئیات به [ ۱، ۲ ] مراجعه میکنیم). ما میتوانیم با در نظر گرفتن معیارهای تنوع گروهی، مانند اطلاعات متقابل، عدم قطعیت کل را به مولفههای آن تفکیک کنیم که منجر به برآورد عدم قطعیت دانش میشود:
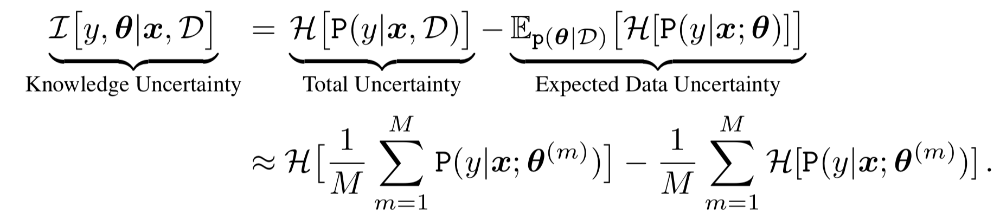
چرا تنوع گروهی عدم قطعیت دانش را اندازهگیری میکند؟ ما فرض میکنیم که مجموعهای از مدلها پیشبینیهای بسیار مشابه و تقریبا یکسان را بر روی دادههای آشنا ارائه میدهند و با دورتر شدن ورودی از دادههای آموزشی، پیشبینیهای بسیار متنوعی را ارائه میدهند. ما میتوانیم معیارهای محلی تنوع را در نظر بگیریم، که همه برآوردهای حاصل از عدم قطعیت دانش را ارائه میدهند، اما این فراتر از دامنه این مقاله است.
حال اجازه دهید ببینیم چه چیزی را در مجموعه داده تشخیص نفوذ KDD به دست میآوریم. اول، ما یک مدل شتابدهندهSGLB را در رژیم چندطبقهای آموزش میدهیم. نرخ خطای بهدستآمده برای پیشبینی نوع فعالیت شبکه ۴٪ است. سپس تخمین میزنیم که چگونه انواع غیر عادی (ناشناخته) حملات را تشخیص میدهیم. برای این کار، ما عدم قطعیت را با استفاده از آنتروپی پیشبینیها اندازهگیری میکنیم. ما کیفیت را از طریق ناحیه زیر یک منحنیROC ارزیابی میکنیم [ ۲ ]. نتیجه ROC-AUC ۸ / ۹۲ است.
سپس، نتایج را با استفاده از مجموعهای از مدلهای شتابدهنده SGLB بهبود میدهیم [ ۱ ]. برای این کار، ما ۱۰ مدل مستقل SGLB (با دانههای مختلف) را آموزش میدهیم. اول، مشاهده میکنیم که پیشبینی گروهی متوسط، نرخ خطا را به ۳.۶٪ بهبود میبخشد. سپس، ما دو معیار عدم قطعیت را مقایسه میکنیم: عدم قطعیت کل، که به عنوان آنتروپی پیشبینی خلفی (پیشبینی متوسط) اندازهگیری میشود، و عدم قطعیت دانش که به عنوان اطلاعات متقابل اندازهگیری میشود. همانطور که انتظار میرود، بهترین نتایج با عدم قطعیت دانشی حاصل میشوند که به مقدار ۹۴.۲ ROC-AUC دست مییابد.
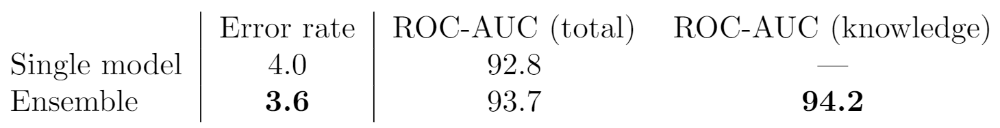
این آزمایش کوچک نشان میدهد که ما میتوانیم از مجموعهای از مدلهای تقویتشده شیب برای رسیدن به دو هدف استفاده کنیم:
این امر مزایای استفاده از مدلهای ترکیبی GBDT را نشان میدهد.
این متن با استفاده از ربات مترجم مقاله علم داده ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.
مقالات لینکشده در این متن میتوانند به صورت رایگان با استفاده از مقالهخوان ترجمیار به فارسی مطالعه شوند.


