
منتشرشده در: towardsdatascience به تاریخ ۳۱ می ۲۰۲۱
لینک منبع: Using Transfer Learning for Breast Cancer Detection
هر ساله بیش از 230،000 بیمار مبتلا به سرطان پستان در ایالات متحده وابسته به متاستاز بودن سرطان هستند. تشخیص متاستازیس توسط آسیبشناسانی انجام میشود که در حال بررسی گسترشهای بزرگ بافتهای بیولوژیکی هستند. این فرآیند کار محور و مستعد خطا است. منبع
هدف ما در این پروژه، پیادهسازی یک مدل طبقهبندی متاستاز چندمقیاسی است که در مقاله تشخیص آنزیمهای سرطان در تصاویر آسیبشناسی Gigapxel ارائه شدهاست.
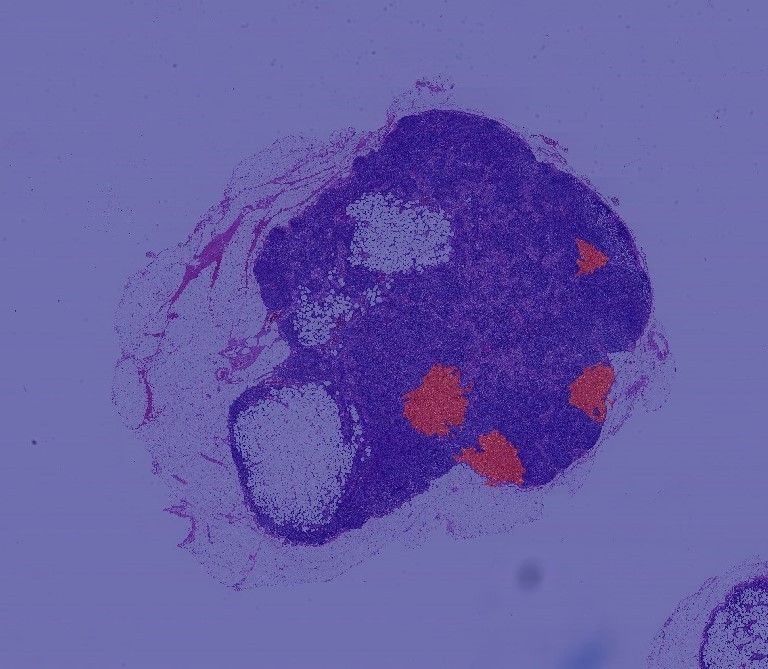
ما از دادههای اسلایدهای چند گیگا پیکسلی CAMELYON-۱۶ استفاده میکنیم. مجموعهای از ۲۲ اسلاید با تومورهای قابلتوجه از مجموعه دادههای اصلی نمونهگیری شدند. هر اسلاید دارای یک ماسک متناظر است که ناحیه تومور را علامتگذاری میکند. ما میتوانیم به حدود ۹ سطح بزرگنمایی دسترسی داشته باشیم.
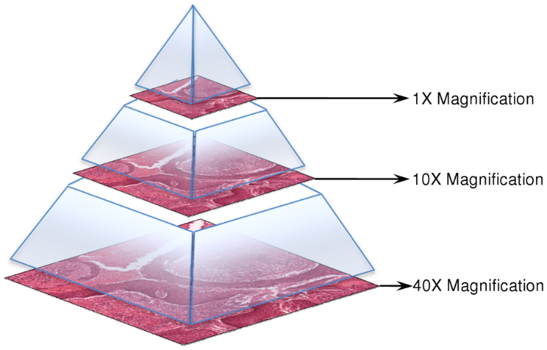
هر تصویر چند مقیاسی یکی پس از دیگری با یک سیستم مختصات ثابت ذخیره میشود تا به کاربران اجازه دهد به هر قطعه تصویری از هر بزرگنمایی دسترسی داشته باشند.
ما از کتابخانه OpenSlide C با اتصالات پایتون استفاده می کنیم تا به طور موثر به پرونده های فشرده شده با اندازه گیگاپیکسل دسترسی داشته باشیم.
به عنوان اولین گام برای تولید دادههای آموزشی برچسبدار، ما از یک رویکرد پنجره کشویی برای لغزش بر روی سطوح زوم بالاتر و ایجاد تصاویر برچسب دار از بخشهای اسلاید استفاده میکنیم، که بعدا برای آموزش و آزمایش از آن استفاده خواهیم کرد.
ما از رویکرد دنبال شده در مقاله استفاده میکنیم، که در آن یک پنجره مرکزی را تعریف میکنیم، و اگر مرکز شامل حداقل ۱ پیکسل به عنوان تومور باشد، تصویر را برچسب میزنیم تا حاوی سلولهای توموری باشد.
اندازه پنجره و اندازه مرکز به ترتیب ۸۰ و ۵۰ انتخاب شدهاند. در نهایت، برای چند مقیاسی کردن دادههای آموزشی، ما یک نسخه با اندازه مشابه از بخش تصویر اصلی ایجاد میکنیم. نسخه زوم شده برای ارائه یک زمینه در سطح کلان برای مدل طبقهبندی استفاده میشود. ما دادهها را با استفاده از یک رویکرد چند مقیاسی تولید کردهایم و از دو بزرگنمایی مختلف برای آمادهسازی مجموعه داده استفاده کردهایم.
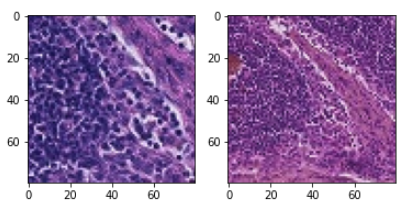
ما از تکنیکهای مختلف افزایش داده برای تکمیل دادههای آموزشی خود و قویتر کردن مدل خود استفاده کردهایم.
ما افزودههای متعامد را برای معرفی تغییرناپذیری دورانی معرفی کردیم زیرا یک اسلاید میتواند در هر یک از این جهت گیری ها مورد بررسی قرار گیرد.
برای اینکه مدل خود را در مقابل نور و قدرت رنگ مقاوم کنیم، رنگها را به صورت زیر مختل کردیم.
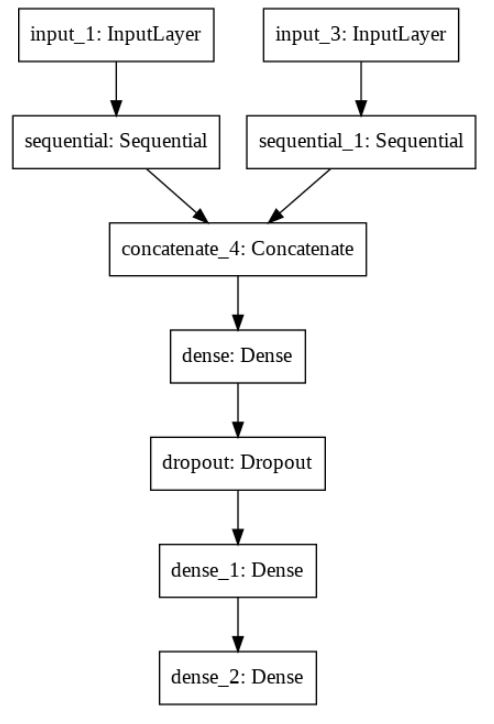
ما از یک مدل V3 ورودی چندبرجی برای استفاده از تصاویر چندمقیاسی برای طبقهبندی استفاده کردیم. ما فقط لایههای بالایی را به خوبی تنظیم میکنیم زیرا اینها لایههایی هستند که ویژگیهای سطح بالاتر را یاد میگیرند و نتایج میتوانند تا حد زیادی با تنظیم دقیق این لایهها براساس مجموعه دادههای ما بهبود یابند. برای کسب اطلاعات بیشتر این پست وبلاگ را توسط Google AI بخوانید.
ما در نهایت مدل خود را براساس یک اسلاید تومور جدید تست کردیم. پس از پیشپردازش اسلاید تومور و پیشبینی، ما با استفاده از خروجی مدل یک نقشه داغ ایجاد کردیم.
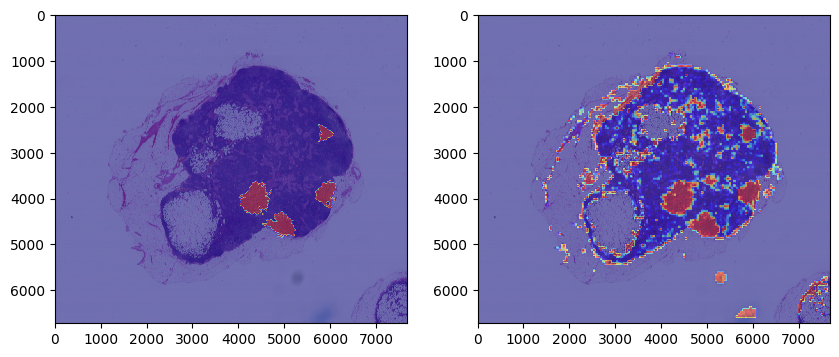
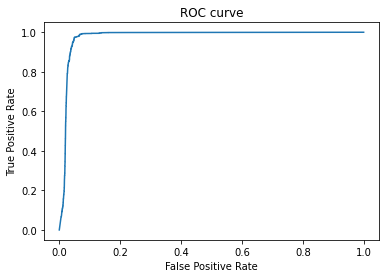
۱. مورد AUC: مقدار ۰.۹۷۶۵۹
۲. آستانه: ۰.۴۸۴۲۹
۳. حساسیت: ۰.۹۷۴۷۸
۴. ویژگی: ۰.۹۵۰۰۴
۵. پوشش: ۰.۹۷۲۷۷
۶. دقت: ۰.۲۲۲۷۵
شما میتوانید کل کد پروژه را در اینجا پیدا کنید.
این متن با استفاده از ربات ترجمه مقاله دیتاساینس ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.
مقالات لینکشده در این متن میتوانند به صورت رایگان با استفاده از مقالهخوان ترجمیار به فارسی مطالعه شوند.


