
در ادامهٔ بخش قبل از سری مقالات معرفی پیکرههای مهم زبان فارسی، بدون مقدمه، سراغ معرفی پیکرههای دیگری از زبان فارسی میرویم.
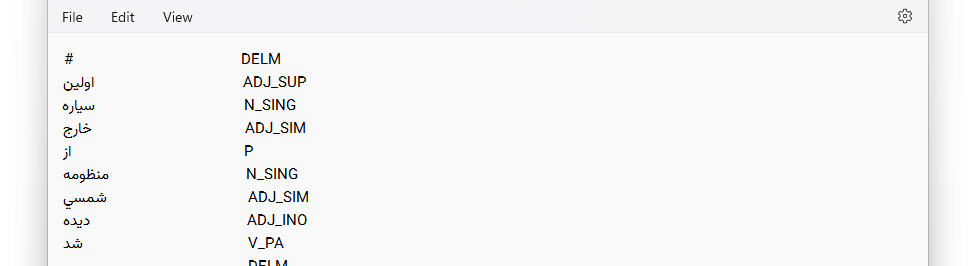
پیکره بیجنخان مجموعهای از متون فارسی در ۴۳۰۰ دستهبندی مختلف شامل ۲ میلیون و ۶۰۰ هزار کلمه است که با ۵۵۰ برچسب POS برچسبگذاری شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import BijankhanReader bijankhan = BijankhanReader(bijankhan_file='bijankhan.txt') sents = bijankhan.sents() print (next(sents))
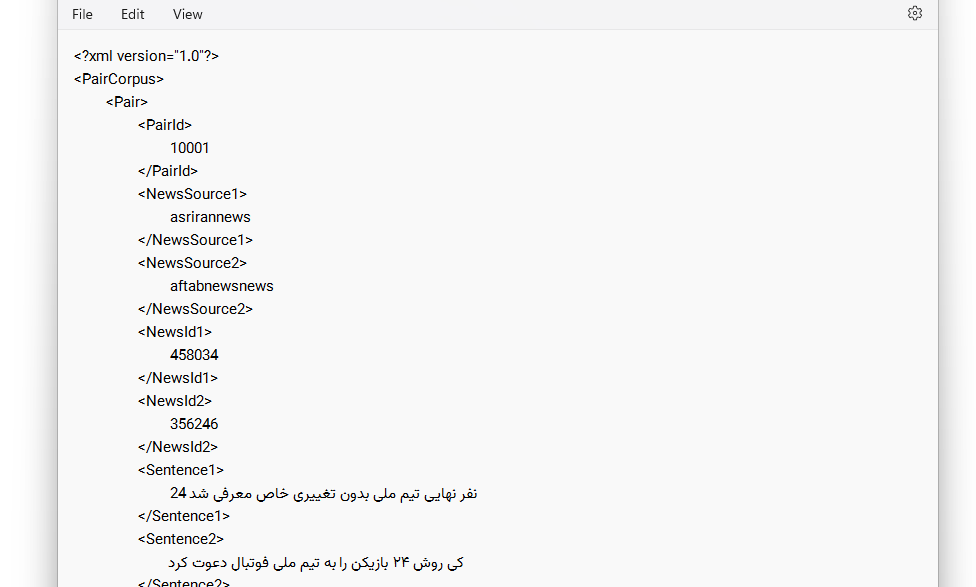
پیکرهٔ دگربیان حاوی ۱۵۲۳ نمونه است که به عنوان نمونههای دگربیان نشانهگذاری شدهاند. جملات و عبارات دگربیان، بیانی متفاوت از مفهومی یکسان هستند. دادههای این پیکره از خبرگزاریهای مختلف جمعآورده شده و در سه دستهبندی «دگربیان»، «تقریباً دگربیان» و «نامرتبط» ارائه قرار گرفته است. این دادهها با استفاده از همکاری جمعی در پیامرسان تلگرام نشانهگذاری شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import DegarbayanReader
degarbayan = DegarbayanReader(root='degarbayan')
print(next(degarbayan.pairs()))
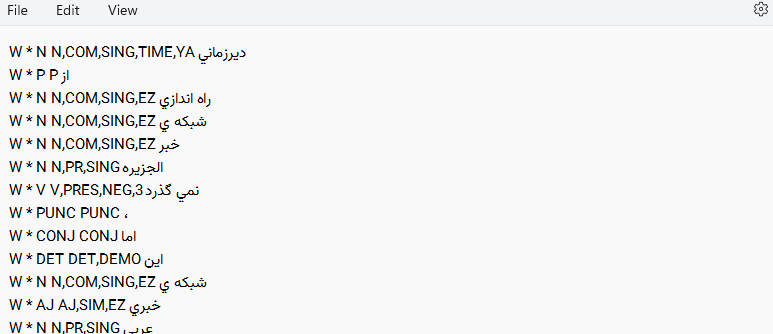
پیکرهٔ متنی زبان فارسی مجموعهای از متون نوشتاری و گفتاری رسمی زبان فارسی است که از منابع واقعی همچون روزنامهها، سایتها و مستنداتِ از قبل تایپشده، جمعآوری شده، تصحیح گردیده و برچسب خورده است. حجم این دادگان حدوداً ۱۰۰ میلیون کلمه است و از منابع مختلف تهیه گردیده و دارای تنوع بسیار زیادی است. ۱۰ میلیون کلمه از این پیکره با استفاده از ۸۸۲ برچسب نحوی-معنایی به صورت دستی توسط دانشجویان رشتهٔ زبانشناسی برچسبدهی شدهاند و هر پرونده بر حسب موضوع و منبع آن طبقهبندی شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import PeykareReader
peykare = PeykareReader(root='peykare')
print(next(peykare.sents()))
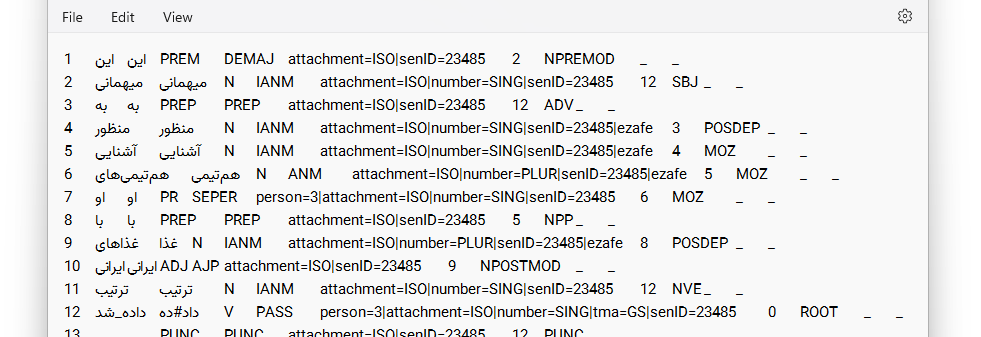
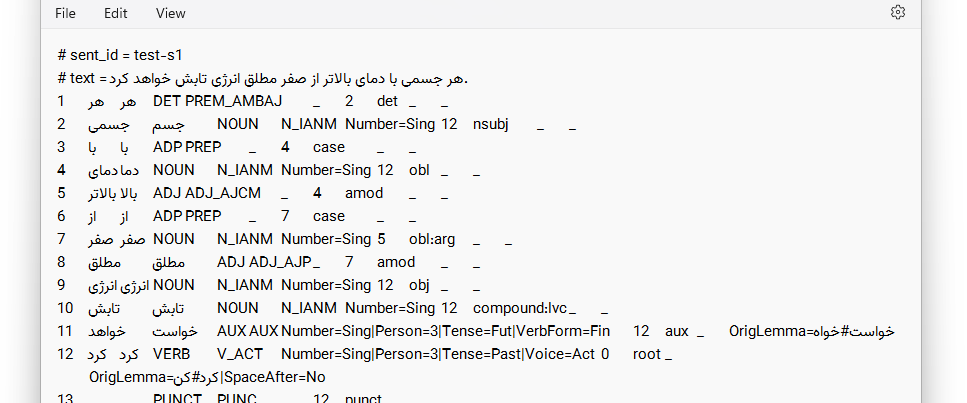
این پیکره حاوی ۳۰ هزار جمله برچسبخورده است که اطلاعات نحوی و ساختواژی را بر مبنای دستور وابستگی تهیه کرده است. جملات این پیکره از منابع مختلفی از متون فارسیِ معاصر گردآوری شده است. تمام جملات دارای برچسب روابط نحوی (بر مبنای دستور وابستگی) مثل فاعل، مفعول، مسند و همچنین برچسب اطلاعات ساختواژی مثل فعل و اسم و قید و ... است. جملات این پیکره یکبهیک توسط تیمی از زبانشناسان مجرب برچسبگذاری شده است. اخیراً نسخه یونیورسالِ این پیکره نیز تهیه شده است که از طریق لینک بالا در دسترس است. با کمک کتابخانه هضم به راحتی میتوانید این پیکره را بخوانید. در نسخه جدید هضم، امکان خواندن نسخه یونیورسال این پیکره نیز اضافه شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import DadeganReader
from hazm import UniversalDadeganReader

# Reading old conll
dadegan = DadeganReader(conll_file='dadegan.conll')
print(next(dadegan.sents()))

#Reading new universal conllu (universal tags)
universal_dadegan = UniversalDadeganReader(conll_file='dadegan.conllu') print(next(universal_dadegan.sents()))
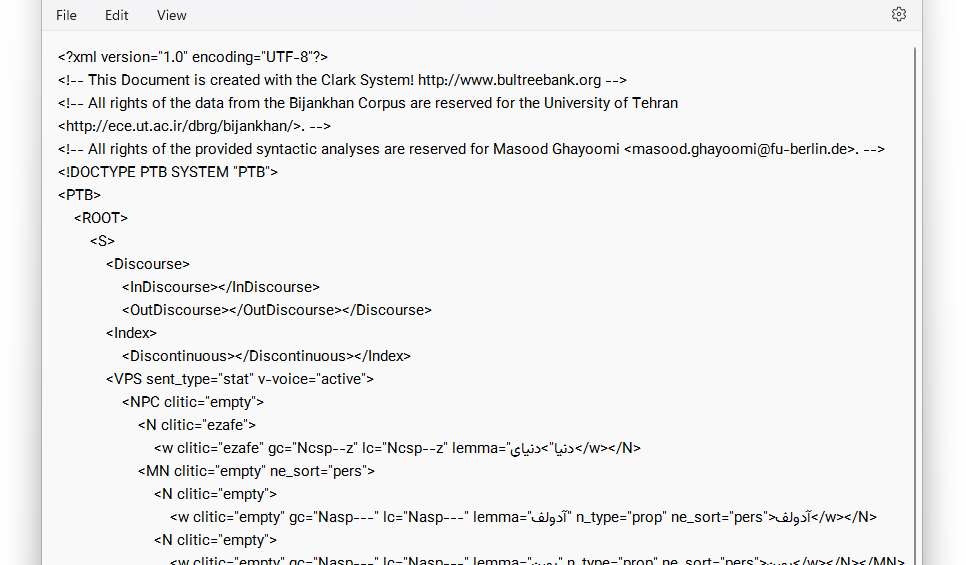
این پیکره مجموعهای از ۱۰۰۰ جملهٔ برچسبخورده با اطلاعات نحوی است و در آن روابط بین واژههای هر سازه به طور واضح و صریح مشخص شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import TreebankReader
 treebank = TreebankReader(root='treebank')
print(next(treebank.sents()))
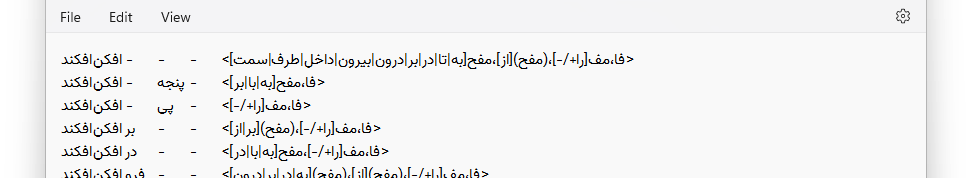
پیکره فرهنگ ظرفیت نحوی افعال فارسی، مجموعهای از اطلاعات ظرفیت نحوی بیش از ۴۵۰۰ فعل در زبان فارسی است. در این پیکره، متممهای اجباری و اختیاری انواع فعلهای ساده، مرکب، پیشوندی و عبارات فعلی مشخص شده است. فراوانی فعلهای مرکب در زبان فارسی، نیاز به فرهنگ ظرفیت فعل را در این زبان دوچندان مینماید. چرا که شناخت فعلهای مرکب چه از لحاظ انسانی و چه از لحاظ پردازشی کاری دشوارتر از شناخت فعلهای ساده است و به همین خاطر فراهم آوردن فهرستی از فعلهای زبان (که شامل فعلهای مرکب نیز میشود) به همراه ساختهای ظرفیتی افعال، کمکی شایان برای کارهای پردازشی است. از سوی دیگر، بر اساس نظریه وابستگی، ساخت بنیادین جمله را میتوان از روی ساخت ظرفیتی فعل جمله به دست آورد و به همین دلیل بر اهمیت دانستن ساختهای ظرفیتی فعل در متنهای زبانی افزوده میشود.
خواندن این پیکره با کتابخانه هضم:
from hazm import VerbValencyReader
verbvalency= VerbValencyReader(valency_file='valency.txt')
print(next(verbvalency.verbs()))
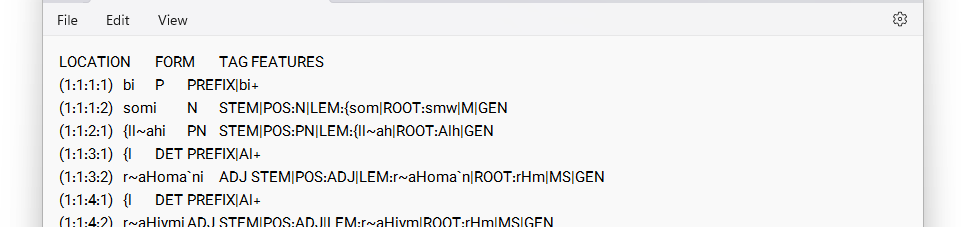
این پیکره شامل دستور، نحو و صرفشناسیِ تکتک کلمات عربی قرآن کریم است.
خواندن این پیکره با کتابخانه هضم:
from hazm import QuranReader
quran=QuranReader(quran_file='quranic_corpus_morphology.txt')
words = quran.words()
print(next(words))
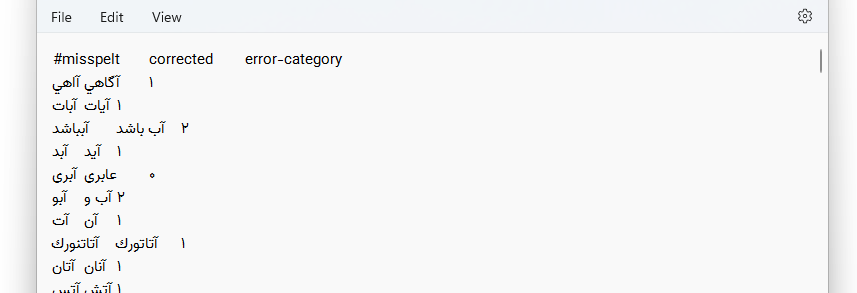
این پیکره مشتمل بر خطاهای املایی در دو گروه دادهای است. گروه اول ۵۵۰۰ خطای رایج املایی است و گروه دوم ۸۰۰ خطای معمول در سیستمهای OCR است.
خواندن این پیکره با کتابخانه هضم:
from hazm import FaSpellReader
faspell = FaSpellReader(corpus_folder='faspell')
print(next(faspell.main_entries()))
print(next(faspell.ocr_entries()))
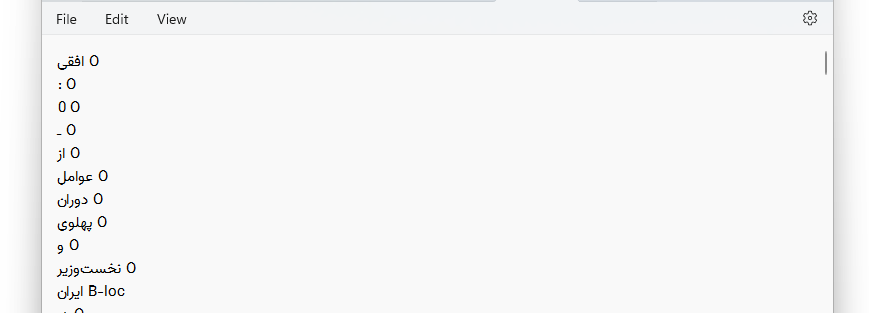
پیکره آرمان یک پیکره برای موجودیتهای نامدار است که شامل ۲۵۰,۰۱۵ توکنِ برچسبخورده در قالب ۷۶۸۲ جمله با فرمت IOB است. این کار به صورت دستی انجام شده است. توکنها در ۶ دستهبندی شخص، سازمان، مکان، امکانات، تولیدات، و رویداد، برچسبگذاری شدهاند.
خواندن این پیکره با کتابخانه هضم:
from hazm import ArmanReader
arman = ArmanReader(corpus_folder='arman', subset='test')
print(next(arman.sents()))


