
پیکره، مجموعهای از دادههای متنی یا گفتاری است که به شکل هدفمند و قانونمند در قالبهای مختلف و با اهداف گوناگون به روش دستی، ماشینی یا با ترکیبی از روشهای دستی و ماشینی توسط افراد و یا نهادهای پژوهشی جمعآوری و ساماندهی میشود.
پیکرههای زبانی کاربردهای زیادی در پردازش زبان طبیعی دارد. این دادهها تغذیه ورودی برای آموزش مدلهای زبانی برای توصیف و تحلیل زبان طبیعی است، به عنوان مثال میتوان با درک الگوهای نحوی و معنایی متن، مفاهیم پنهان در متن را فهمید. پیکرهها همچنین کاربرد وسیعی در توسعه ابزارهایی مانند سیستمهای ترجمه ماشینی، سیستمهای تشخیص گفتار و سامانههای پرسشوپاسخ دارند.
پیکرهها میتوانند در انواع و اندازههای مختلف از چند هزار کلمه تا میلیاردها کلمه، از پیکرههای متنی خام تا پیکرههای برچسبگذاریشده، از پیکرههای همهمنظوره تا پیکرههای خاصمنظوره و ... در دسترس باشند.
تهیه پیکرههای زبانی میتواند کار چالشبرانگیزی باشد. ابزارهای NLP و مدلهای زبانی برای رسیدن به دقتهای بالاتر به دادههای بیشتر نیاز دارند و افزایش اندازه پیکره میتواند ذخیرهسازی و پردازش و دسترسی به آن را دشوار کند. مشکل بعدی تنوع دادهها و پروسه زمانبر استخراج دادهها از منابع مختلف (سایتها، کتابها، مقالات، شبکههای اجتماعی و ...) است که غالباً در انواع سبکهای نوشتاری (خصوصاً در متنهای محاورهای) و با انواع ادبیات و خطاهای املایی و دستوری همراه هستند. نرمالسازی این دادهها میتواند چالشبرانگیز باشد.
هدف از این سلسلهنوشتار، معرفی اجمالی پیکرههاست. مسؤلیت استفاده از این پیکرهها بر عهده مصرفکننده است. لطفاً قبل از استفاده از یک پیکره، مجوز استفاده از آن را به دقت بخوانید. اطلاعات برخی از پیکرهها از جمله لینک صفحه و مجوز استفاده از آن به خاطر دردسترسنبودن، مشخصنبودن یا واضحنبودن ذکر نشده است. برای طولانینشدن نوشته، تصویر پیشنمایش بخشی از پیکره به صورت نمونه آمده است. لازم به ذکر است که برای شرح برخی از پیکرهها از توضیحات سایت پیکرهگان استفاده شده است.
پیکره ناب، در کاملترین نسخه، ۱۳۰ گیگابایت متن تمیزشده فارسی است که بالغ بر ۲۵۰ میلیون پاراگراف و ۱۵ میلیارد کلمه را در خود جای داده است.
پیکره ناب، خود متشکل از چند پیکره عظیم دیگر است:
خواندن این پیکره با کتابخانه هضم:
from hazm import NaabReader naab = NaabReader(corpus_ folder="naab" , subset="test") sentences = naab.sents() print(next(sentences))
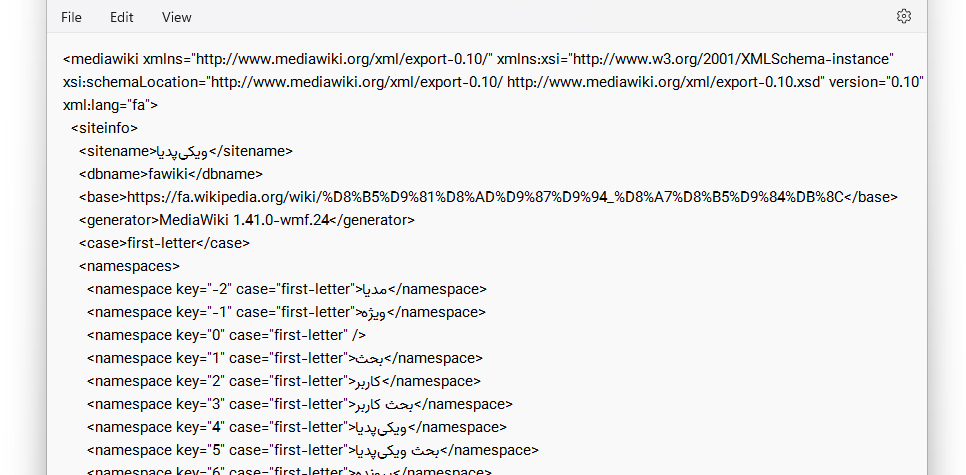
ویکیپدیا به صورت دورهای تمام اطلاعات این دانشنامه را به صورت رایگان در اختیار عموم قرار میدهد. این اطلاعات برای زبانهای مختلف (انگلیسی، فارسی و ...) و در دستهبندیهای مختلف (عناوین، متن، همراه با تصویر و ...) و در قالبهای مختلف (xml, sql, ...) در دسترس است. به عنوان مثال فایل آخرین نسخه فارسی را میتوانید از این صفحه دانلود کنید.
خواندن این پیکره با کتابخانه هضم:
from hazm import WikipediaReader
wikipedia = WikipediaReader("fawiki-latest-pages-articles.xml.bZ2")
texts = wikipedia.texts( )
print(next(texts))
پیکره میراثتکست، مجموعهای از ۲.۸ میلیون خبر از ۲۵۰ سایت خبری است که در مجموع ۱.۴ میلیارد کلمه را در خود جای داده است. برای هر خبر، اطلاعاتی چون عنوان، متن و آدرس URL خبر در دسترس است.
خواندن این پیکره با کتابخانه هضم:
from hazm import MirasTextReader
mirastext = MirasTextReader(filename="mirastext.txt")
texts = mirastext.texts()
print(next(texts))
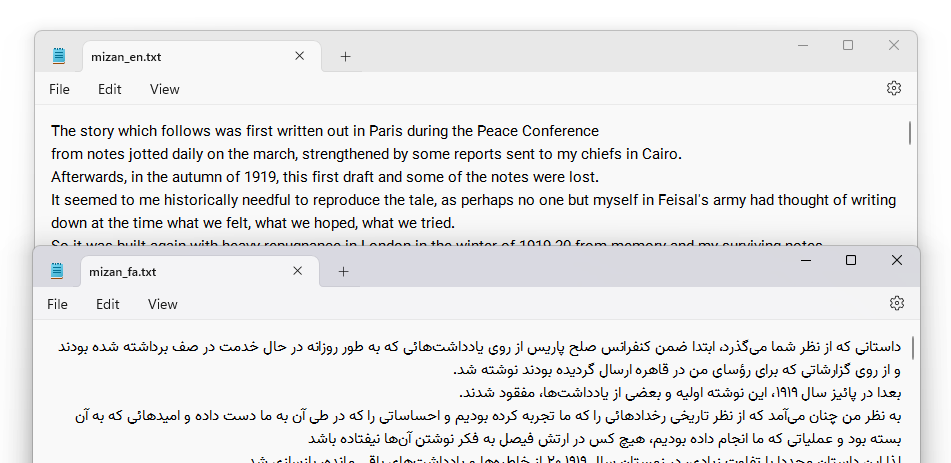
پیکره میزان یک پیکره موازی حاوی بیش از ۱ میلیون جمله انگلیسی (غالباً در حوزه ادبیات کلاسیک) و ترجمه فارسی آنهاست.
خواندن این پیکره با کتابخانه هضم:
from hazm import MizanReader
mizan = MizanReader(corpus_folder="mizan")
en_sents = mizan.english_sentences()
print(next(en_sents))
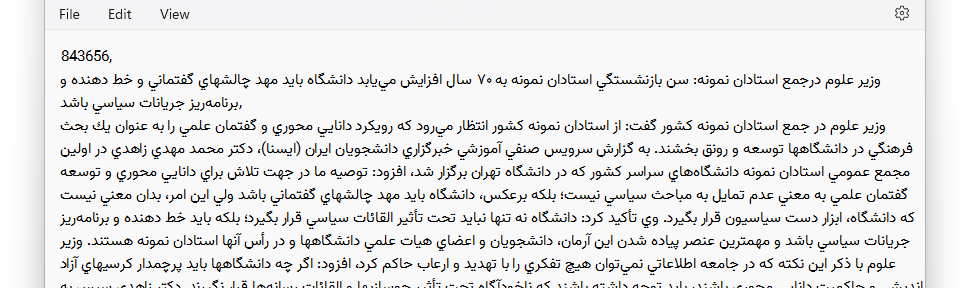
پیکرهٔ پرسیکا حاوی خبرهای برگرفته از خبرگزاری ایسنا در یازده دستهٔ ورزشی، اقتصادی، فرهنگی، مذهبی، تاریخی، سیاسی، علمی، اجتماعی، آموزشی، حقوق قضایی و بهداشت است.
خواندن این پیکره با کتابخانه هضم:
from hazm import PersicaReader
persica = PersicaReader("persica.csv")
print(next(persica.texts())
پیکره تینیوز مجموعهای از اخبار فارسی است.
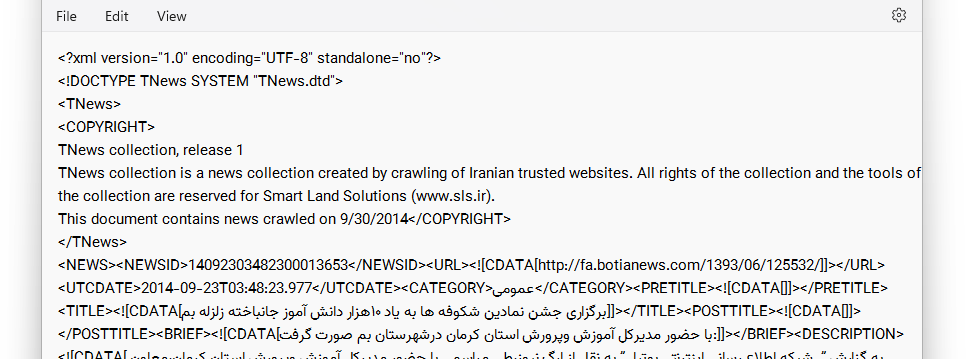
خواندن این پیکره با کتابخانه هضم:
from hazm import TNewsReader
tnews = TNewsReader(root='tnews')
print(next(tnews.texts()))
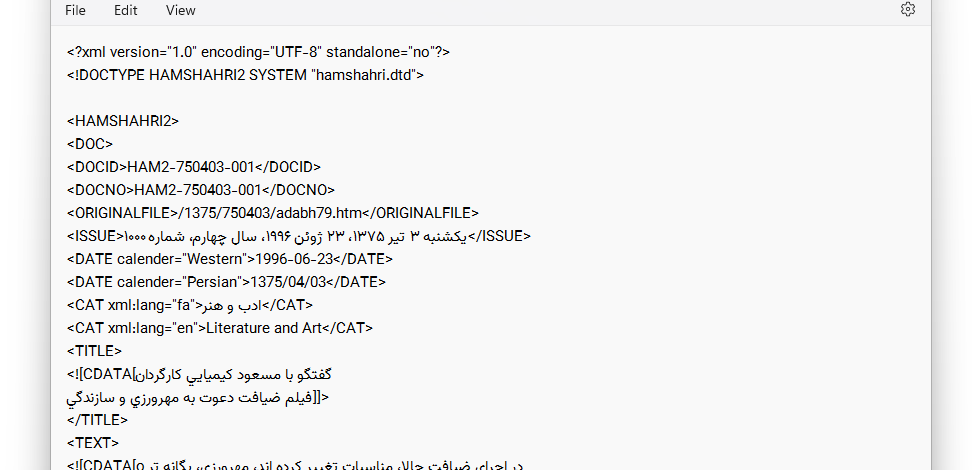
پیکره همشهری حاوی ۳۱۸ هزار خبر از روزنامه همشهری در فاصله سالهای ۱۳۷۵ تا ۱۳۸۶ است که هر خبر با برچسبهای Cat در ردهبندیهای موضوعی مختلف قرار گرفته است.
خواندن این پیکره با کتابخانه هضم:
from hazm import HamshahriReader
hamshahri = HamshahriReader(root="hamshahri")
next(hamshahri.texts())
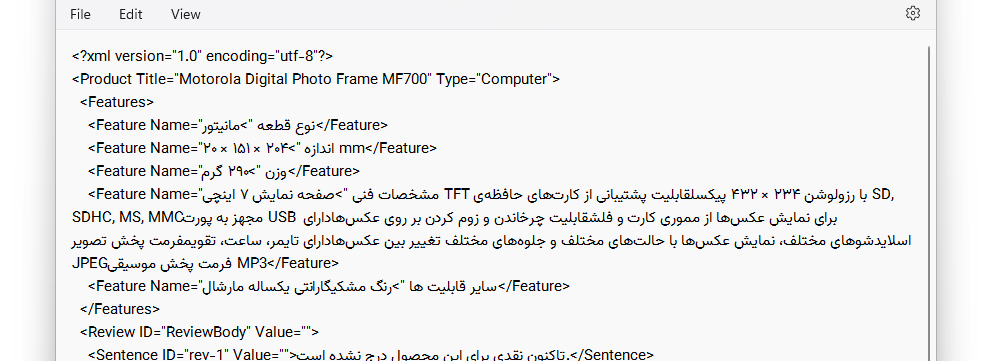
پیکره سِنتیپرس شامل مجموعهای از متون فارسی با برچسبهای معنایی است. این متنها غالباً از وبسایت دیجیکالا استخراج شده و پس از دستهبندی در قالب اسناد و جملات، توسط گروهی از دانشجویان مهندسی کامپیوتر دانشگاه گیلان به صورت دستی برچسبگذاری شده است.
خواندن این پیکره با کتابخانه هضم:
from hazm import SentiPersReader
sentipers = SentiPersReader(root="sentipers")
print(next(sentipers.comments()))
منتظر بخش بعدی این مقاله باشید.


