
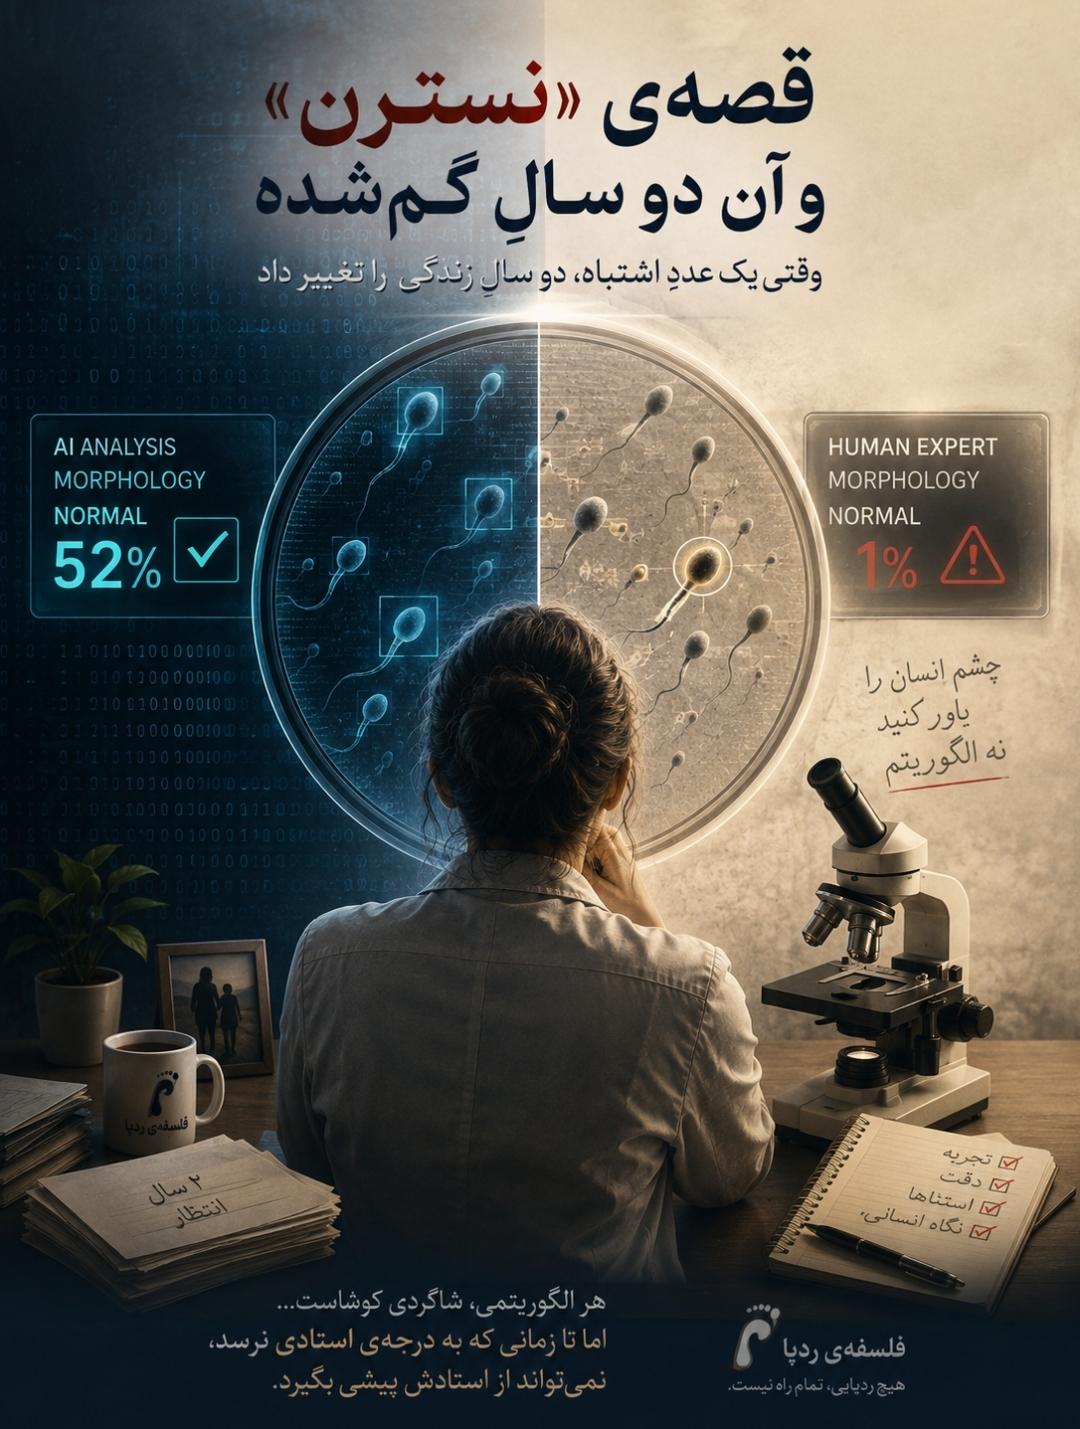
نسترن، مدیرِ یک فرومِ تخصصیِ ناباروری بود.
برای بیش از ده سال، روزانه با صدها پیام، سؤال و تجربهی مختلف روبهرو میشد؛ زنانی که بعد از ماهها انتظار، اولین برگهی آزمایش را در دست گرفته بودند، مردانی که عددهای روی کاغذ برایشان تبدیل به امید یا ناامیدی میشد، و پزشکانی که هر کدام، از زاویهای متفاوت، به همین عددها نگاه میکردند.
اما یک نکته، سالها بود که ذهن نسترن را درگیر کرده بود:
چرا گاهی یک نتیجه، با روشِ اندازهگیری تغییر میکند؟
و مهمتر از آن:
وقتی چیزی را نمیشناسیم، آیا نبودنش در دادهها، به معنای نبودنش در واقعیت است؟
دو سال پیش از اینکه به طور جدی وارد پروسهی درمان ناباروری شوند، همسر نسترن، مثل خیلی از مردهای دیگر، برای بررسی اولیه، نمونهای به آزمایشگاه داد.
برگهی نتیجه، با خطی درشت اعلام کرد:
«مورفولوژی طبیعی: ۵۲٪»
پزشک گفت:
— «مشکل از شما نیست. وضعیت خوبی دارید.»
دو سال گذشت.
درمانهای هورمونی، داروهای تحریک تخمک و چرخههای بینتیجه.
نسترن هر ماه با امید به سونوگرافی میرفت و بار دیگر، با ناامیدی برمیگشت.
تا اینکه در یکی از جلسات مشاوره، متخصصی جدید، با دیدن برگهی آزمایش و روش انجام تست، مکث کرد.
بعد بهآرامی گفت:
— «این عدد را باور ندارم. اجازه دهید تست مجدد با روش دیگری انجام شود.»
دو روز بعد، نتیجهی جدید روی میز نسترن نشست:
«مورفولوژی طبیعی: ۱٪»
نه ۵۲٪.
۱٪.
دو سالِ درمان، دو سالِ انتظار و دو سال امید، حالا زیر سؤال رفته بود.
همهچیز از یک عدد شروع شده بود.
اما شاید مشکل، خودِ عدد نبود.
شاید مشکل این بود که چیزی که عدد اندازه میگرفت، تمام واقعیت نبود.
نسترن، با مدیریت فروم، بهمرور با نمونههای مشابهی روبهرو شد.
زنانی که برگههای آزمایششان را میفرستادند و میپرسیدند:
«مورفولوژی نرمال ۴۵٪ است، اما تشخیص ناباروری بدون علت داده شده. یعنی چه؟»
و اولین سؤال نسترن معمولاً این بود:
«آزمایش اسپرم را در مراکز ناباروری انجام دادهاید؟»
اغلب جواب:
«نه.»
نسترن بهمرور متوجه یک نکتهی مهم شد:
هر عددی که یک سیستم تولید میکند، الزاماً تمام واقعیت را توصیف نمیکند.
چرا؟
چون هر سیستم تشخیصی، چه انسانی و چه الگوریتمی، با یک چارچوب مشخص کار میکند.
الگوریتم چیزی را از «هیچ» یاد نمیگیرد.
کسی باید نمونهها را به او نشان داده باشد.
کسی باید به او گفته باشد:
این طبیعی است.
این غیرطبیعی است.
این شکل، این ویژگی، این الگو، متعلق به کدام دسته است.
حالا فرض کنید در تمام جهان، یک میلیون نمونه وجود داشته باشد؛ اما الگوریتم فقط از صد نمونه برای یادگیری استفاده کرده باشد.
آن صد نمونه، تمام جهان نیستند.
اما الگوریتم، جهانِ خودش را بر اساس همان صد نمونه میسازد.
و حالا اگر نمونهی صد و یکم، شکلی داشته باشد که در آن صد نمونه وجود نداشته است چه؟
اگر ناهنجاریای وجود داشته باشد که هیچکس آن را به الگوریتم نشان نداده باشد؟
الگوریتم چه میکند؟
آن را با نزدیکترین چیزی که میشناسد مقایسه میکند.
و ممکن است بگوید:
«طبیعی.»
نه چون واقعاً طبیعی است.
بلکه چون در جهانِ دادههای خودش، چیزی بهتر از آن برای نامگذاری ندارد.
این شاید یکی از خطرناکترین خطاها در هر سیستم یادگیری باشد:
ما گاهی فراموش میکنیم که الگوریتم، واقعیت را نمیبیند.
الگویِ واقعیتی را میبیند که به او نشان دادهایم.
اگر تمام اسپرمهای جهان را یک میلیون نمونه فرض کنیم و فقط صد نمونه برای آموزش برچسبگذاری شده باشند، الگوریتم با همان صد نمونه، ۹۹۹٬۹۰۰ نمونهی دیگر را بررسی میکند.
اما آن ۹۹۹٬۹۰۰ نمونه، الزاماً در یکی از دستهبندیهای همان صد نمونه قرار نمیگیرند.
ممکن است در میانشان شکلهایی وجود داشته باشد که هنوز ندیدهایم.
استثناهایی که هنوز نامگذاری نشدهاند.
الگوهایی که هنوز کشف نشدهاند.
و اینجاست که یک سیستم میتواند با اطمینان بگوید:
«این طبیعی است.»
در حالی که واقعیت شاید فقط این باشد:
«من چیز دیگری شبیه این ندیدهام.»
این دو جمله، یکی نیستند.
اینجا شاید بد نباشد یک سوءتفاهم را هم کنار بگذاریم.
من نمیخواهم بگویم:
انسان خوب است و ماشین بد.
اتفاقاً برعکس.
ماشین میتواند در کارهای تکراری، سریعتر، دقیقتر و خستگیناپذیرتر از انسان باشد.
میتواند میلیونها داده را بررسی کند؛ چیزی که از توان یک انسان خارج است.
اما یک تفاوت مهم وجود دارد.
الگوریتم، در نقطهی شروع، شاگرد است.
او با ردپاهایی که استادان پیش از او گذاشتهاند، راه رفتن را یاد میگیرد.
اگر صد نمونه به او آموزش داده باشیم، ردپای همان صد نمونه را میشناسد.
اما جهان، فقط همان صد نمونه نیست.
پس یک الگوریتمِ خوب، نباید برای همیشه شاگرد بماند.
باید بتواند از تجربههای جدید یاد بگیرد.
خطاهای خودش را بشناسد.
استثناها را کشف کند.
و مهمتر از همه:
وقتی چیزی با آنچه آموخته سازگار نیست، بهجای اینکه آن را مجبور به قرار گرفتن در یکی از دستههای قدیمی کند، بگوید:
«این را نمیشناسم.»
شاید بلوغ واقعی یک هوش مصنوعی، نه زمانی باشد که پاسخِ بیشتری دارد؛
بلکه زمانی که به اندازهی کافی هوشمند شده باشد که نداند.
و شاید روزی برسد که شاگرد، نه فقط از استادش یاد بگیرد،
بلکه خودش ردپاهای تازهای پیدا کند و به استادش نشان دهد.
آن روز، دیگر با یک «شاگردِ کوشا» طرف نیستیم.
با استادی روبهرو هستیم که خودش بخشی از ناشناختهها را کشف کرده است.
نسترن، حالا هر بار برگهی آزمایشی را میدید که با یک عددِ خوشبینانه چیزی را «طبیعی» اعلام کرده بود، به آن دو سالِ گمشده فکر میکرد.
به داروهایی که مصرف شد.
به چرخههایی که بیثمر گذشت.
به امیدهایی که روی یک عدد بنا شده بود.
و شاید بیشتر از همه، به این فکر میکرد که:
چقدر از چیزهایی که امروز «طبیعی» مینامیم، واقعاً طبیعیاند؛ و چقدرشان فقط هنوز استثنای شناختهشدهای ندارند؟
تکنولوژی دشمن انسان نیست.
اتفاقاً میتواند یکی از قدرتمندترین ابزارهای انسان باشد.
اما نباید فراموش کنیم:
هر الگوریتمی، حاصلِ ردپاهاییست که پیش از آن وجود داشتهاند.
و اگر ردپاهای ما ناقص باشند، ممکن است ماشین با دقتی شگفتانگیز، همان ناقص بودن را میلیونها بار تکرار کند.
پس شاید مسئله این نباشد که:
«انسان را انتخاب کنیم یا ماشین را؟»
مسئله این است که یاد بگیریم:
کجا به ماشین اعتماد کنیم، کجا به انسان برگردیم، و کجا شجاعتِ گفتنِ «نمیدانم» را داشته باشیم.
این قصه، روایتی خیالی با الهام از تجربههای واقعی است.
هدفش ردِ تکنولوژی نیست.
اتفاقاً میخواهد به یک نکتهی ظریفتر اشاره کند:
هوش مصنوعی میتواند از گذشته بیاموزد، الگوها را پیدا کند و حتی چیزهایی را ببیند که چشم انسان از دیدنشان ناتوان است.
اما آینده، همیشه عینِ گذشته نیست.
گاهی یک استثنا، اولین ردپایِ یک حقیقتِ تازه است.
و اگر الگوریتم آن را فقط به این دلیل که در هیچکدام از الگوهای قبلی نمیگنجد «خطا» یا «طبیعی» اعلام کند،
ممکن است ما نه با مشکلِ ناتوانیِ ماشین،
بلکه با مشکلِ کامل نبودنِ ردپاهایی که برای آموزش به آن دادهایم روبهرو باشیم.
و شاید فلسفهی ردپا، دقیقاً از همینجا شروع میشود:
هیچ ردپایی، تمامِ راه نیست.

