
منتشرشده در: towardsdatascience به تاریخ 21 نوامبر 2020
لینک منبع: All Machine Learning Algorithms You Should Know in 2021
همانطور که دانش من در یادگیری ماشینی بالا میرود، تعداد الگوریتم های یادگیری ماشین نیز افزایش مییابد! این مقاله الگوریتمهای یادگیری ماشین را پوشش خواهد داد که معمولا در جامعه علوم داده استفاده میشوند.
به یاد داشته باشید که من برخی از الگوریتمها بیش از حد ساده توضیح خواهم داد، زیرا اگر همه الگوریتمها را به طور کامل توضیح دهم، این مقاله به اندازه یک کتاب خواهد بود! همچنین قصد دارم سعی کنم میزان ریاضیات در این مقاله را به حداقل برسانم، چون میدانم که این میتواند برای کسانی که از لحاظ ریاضی قوی نیستند، بسیار دلهرهآور باشد. در عوض، من سعی میکنم یک خلاصه مختصر از هر کدام ارائه دهم و برخی از ویژگیهای کلیدی را ذکر کنم.
با در نظر گرفتن این موضوع، من میخواهم با برخی از الگوریتمهای اساسیتر شروع کنم و سپس به سراغ الگوریتمهای جدیدتر مانند CatBoost, Gradient Boost، و XGBoost بروم.
رگرسیون خطی یکی از اساسیترین الگوریتم هایی است که برای مدلسازی روابط بین یک متغیر وابسته و یک یا چند متغیر مستقل به کار میرود. به عبارت سادهتر، شامل پیدا کردن «خط بهترین تناسب» است که دو یا چند متغیر را نشان میدهد.
خط بهترین تناسب با به حداقل رساندن مربع فاصله بین نقاط و خط بهترین تناسب پیدا میشود - این به عنوان به حداقل رساندن مجموع مربع باقیماندهها شناخته میشود. یک باقیمانده به سادگی برابر است با مقدار پیشبینیشده منهای مقدار واقعی.
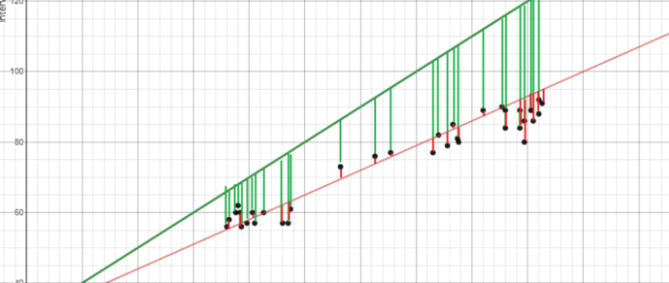
در صورتی که هنوز منطقی به نظر نمیرسد، تصویر بالا را در نظر بگیرید. با مقایسه خط سبز بهترین تناسب با خط قرمز، توجه کنید که چطور خطوط عمودی (باقیماندهها) برای خط سبز بسیار بزرگتر از خط قرمز هستند. این منطقی به نظر میرسد، زیرا خط سبز آنقدر از نقاط دور است که نمایش خوبی از دادهها نیست!
اگر میخواهید در مورد ریاضیات رگرسیون خطی بیشتر بدانید، شروع میکنیم:
کلاس = "ei jw" rel="noopener nofollow"> از توضیح بریلیانت پیروی نمیکند.
رگرسیون منطقی مشابه رگرسیون خطی است اما برای مدل کردن احتمال یک تعداد گسسته از نتایج به طور معمول دو مورد استفاده قرار میکند. در یک نگاه، رگرسیون لجستیک بسیار پیچیدهتر از رگرسیون خطی به نظر میرسد، اما در واقع تنها یک گام اضافی دارد.
اول، یک امتیاز را با استفاده از یک معادله مشابه با معادله برای خط بهترین برازش برای رگرسیون خطی محاسبه میکنید.
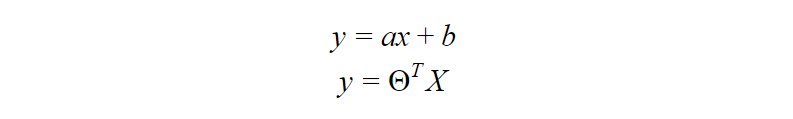
مرحله اضافی، دادن امتیازی است که قبلا در تابع سیگموئید زیر محاسبه کردهاید به طوری که احتمال بازگشت را به دست آورید. سپس این احتمال میتواند به یک خروجی باینری، ۱ یا ۰، تبدیل شود.
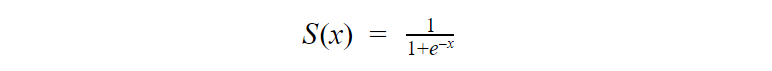
برای یافتن وزنهای معادله اولیه برای محاسبه امتیاز از روشهایی مانند کاهش گرادیان یا حداکثر احتمال استفاده میشود. از آنجا که این مباحث فراتر از محدوده این مقاله است، من به جزئیات بیشتری از آن نخواهم پرداخت، اما اکنون شما میدانید چطور کار میکند!
شاید به مطالعه مقاله ویژگی مشترک در میان استارتاپهای موفق هوش مصنوعی علاقمند باشید.
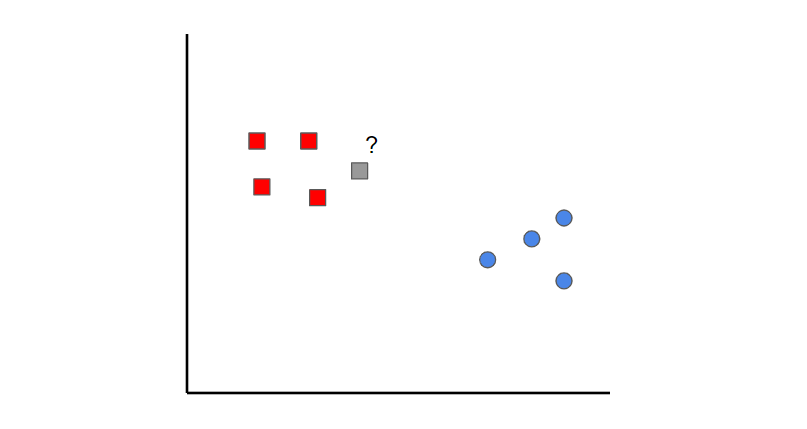
الگوریتم k-نزدیکترین همسایهها یک ایده ساده است. اول، شما با دادههایی شروع میکنید که از قبل طبقهبندی شدهاند (یعنی نقاط داده قرمز و آبی). سپس زمانی که شما یک نقطه داده جدید اضافه میکنید، آن را با نگاه کردن به نزدیکترین نقاط طبقهبندیشده، طبقهبندی میکنید. هر کدام از ردهها که بیشترین آرا را به دست آورند، تعیین میکنند که امتیاز جدید به چه عنوان طبقهبندی میشود.
در این مورد، اگر k = ۱ را تنظیم کنیم، میتوانیم ببینیم که اولین نقطه نزدیک به نمونه خاکستری یک نقطه داده قرمز است. بنابراین، نقطه به عنوان قرمز طبقهبندی میشود.
چیزی که باید به خاطر داشته باشید این است که اگر مقدار k خیلی کم تنظیم شود، میتواند در معرض دادههای پرت قرار گیرد. از سوی دیگر، اگر مقدار k بیش از حد بالا باشد، ممکن است کلاسهایی با تنها چند نمونه را نادیده بگیرد.
نایو بیز یک الگوریتم طبقهبندی است. این بدان معنی است که بیز ساده زمانی استفاده میشود که متغیر خروجی گسسته باشد.
الگوریتم ساده بیز میتواند مانند یک الگوریتم ترسناک به نظر برسد، زیرا به دانش اولیه ریاضی در احتمال شرطی و قضیه بیز نیاز دارد، اما این یک مفهوم بسیار ساده و «سادهلوحانه» است- در زبان انگلیسی naive به معنای ساده لوح می باشد- که من تمام تلاش خود را برای توضیح آن با یک مثال انجام خواهم داد:
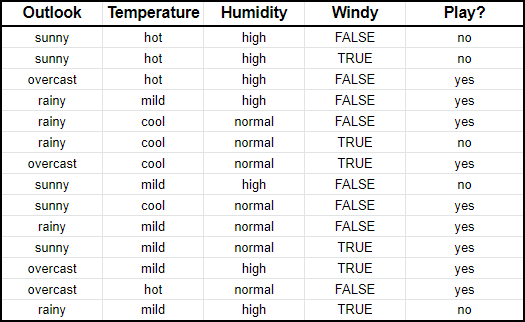
فرض کنید ما دادههای ورودی در مورد ویژگیهای آب و هوا (چشمانداز، دما، رطوبت، باد) و اینکه آیا شما گلف بازی میکنید یا نه (به عنوان مثال ستون آخر) را داشته باشیم.
آنچه نایو بایز انجام میدهد، مقایسه نسبت بین هر متغیر ورودی و دستهها در متغیر خروجی است. این را میتوان در جدول زیر نشان داد.
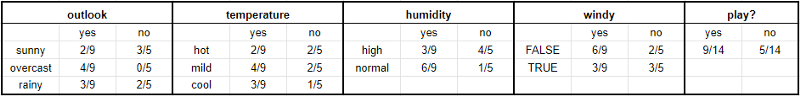
به عنوان مثال برای اینکه به شما کمک کنم این را بخوانید، در بخش دما، از نه روزی که گلف بازی کردید، دو روز گرم بود (به عنوان مثال، بله).
به بیان ریاضی، شما میتوانید این را به عنوان احتمال گرم بودن هوا در بازی گلف بنویسید. نماد ریاضی P (گرم | بله) است. این به عنوان احتمال شرطی شناخته میشود و برای درک بقیه چیزهایی که میخواهم بگویم ضروری است.
زمانی که این کار را کردید، میتوانید پیشبینی کنید که آیا گلف بازی خواهید کرد یا نه.
تصور کنید که ما روز جدیدی با ویژگیهای زیر داریم:
اول، احتمال اینکه با توجه به X، P (بله | X) گلف بازی کنید را محاسبه میکنیم و سپس احتمال اینکه با توجه به X، P (نه | X) گلف بازی نکنید را محاسبه میکنیم.
با استفاده از نمودار بالا، میتوانیم اطلاعات زیر را به دست آوریم:
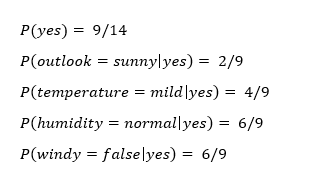
حال میتوانیم به سادگی این اطلاعات را در فرمول زیر وارد کنیم:
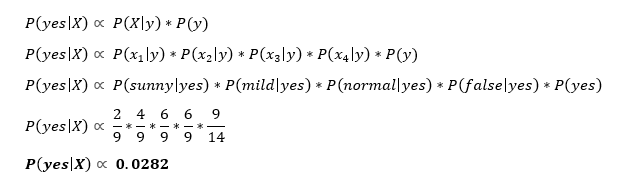
به طور مشابه، شما همان توالی مراحل را برای P (نه | X) کامل خواهید کرد.

از زمانی که P (بله | X) P (نه | X) است، میتوانید پیشبینی کنید که این فرد گلف بازی خواهد کرد با توجه به این که چشمانداز آن آفتابی است، دما ملایم است، رطوبت نرمال است و باد نیست.
این ذات نایو بایز است!
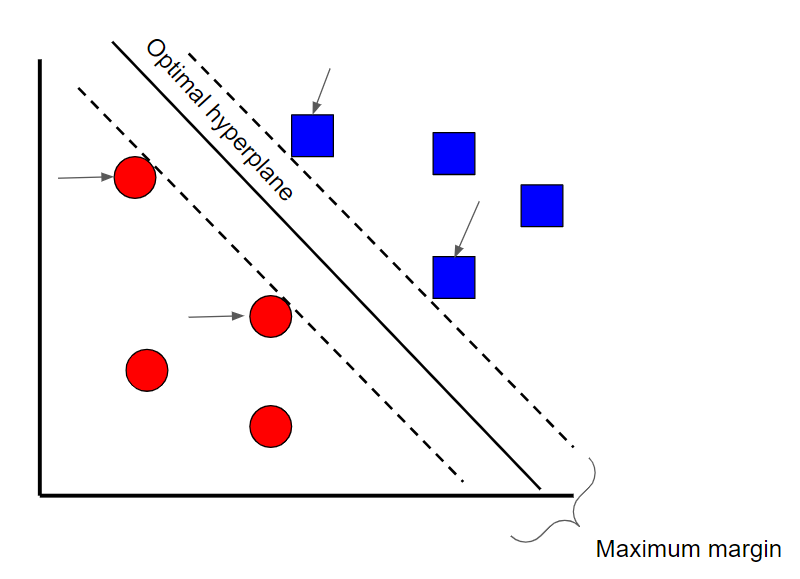
ماشین بردار پشتیبان یک تکنیک طبقهبندی نظارت شده است که در واقع میتواند بسیار پیچیده باشد اما در اساسیترین سطح کاملا بصری است. به خاطر این مقاله، ما آن را در سطح بالایی نگه میداریم.
بیایید فرض کنیم که دو دسته داده وجود دارد. ماشین بردار پشتیبان یک ابرصفحه یا مرز بین دو کلاس از دادهها را پیدا خواهد کرد که حاشیه بین دو کلاس را به حداکثر میرساند (بالا را ببینید). صفحات زیادی وجود دارند که میتوانند دو کلاس را از هم جدا کنند، اما تنها یک کلاس میتواند حاشیه یا فاصله بین کلاسها را حداکثر کند.
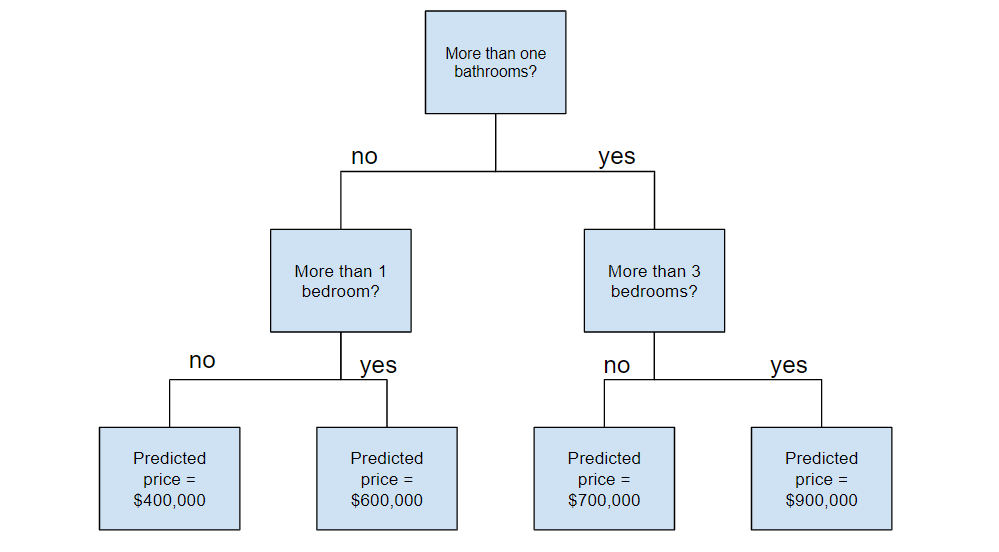
قبل از درک جنگلهای تصادفی، چند عبارت وجود دارند که باید آنها را بدانید:
حالا که این اصطلاحات را فهمیدید، بیایید به آن بپردازیم.
جنگلهای تصادفی یک تکنیک یادگیری گروهی هستند که از درختان تصمیمگیری ساخته میشوند. جنگلهای تصادفی شامل ایجاد چندین درخت تصمیمگیری با استفاده از مجموعه دادههای خود راهاندازی شده از دادههای اصلی و انتخاب تصادفی زیرمجموعهای از متغیرها در هر مرحله از درخت تصمیمگیری است. سپس این مدل حالت تمام پیشبینیهای هر درخت تصمیم (برچسب زدن) را انتخاب میکند. هدف از این کار چیست؟ با تکیهبر مدل «اکثریت برنده»، خطر خطا از یک درخت را کاهش میدهد.
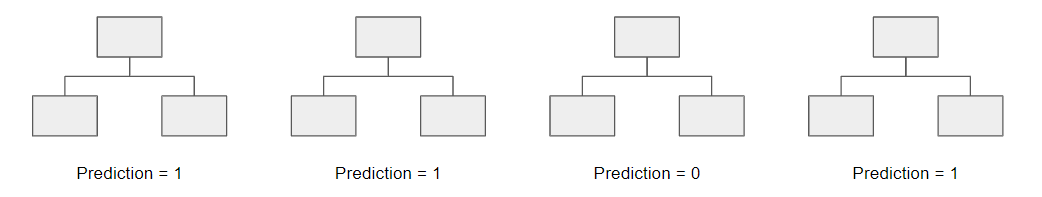
برای مثال، اگر ما یک درخت تصمیم را ایجاد کنیم، درخت سوم، آن را پیشبینی میکند، اما اگر ما به حالت هر ۴ درخت تصمیم تکیه کنیم، مقدار پیشبینیشده ۱ خواهد بود، این قدرت جنگلهای تصادفی است!
مطالعه مقاله شبکه عصبی کانولوشن چیست؟ آموزش مبتدی برای یادگیری ماشینی و یادگیری عمیق توصیه میشود.
آدابوست، یا بوست انطباقی، همچنین یک الگوریتم ترکیبی است که از روشهای تاخیری و تقویت برای توسعه یک پیشبینیکننده ارتقا یافته، استفاده میکند.
الگوریتم AdaBoost مشابه جنگلهای تصادفی است به این معنا که پیشبینیها از درختان تصمیمگیری زیادی گرفته میشوند. با این حال، سه تفاوت اصلی وجود دارد که آدابوست را منحصر به فرد میسازد:
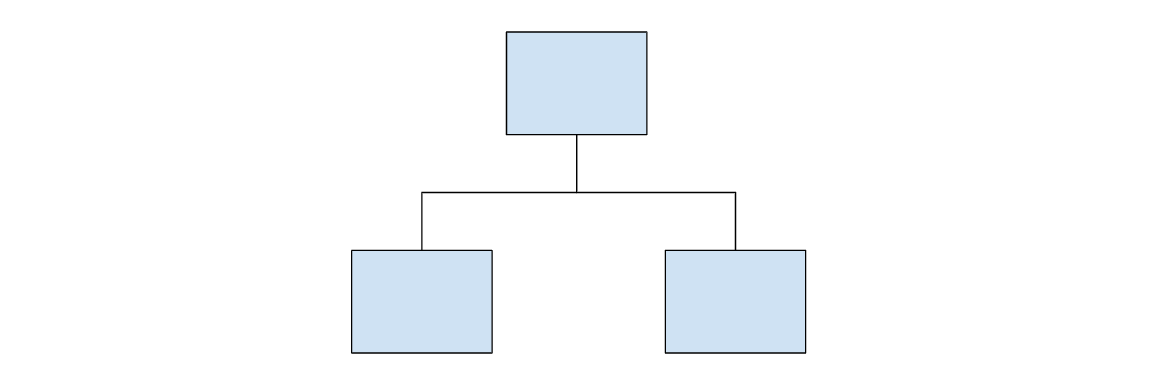
اول از همه، AdaBoost به جای درخت جنگلی از درختان کندهشده ایجاد میشود. استامپ درختی است که فقط از یکگره و دو برگ تشکیل شدهاست (مانند تصویر بالا).
در اصل، آدابوست رویکرد تکراریتری را اتخاذ میکند به این معنا که به دنبال بهبود تکرار پذیری از اشتباهاتی است که استامپ قبلی مرتکب شدهاست.
اگر میخواهید بیشتر در مورد ریاضیات زیربنایی پشت AdaBoost بدانید، مقاله من با عنوان «توضیح ریاضی AdaBoost در ۵ دقیقه» را بررسی کنید.
جای تعجب نیست که Gradient Boost نیز یک الگوریتم ترکیبی است که از روشهای تقویت برای توسعه یک پیشبینیکننده پیشرفته استفاده میکند. از بسیاری جهات، Gradient Boost شبیه AdaBoost است، اما چند تفاوت کلیدی وجود دارد:
در حالی که نکته آخر ممکن است گیجکننده بوده باشد، تمام چیزی که شما باید بدانید این است که بوست گرادیان با ساختن یک درخت برای تلاش برای متناسب کردن دادهها شروع به کار میکند، و درختان بعدی با هدف کاهش باقیماندهها (خطا) ساخته میشوند. این کار را با تمرکز بر مناطقی انجام میدهد که یادگیرندگان موجود عملکرد ضعیفی دارند، شبیه به آدابوست.
الگوریتم XGBoost امروزه یکی از محبوبترین و پرکاربردترین الگوریتم هاست زیرا بسیار قدرتمند است. XGBoost شبیه به برج مراقبت است اما چند ویژگی دیگر دارد که آن را بسیار قویتر میکند از جمله:
من به شدت توصیه میکنم که برای درک نحوه عملکرد الگوریتم با جزئیات بیشتر، ویدئوی استیسکوست را تماشا کنید.
اگر فکر میکردید که XGBoost بهترین الگوریتم است، دوباره فکر کنید. لایلت GBM نوع دیگری از الگوریتم تقویت است که نشان دادهاست سریعتر و گاهی اوقات دقیقتر از XGBoost است.
چیزی که باعث میشود لایلت GBM متفاوت شود این است که از یک تکنیک منحصر به فرد به نام نمونهبرداری یک طرفه مبتنی بر گرادیان (GOSS) برای فیلتر کردن نمونههای داده برای پیدا کردن یک مقدار تقسیم استفاده میکند. این متفاوت از XGBoost است که از الگوریتم های از پیش مرتب شده و مبتنی بر هیستوگرام برای یافتن بهترین تقسیم استفاده میکند.
ممکن است مطالعه مقاله ۲۱ توصیه و نکته برای دانشمندان داده در سال ۲۰۲۱ برای شما مفید باشد.
الگوریتم CatBoost الگوریتم دیگری است که بر پایه گئورنت دسنت بنا شدهاست و تفاوتهای ظریفی دارد که آن را منحصر به فرد میسازد:
به طور کلی، چیزی که باعث میشود CatBoost بسیار قدرتمند شود، الزامات لاتنسی (پوشش دهی) پایین آن است که به این معنی است که حدود هشت برابر سریعتر از XGBoost است.
اگر ان مقاله را تا انتها ادامه دادید، تبریک میگویم! حالا باید ایده بهتری از تمام الگوریتمهای مختلف یادگیری ماشینی داشته باشید.
اگر درک چند الگوریتم آخر سختتر بود، دلسرد نشوید-نه تنها آنها پیچیدهتر هستند، بلکه نسبتا جدید نیز هستند! بنابراین منتظر منابع بیشتری که به این الگوریتمها وارد میشوند و عمیقتر هستند، باشید.
این متن با استفاده از ربات ترجمه مقاله علم داده ترجمه شده و به صورت محدود مورد بازبینی انسانی قرار گرفته است.در نتیجه میتواند دارای برخی اشکالات ترجمه باشد.
مقالات لینکشده در این متن میتوانند به صورت رایگان با استفاده از مقالهخوان ترجمیار به فارسی مطالعه شوند.

