
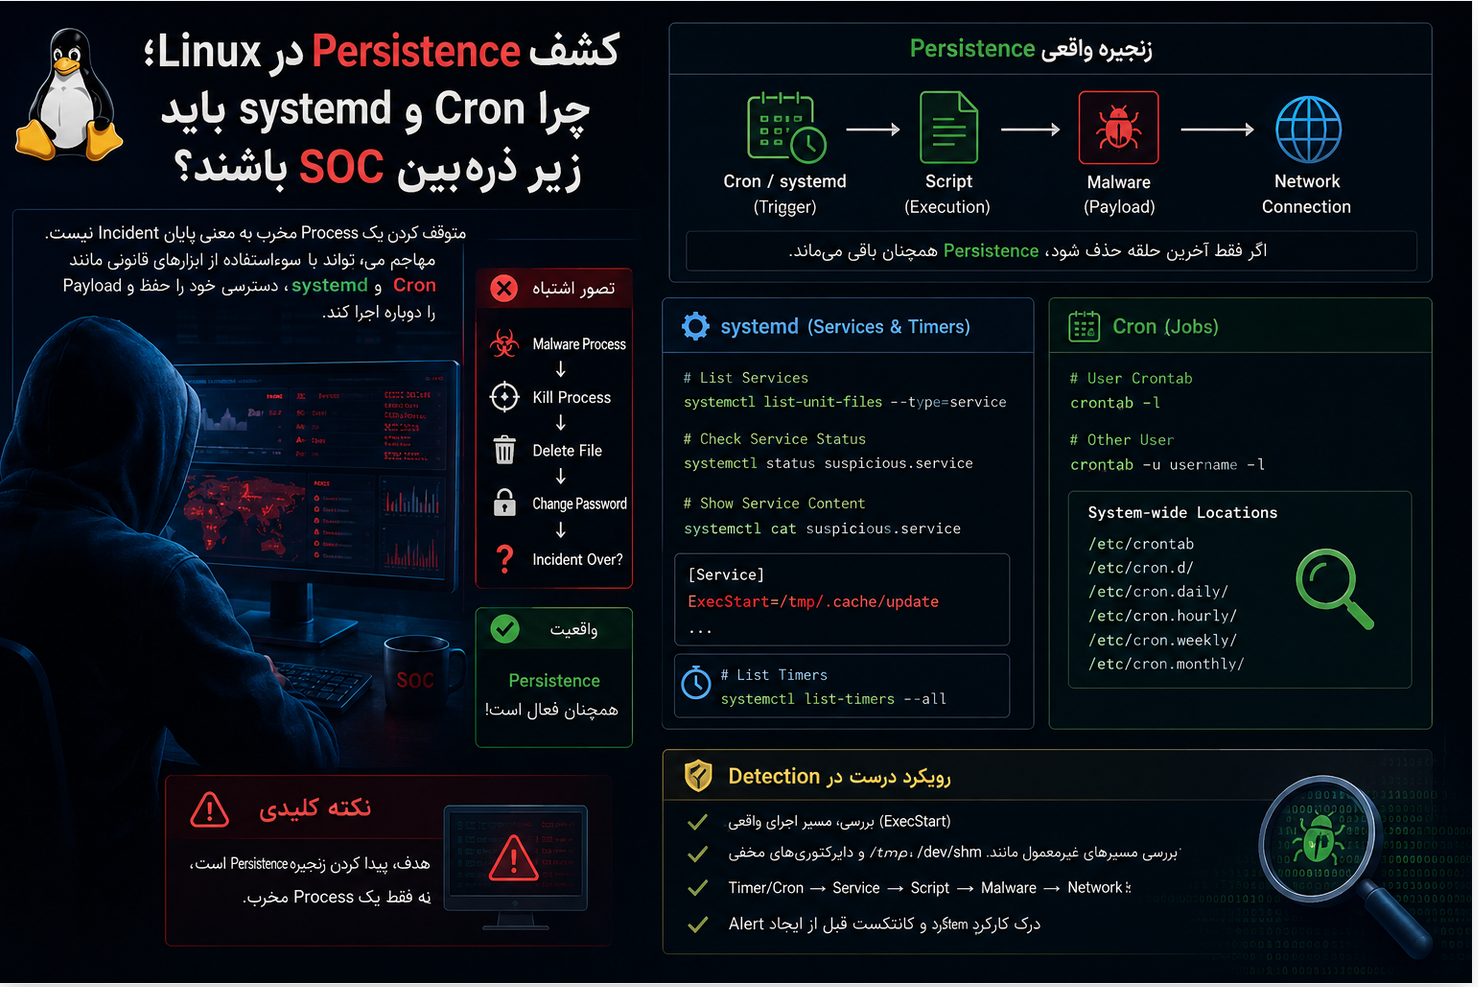
یکی از اشتباهات رایج در Incident Response این است که تصور کنیم با متوقف کردن یک Process مخرب، حادثه پایان یافته است. فرض کنید روی یک Linux Server پردازشی ناشناس مشاهده میشود که به یک IP خارجی متصل است. تیم SOC پردازش را Kill میکند، فایل مخرب را حذف میکند و حتی Password حساب کاربری را تغییر میدهد. چند دقیقه یا چند ساعت بعد، همان Process دوباره ظاهر میشود.
در چنین شرایطی سؤال مهم دیگر این نیست که «این Process چیست؟» بلکه باید پرسید:
چه چیزی این Process را دوباره اجرا کرده است؟
اینجاست که مفهوم Persistence اهمیت پیدا میکند.
Persistence مجموعه تکنیکهایی است که مهاجم برای حفظ دسترسی خود پس از Restart، Logout، تغییر Password، متوقف شدن Process یا حتی بخشی از اقدامات Incident Response استفاده میکند.
در Linux، مهاجم الزاماً به Rootkit پیچیده نیاز ندارد. بسیاری از قابلیتهایی که مدیران سیستم برای Automation استفاده میکنند، میتوانند برای Persistence نیز مورد سوءاستفاده قرار گیرند. دو نمونه بسیار مهم آنها Cron و systemd هستند.
چرا ابزارهای قانونی برای مهاجم جذاباند؟
یکی از اصول مهم Detection Engineering این است که ابزار مورد استفاده مهاجم الزاماً مخرب نیست.
Cron برای اجرای زمانبندیشده وظایف طراحی شده است. Backup، پاکسازی فایلهای موقت، اجرای اسکریپتهای مدیریتی و بسیاری از فعالیتهای روزمره با Cron انجام میشوند.
systemd نیز در بسیاری از توزیعهای جدید Linux مسئول مدیریت Serviceها، Timerها و بخش مهمی از Startup سیستم است.
مشکل زمانی ایجاد میشود که مهاجم از همین امکانات قانونی برای اجرای Payload استفاده کند.
برای مثال مهاجم میتواند کاری کند که یک اسکریپت مخرب هر پنج دقیقه اجرا شود. حتی اگر تحلیلگر Process مربوط به Malware را متوقف کند، Cron چند دقیقه بعد آن را دوباره اجرا خواهد کرد.
در systemd نیز مهاجم میتواند Serviceای ایجاد کند که هنگام Boot اجرا شود یا در صورت متوقف شدن Process، مجدداً آن را راهاندازی کند.
بنابراین:
Malware Process → Kill
لزوماً به معنی پایان Incident نیست.
ممکن است زنجیره واقعی این باشد:
Cron/systemd → Script → Malware → Network Connection
اگر فقط آخرین حلقه زنجیره حذف شود، Persistence همچنان باقی مانده است.
اولین محل بررسی: systemd Services
در Incident Response یکی از اولین اقدامات میتواند بررسی Serviceهای موجود باشد.
برای مشاهده Unit Fileهای مربوط به Serviceها میتوان از دستور زیر استفاده کرد:
systemctl list-unit-files --type=service
اما وجود یک Service ناشناس به تنهایی اثباتکننده حمله نیست. سرورهای Production معمولاً تعداد زیادی Service متعلق به Applicationها، Agentهای Monitoring، Backup، Security و ابزارهای مدیریتی دارند.
اگر Service مشکوکی پیدا شد، باید محتوای واقعی آن بررسی شود:
systemctl status suspicious.service
و سپس:
systemctl cat suspicious.service
یکی از مهمترین قسمتهایی که باید بررسی شود ExecStart است.ExecStart مشخص میکند Service در واقع چه Binary یا Scriptی را اجرا میکند.
برای مثال ممکن است نام Service ظاهراً طبیعی باشد:
system-update.service
اما درون آن ببینیم:
ExecStart=/tmp/.cache/update
اینجا نام Service اهمیت چندانی ندارد؛ Execution Path بسیار مهمتر است.
اجرای Service از مسیرهایی مانند /tmp، /dev/shm یا Hidden Directoryهای غیرمعمول باید بررسی شود، زیرا این مسیرها معمولاً محل اجرای دائمی Serviceهای Production نیستند.
اهمیت systemd Timer
فقط Serviceها را نباید بررسی کرد. systemd قابلیت Timer نیز دارد که میتواند رفتاری مشابه Scheduled Task ایجاد کند.
برای مشاهده Timerها میتوان از دستور زیر استفاده کرد:
systemctl list-timers --all
فرض کنید یک Timer ناشناس هر سه دقیقه یک Service را اجرا میکند. تیم SOC Process ایجادشده را Kill میکند، اما Timer همچنان فعال است و چند دقیقه بعد Process دوباره ایجاد میشود.
بنابراین در Investigation باید رابطه زیر را پیدا کنیم:
Timer → Service → ExecStart → Script/Binary → Network Activity
این زنجیره برای Detection Engineering بسیار ارزشمندتر از مشاهده صرف یک Process است.
Cron؛ Persistence ساده اما مؤثر
Cron یکی از قدیمیترین و در عین حال مؤثرترین روشهای Automation در Linux است.
کاربر میتواند با دستور زیر Cron Jobهای خودش را مشاهده کند:
crontab -l
Administrator نیز میتواند Cron Job کاربر دیگری را بررسی کند:
crontab -u username -l
اما بررسی فقط User Crontab کافی نیست. مسیرهای System-wide نیز باید بررسی شوند، از جمله
/etc/crontab
/etc/cron.d/
/etc/cron.daily/
/etc/cron.hourly/
/etc/cron.weekly/
/etc/cron.monthly/
اگر یک Cron Job به Scriptی اشاره میکند، نباید فوراً آن Script را اجرا کرد. ابتدا باید محتوا و زنجیره اجرای آن بررسی شود.
ممکن است Cron فقط یک Script را اجرا کند و آن Script نیز Binary دیگری را راهاندازی کند که در نهایت با زیرساخت مهاجم ارتباط برقرار میکند. بنابراین تحلیل باید تا انتهای Execution Chain ادامه پیدا کند.
مشکل اصلی SOC: همه Cron Jobها مشکوک نیستند
اینجا یکی از مهمترین چالشهای Detection Engineering ظاهر میشود.اگر برای هر Cron Job یا systemd Service یک Alert ایجاد کنیم، SOC با حجم بزرگی از False Positive مواجه خواهد شد.
Backup Server ممکن است دهها Scheduled Job داشته باشد. Database Server ممکن است مرتباً Maintenance Task اجرا کند. Monitoring Agent ممکن است Serviceهای خاص خودش را داشته باشد.
بنابراین Detection نباید بر این منطق ساخته شود:
Cron Exists → Alert
بلکه بهتر است بگوییم:
Cron/Systemd + Abnormal Context → Alert
این همان جایی است که Baseline اهمیت پیدا میکند.
SOC باید بداند چه Serviceها، Timerها و Cron Jobهایی روی یک Server مشخص طبیعی هستند.
چه رفتارهایی مشکوکتر هستند؟
چند نشانه میتوانند Risk Score را افزایش دهند:
ایجاد Service جدیدی که قبلاً در Baseline وجود نداشته است؛
Serviceای که Binary آن از /tmp یا /dev/shm اجرا میشود؛
Cron Job جدید متعلق به Service Accountای که معمولاً Scheduled Task ندارد؛
Timerای که با فاصله زمانی بسیار کوتاه اجرا میشود؛
Serviceای که بلافاصله بعد از اجرا Connection خارجی ایجاد میکند؛
تغییر غیرمنتظره در فایلهای systemd یا Crontab؛
اجرای Script یا Binary با Privilege بالا بدون توجیه عملیاتی.
هیچکدام از این موارد به تنهایی اثبات حمله نیستند، اما ترکیب چند مورد میتواند Detection بسیار قدرتمندی ایجاد کند.
Detection Engineering برای Cron و systemd
از منظر SOC بهتر است به جای یک Rule، چند لایه Detection طراحی شود.
Detection 1 – ایجاد یا تغییر systemd Unit
مانیتور کردن تغییرات در مسیرهایی مانند:
/etc/systemd/system/
و سایر مسیرهای Unit File.
اگر فایل Service جدیدی ایجاد شد، باید مشخص شود چه Process و Userای آن را ایجاد کرده است.
Detection 2 – تغییر Cron Configuration
تغییر فایلهای Crontab یا ایجاد فایل جدید در /etc/cron.d/ میتواند Event مهمی باشد.
باز هم Context تعیینکننده است. اگر تغییر توسط Configuration Management مورد تأیید انجام شده باشد طبیعی است؛ اما اگر Web Server Process باعث ایجاد Cron Job شده باشد، موضوع کاملاً متفاوت است.
Detection 3 – اجرای Service از مسیر غیرعادی
یک Rule رفتاری میتواند بررسی کند:
systemd → executable in /tmp or /dev/shm
این رفتار در بسیاری از محیطها بسیار غیرمعمول است و ارزش Investigation بالایی دارد.
Detection 4 – ارتباط شبکهای پس از اجرای Service
Detection قویتر زمانی شکل میگیرد که Telemetryهای مختلف Correlate شوند:
New systemd service
New Process
Outbound Connection
اگر این سه رویداد در فاصله زمانی کوتاهی رخ دهند، احتمال فعالیت مخرب بسیار بیشتر میشود.
File Integrity Monitoring چه کمکی میکند؟
یکی از بهترین ابزارها برای کشف چنین تغییراتی File Integrity Monitoring یا FIM است.
به جای اینکه تحلیلگر مرتباً مسیرهای Cron و systemd را بررسی کند، میتوان تغییرات مسیرهای حساس را مانیتور کرد.
برای مثال:
/etc/systemd/system/
/etc/crontab
/etc/cron.d/
و سایر مسیرهای حساس.
راهکارهایی مانند Wazuh، auditd و محصولات EDR میتوانند بخشی از این Visibility را فراهم کنند.
اما FIM به تنهایی کافی نیست.FIM میگوید«این فایل تغییر کرد.»
Detection Engineering باید سؤال بعدی را پاسخ دهد:
«چه کسی، با چه Processی، در چه زمانی و با چه نتیجهای آن را تغییر داد؟»
این تفاوت Monitoring ساده با Detection Engineering است.
قبل از حذف Artifact، Evidence را حفظ کنید
یکی از نکات بسیار مهم Incident Response این است که به محض مشاهده Cron Job یا Service مشکوک آن را حذف نکنیم.
ابتدا باید Evidence جمعآوری شود.
برای مثال:
مالک فایل چه کسی است؟
Permission فایل چیست؟
چه زمانی ایجاد یا تغییر کرده است؟
Hash فایل چیست؟
چه Commandی اجرا میشود؟
آیا همین Hash روی Serverهای دیگری وجود دارد؟
Service با چه Privilegeای اجرا میشود؟
آیا Connection خارجی ایجاد کرده است؟
برای مشاهده History یک Service نیز میتوان از Journal استفاده کرد:
journalctl -u suspicious.service
این اطلاعات میتواند برای ساخت Timeline حادثه بسیار مهم باشد.
حذف سریع Artifact ممکن است بخشی از Evidence را از بین ببرد.
Persistence معمولاً فقط یک Artifact نیست
اگر مهاجم توانسته یک Root-owned systemd Service ایجاد کند، مسئله بسیار بزرگتر از همان Service است.
باید پرسید:
مهاجم چگونه توانسته این Service را ایجاد کند؟
ممکن است Credential سرقت شده باشد، Privilege Escalation رخ داده باشد یا آسیبپذیری دیگری مورد سوءاستفاده قرار گرفته باشد.
بنابراین زنجیره Investigation میتواند چنین باشد:
Initial Access
Privilege Escalation
Persistence
Command Execution
Command & Control
اگر فقط Persistence حذف شود اما Initial Access همچنان باز باشد، مهاجم میتواند دوباره وارد سیستم شود.
چرا حذف Persistence به معنی Recovery نیست؟
فرض کنید SOC Cron Job مخرب را پیدا و حذف کرده است.
آیا Incident تمام شده؟ خیر.
Credentialهای در معرض خطر باید Rotate شوند. سیستمهای دیگر باید برای Artifact مشابه بررسی شوند. Network Connectionها باید تحلیل شوند و Initial Access مشخص شود.
اگر شواهد نشان دهد مهاجم Root Access داشته و تیم Incident Response نتواند با اطمینان مشخص کند چه تغییراتی انجام شده است، اعتماد به سیستم بسیار دشوار میشود.
در چنین شرایطی، Rebuild کردن سیستم از یک Known-Good State ممکن است از پاکسازی دستی امنتر باشد.
یک سناریوی Detection برای SOC
فرض کنید روی یک Web Server لینوکسی، FIM ایجاد فایل زیر را گزارش میکند:
/etc/systemd/system/update-check.service
چند ثانیه بعد Service فعال میشود.
EDR مشاهده میکند:
systemd → /tmp/.update
و Process ایجادشده به یک IP اینترنتی روی Port 443 متصل میشود.
هر Event به تنهایی شاید توضیحی داشته باشد، اما Correlation آنها داستان متفاوتی ایجاد میکند:
Systemd Unit Creation
Execution from /tmp
Root Process
Outbound Connection
Unknown Destination
اینجا SIEM میتواند به جای تولید چهار Alert مستقل، یک Detection با Risk بالا ایجاد کند.
این همان فلسفه Behavior-based Detection است.
نتیجهگیری
مهمترین درس Persistence در Linux این است که مهاجم همیشه به Malware پیچیده نیاز ندارد. گاهی ابزارهایی که Administrator هر روز برای مدیریت سیستم استفاده میکند، بهترین ابزار مهاجم هستند.
Cron، systemd Service و systemd Timer ذاتاً مخرب نیستند. آنچه اهمیت دارد Context، Baseline و Execution Chain است.
SOC بالغ نباید فقط بپرسد
«چه Process مخربی اجرا شده است؟»
بلکه باید بپرسد:
«چه چیزی باعث اجرای آن شده و اگر Process را Kill کنیم، چه چیزی آن را دوباره برمیگرداند؟»
به همین دلیل Detection Persistence باید ترکیبی از Process Monitoring، File Integrity Monitoring، Audit Logs، systemd Journal، Network Telemetry و SIEM Correlation باشد.
و شاید مهمترین اصل Incident Response در این سناریو این باشد:
Process را Kill کردن، Persistence را از بین نمیبرد.
تا زمانی که مکانیزم اجرای مجدد شناسایی نشده باشد، مهاجم ممکن است همچنان راه بازگشت داشته باشد.

