
اگر دیتابیس با موفقیت عملیاتش را Commit کند و Message Broker در همان لحظه از دسترس خارج شود، آیا سیستم شما همچنان میتواند عملیات را موفقیتآمیز بداند ؟
فرض کنید کاربر در یک فروشگاه اینترنتی سفارشی ثبت میکند و سفارش با موفقیت در دیتابیس ذخیره میشود:
Order #123 → Created
اما چند میلیثانیه بعد سرویس شما میخواهد رویداد OrderCreated را به Kafka یا RabbitMQ ارسال کند و ناگهان:
شبکه قطع میشود.
Broker در دسترس نیست.
اپلیکیشن کرش میکند.
Timeout رخ میدهد.
نتیجه چیست ؟
دیتابیس میگوید:
سفارش ایجاد شده است.
اما سایر سرویسها میگویند:
ما هیچ خبری از این سفارش نداریم!
این دقیقا یکی از معروفترین مشکلات سیستمهای توزیعشده و معماری Microservices است؛ مشکلی که به آن Dual Write Problem میگوییم.
اینجاست که Outbox Pattern وارد میشود.
بهجای اینکه همزمان در دیتابیس و Message Broker مقداری وارد کنیم، تغییر وضعیت Business Data و پیام مربوط به آن را در یک Transaction ذخیره میکنیم و ارسال پیام را به مرحلهای جداگانه میسپاریم.
این تغییر کوچک در طراحی، میتواند تفاوت بزرگی در Reliability سیستم ایجاد کند.
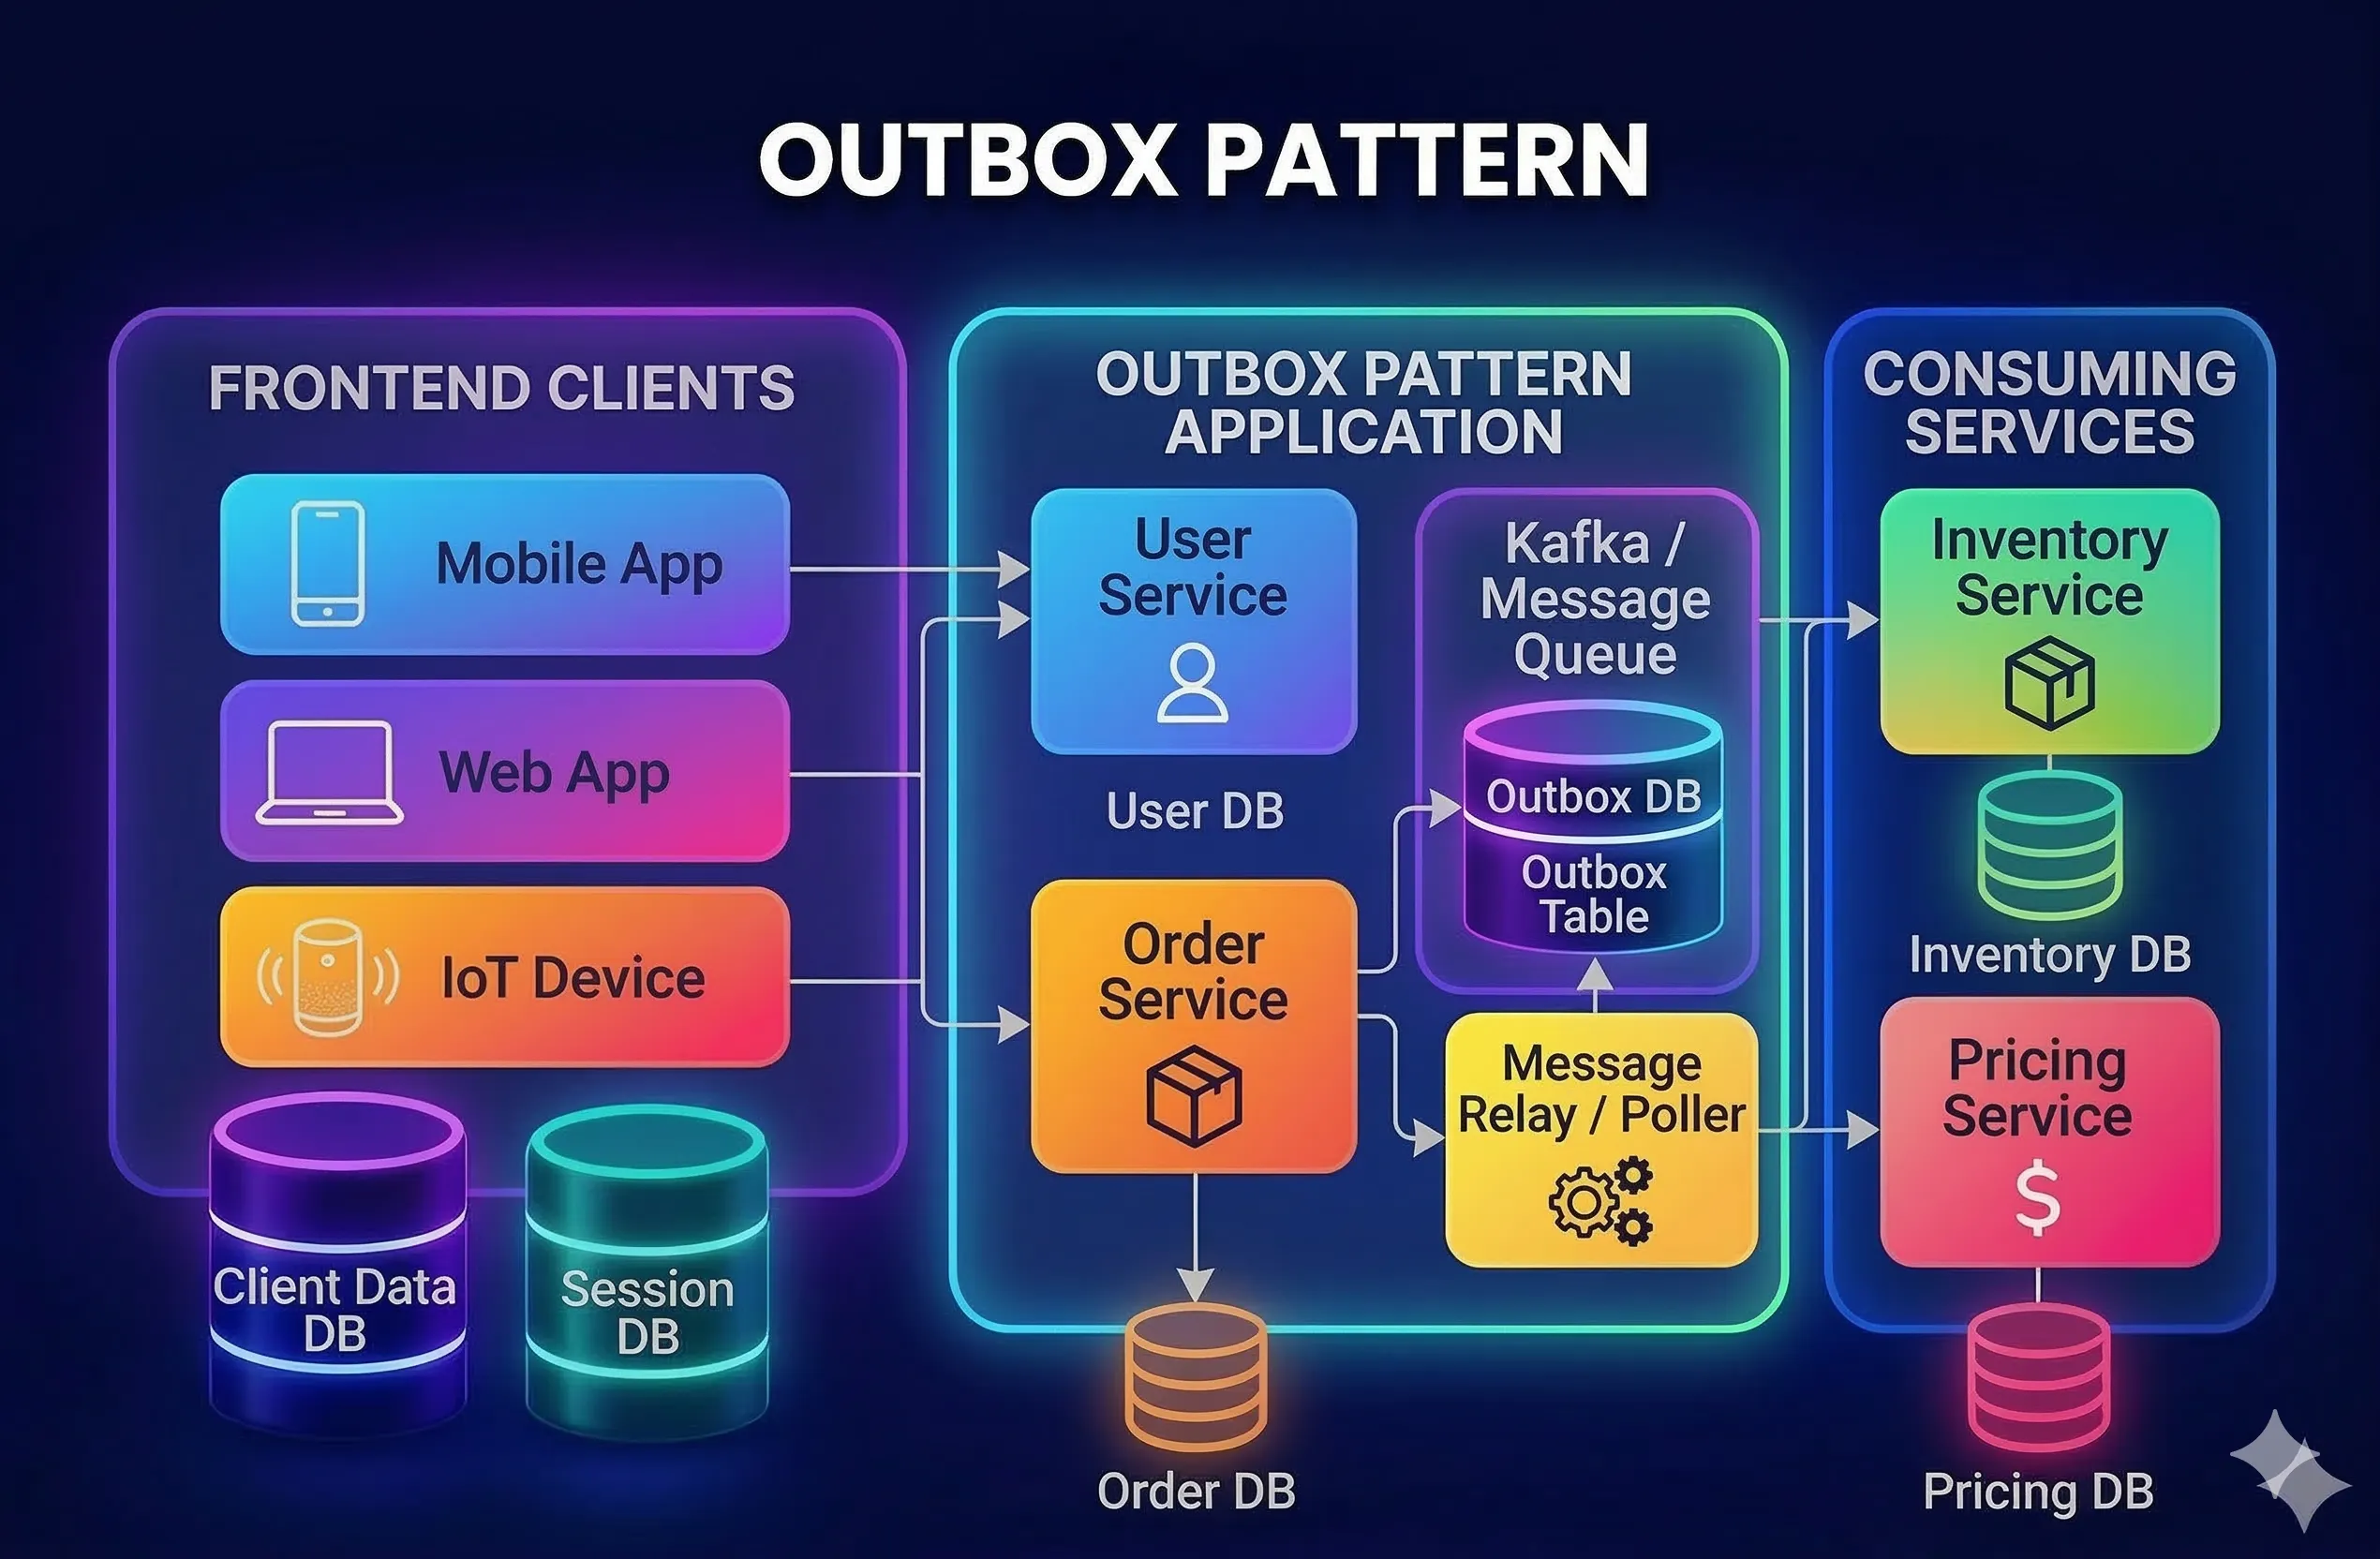
Outbox Pattern یا به شکل دقیقتر Transactional Outbox Pattern یک الگوی طراحی برای ارسال قابلاعتماد پیام (Message) و رویداد (Event) در سیستمهای توزیعشده است.
در این الگو بهجای اینکه اپلیکیشن مستقیما بعد از تغییر دیتابیس یک Event را به Message Broker ارسال کند، ابتدا Event را در یک Outbox Table در همان دیتابیس ذخیره میکند.
مهمترین نکته این است که تغییر Business Data و ذخیره Event در Outbox باید در یک Database Transaction انجام شوند. بعد یک Process جداگانه رویدادهای موجود در Outbox را میخواند و به Message Broker ارسال میکند.
به شکل ساده:
 Application
     │
     │ Transaction
     ▼
┌───────────────────────┐
│       Database        │
│                       │
│  Orders               │
│  Outbox Events        │
└───────────┬───────────┘
            │
            │ Async
            ▼
     Outbox Publisher
            │
            ▼
     Message Broker
            │
       ┌────┴────┐
       ▼         ▼
   Service A  Service B
برای درک Outbox ابتدا باید مشکل اصلی را بشناسیم. فرض کنید یک Order Service داریم که باید دو کار انجام دهد:
۱. سفارش را در دیتابیس ذخیره کند.
۲. رویداد OrderCreated را به Kafka ارسال کند.
ممکن است کد ما چیزی شبیه این باشد:
BEGIN TRANSACTION
INSERT INTO orders (...)
COMMIT
publish(OrderCreated)
در نگاه اول منطقی است. اما بین COMMIT و publish یک شکاف خطرناک وجود دارد. اگر دیتابیس Commit شود ولی اپلیکیشن قبل از publish کرش کند، چه اتفاقی میافتد؟
Database
   │
   └── Order Created ✅

Message Broker
   │
   └── OrderCreated ❌
حالا سیستم وارد وضعیتی شده که State داخلی تغییر کرده و Event مربوط به آن هرگز منتشر نشده است. AWS نیز Transactional Outbox را برای حل مسالهی Dual Write معرفی میکند؛ یعنی حالتی که یک عملیات باید هم دیتابیس و هم سیستم پیامرسان را تغییر دهد، ولی شکست یکی از آنها میتواند باعث ناسازگاری شود.
Dual Write یعنی یک عملیات منطقی باید در دو سیستم مستقل Write شود. برای نمونه:
Database
    +
  Kafka
یا:
Database
    +
RabbitMQ
یا حتی:
Database
    +
External API
مشکل اینجاست که معمولا بین این دو سیستم یک Transaction مشترک نداریم. برای نمونه:
1. UPDATE database ✅
2. SEND message ❌
یا برعکس:
1. SEND message ✅
2. UPDATE database ❌
در حالت اول Event گم شده است. در حالت دوم یک Event منتشر شده که Business State مربوط به آن اصلا وجود ندارد.
ممکن است بگویید:
خب، ارسال Message را داخل Transaction قرار میدهیم!
مشکل اینجاست که دیتابیس و Message Broker دو Resource مستقل هستند و برای Atomic بودن عملیاتمان باید نوعی Distributed Transaction داشته باشیم. یکی از راهکارهای کلاسیک برای این کار Two-Phase Commit یا 2PC است.
در روش 2PC، یک هماهنگکننده (coordinator) از همه سیستمها میپرسد «آمادهای که تغییرات را ثبت کنی ؟» و فقط وقتی همه موافق باشند، به همه دستور ثبت نهایی تغییرات را میدهد؛ اگر یکی مشکل داشته باشد، کل عملیات متوقف میشود.
این روش از نظر تئوری جذاب است، اما در معماریهای مدرن مشکلاتی مانند Complexity، Latency، Coupling و Failure Handling ایجاد میکند. علاوه بر این، همهی دیتابیسها و Message Brokerها الزاما از چنین تراکنشی پشتیبانی نمیکنند.
Outbox یک سوال متفاوت میپرسد:
آیا واقعا لازم است دیتابیس و Broker را در یک Transaction قرار دهیم ؟
پاسخ Outbox این است:
نه. کافی است عملیات حیاتی را در یک Transaction داخلی و قابل اتکا ثبت کنیم و ارسال را به بعد موکول کنیم.
بهجای این:
Database → Commit
Broker   → Publish
از این روش استفاده میکنیم:
Database
 ├── Business Data
 └── Outbox Event
برای نمونه:
BEGIN;
INSERT INTO orders (id, customer_id, status) VALUES (123, 456, 'CREATED');
INSERT INTO outbox (id, aggregate_type, aggregate_id, event_type, payload) VALUES ('event-789', 'Order', 123, 'OrderCreated', '{...}');
COMMIT;
اگر Transaction موفق شود:
Order ✅
Outbox Event ✅
و اگر شکست بخورد:
Order ❌
Outbox Event ❌
یعنی دیتابیس تضمین میکند که این دو تغییر با هم Commit یا Rollback شوند. این همان نقطهی کلیدی Outbox Pattern است.
Outbox معمولا یک جدول (Table) معمولی است. برای مثال:
CREATE TABLE outbox (
    id              UUID PRIMARY KEY,
    aggregate_type  VARCHAR(100),
    aggregate_id    VARCHAR(100),
    event_type      VARCHAR(200),
    payload         JSONB,
    created_at      TIMESTAMP,
    processed_at    TIMESTAMP NULL
);
البته Schema واقعی بسته به نیاز سیستم میتواند بسیار متفاوت باشد. فیلدهای مهم معمولا شامل این موارد هستند:
1. id
شناسهی یکتا برای Event. وجود این ID برای Deduplication و Idempotency بسیار مهم است.
2. aggregate_id
برای نمونه:
order_id = 123
این فیلد برای حفظ Ordering در بسیاری از معماریها اهمیت دارد.
3. event_type
برای نمونه:
OrderCreated
OrderPaid
OrderCancelled
4. payload
اطلاعات Event مثل:
{
  "orderId": 123,
  "customerId": 456,
  "totalAmount": 250
}
5. created_at
زمان ایجاد Event.
6. processed_at
در روشهای Polling میتوان از این فیلد برای مشخص کردن Eventهای پردازششده استفاده کرد.
بیایید کل جریان را ببینیم:
Client
   │
   ▼
Order Service
   │
   │ BEGIN TRANSACTION
   ├───────────────────────┐
   │                       │
   ▼                       ▼
Orders Table          Outbox Table
   │                       │
   └──────────┬────────────┘
              │
           COMMIT
              │
              ▼
       Outbox Publisher
              │
              ▼
        Message Broker
              │
       ┌──────┴──────┐
       ▼             ▼
 Inventory        Notification
 Service            Service
قدم به قدم:
۱. Client درخواست ایجاد Order را ارسال میکند.
۲. Order Service یک Transaction باز میکند.
۳. Order در دیتابیس ذخیره میشود.
۴. Event مربوط به Order در Outbox ذخیره میشود.
۵. Transaction Commit میشود.
۶. یک Publisher رویداد را از Outbox میخواند.
۷. Event به Message Broker ارسال میشود.
۸. Consumerهای مختلف Event را میخوانند.
۹. Outbox Event بعد از Publish موفق، Cleanup یا Mark میشود.
نکتهی مهم اینجاست که اپلیکیشن برای موفقیتِ درخواستِ اصلی لازم نیست منتظر Broker بماند. به همین دلیل ارسال Event میتواند Asynchronous باشد.
فرض کنید کاربر سفارش شماره 1001 را ثبت میکند.
مرحله ۱: ایجاد سفارش
POST /orders
اپلیکیشن وارد Transaction میشود.
مرحله ۲: ذخیره Order
orders

id: 1001
status: CREATED
مرحله ۳: ذخیره Event
در همان Transaction:
outbox

id: event-abc
event_type: OrderCreated
aggregate_id: 1001
مرحله ۴: Commit
اگر Commit موفق باشد:
Order → persisted
Event → persisted
حالا حتی اگر اپلیکیشن بلافاصله Crash کند، Event از بین نرفته است.
مرحله ۵: Publisher رویداد را ارسال میکند:
Kafka → OrderCreated
مرحله ۶: Consumerها
Inventory Service:

OrderCreated
      ↓
Reserve Stock
Notification Service:

OrderCreated
      ↓
Send Confirmation Email
Analytics Service:

OrderCreated
      ↓
Record Conversion
این همان جایی است که Outbox به Event-Driven Architecture کمک میکند.
خیر. این یکی از مهمترین نکات Outbox Pattern است. Outbox معمولا تضمین میکند که Event گم نشود، اما الزاما تضمین نمیکند که Event دقیقا یک بار منتشر شود.
فرض کنید:
۱. Publisher رویداد را میخواند
۲. Event را به Kafka میفرستد
۳. Kafka پیام را دریافت میکند
۴. Publisher قبل از ثبت وضعیت processed کرش میکند
بعد از Restart:
Publisher
   ↓
"این ایونت هنوز پردازش نشده"
   ↓
Publish Again
بنابراین OrderCreated ممکن است دو بار به Consumer برسد. این رفتار کاملا طبیعی است و به مدل At-Least-Once Delivery مربوط است. AWS نیز برای Transactional Outbox صراحتا به احتمال Duplicate Message اشاره میکند و Idempotent بودن Consumer را توصیه میکند.
اگر از Outbox استفاده میکنید، باید از خودتان بپرسید اگر یک Event دوبار به Consumer رسید، آیا آن Consumer به شکلی خراب عمل میکند ؟
برای نمونه:
PaymentCompleted
اگر Consumer دوبار آن را پردازش کند و هر بار:
$100 → Charge Customer
آنوقت مشتری ممکن است دوبار شارژ شود. Consumer باید بتواند Duplicate بودن را تشخیص دهد.
یکی از روشهای رایج:
processed_events

event_id
--------
event-123
event-456
قبل از Processing:
Does event-123 exist ?
اگر وجود داشت:
Ignore
اگر وجود نداشت:
Process
Insert event_id
بهتر است این عملیات نیز در یک Transaction انجام شود. به این ترتیب Outbox و Idempotent Consumer مکمل یکدیگر میشوند.
اینجا باید خیلی مراقب اصطلاحات باشیم. گاهی گفته میشود:
Outbox باعث Exactly-Once Delivery میشود.
این عبارت بیش از حد سادهسازی شده است. Outbox بهتنهایی چنین تضمینی نمیدهد.
معمولا چنین ساختاری داریم:
Producer
   ↓
Outbox
   ↓
At-Least-Once Publish
   ↓
Idempotent Consumer
و این ترکیب میتواند از نظر اثر نهایی روی Business State رفتار بسیار قابلاعتمادتری ایجاد کند. اما اگر Consumer مثلا یک External API را صدا بزند، تضمین Exactly-Once در کل زنجیره بسیار پیچیدهتر میشود.
نکته مهم:
Exactly-Once یک ویژگی سادهی یک Component نیست؛ یک خاصیت End-to-End است.
برای این کار معمولا دو رویکرد اصلی وجود دارد:
۱. Polling
۲. Change Data Capture یا CDC
در این روش یک Worker مرتب از جدول Outbox کوئری میگیرد. برای نمونه:
SELECT * FROM outbox WHERE processed_at IS NULL ORDER BY created_at LIMIT 100;
سپس:
Read
 ↓
Publish
 ↓
Mark as processed
مزیت Polling در سادگی است. نیازی نیست سیستم شما با Transaction Log دیتابیس کار کند. تقریبا با هر دیتابیسی که بتواند کوئری بدهد، میتوان چنین معماریای ساخت.
عیب Polling برای نمونه اگر هر ۵ ثانیه کوئری بزنیم، ممکن است یک Event درست بعد از کوئری ما ایجاد شود و مجبور باشیم تا کوئری بعدی، یعنی حدود ۵ ثانیه، منتظر بمانیم.
اگر Polling را خیلی سریع کنیم:
100ms
50ms
10ms
فشار بیشتری روی دیتابیس ایجاد میشود. بنابراین یک Trade-off داریم:
Polling Frequency
       ↕
     Latency
       ↕
Database Load
در CDC بهجای اینکه مرتب به یک جدول کوئری بزنیم، تغییرات دیتابیس را از Transaction Log دنبال میکنیم.
برای نمونه:
Application
    ↓
Database
    ↓
Transaction Log
    ↓
CDC Connector
    ↓
Message Broker
در دیتابیسهای مختلف ممکن است لاگهایی مانند موارد زیر وجود داشته باشد:
WAL
Binlog
Redo Log
ابزارهایی مانند Debezium میتوانند تغییرات Outbox Table را از Transaction Log دریافت کرده و به Event تبدیل کنند. مستندات رسمی Debezium حتی Outbox Event Router مشخصی برای این سناریو ارایه کرده است.
مزایای CDC
Latency کمتر
کاهش نیاز به Polling مداوم
مناسب برای Throughput بالا
هماهنگی بهتر با تغییرات Transaction Log
معایب CDC
معماری پیچیدهتر
نیاز به زیرساخت و Monitoring بیشتر
وابستگی به قابلیتهای دیتابیس
Operational Complexity بالاتر
بنابراین CDC لزوما بهتر از Polling نیست؛ فقط در بعضی مقیاسها و بر اساس محدودیتهای Latency، مناسبتر است.
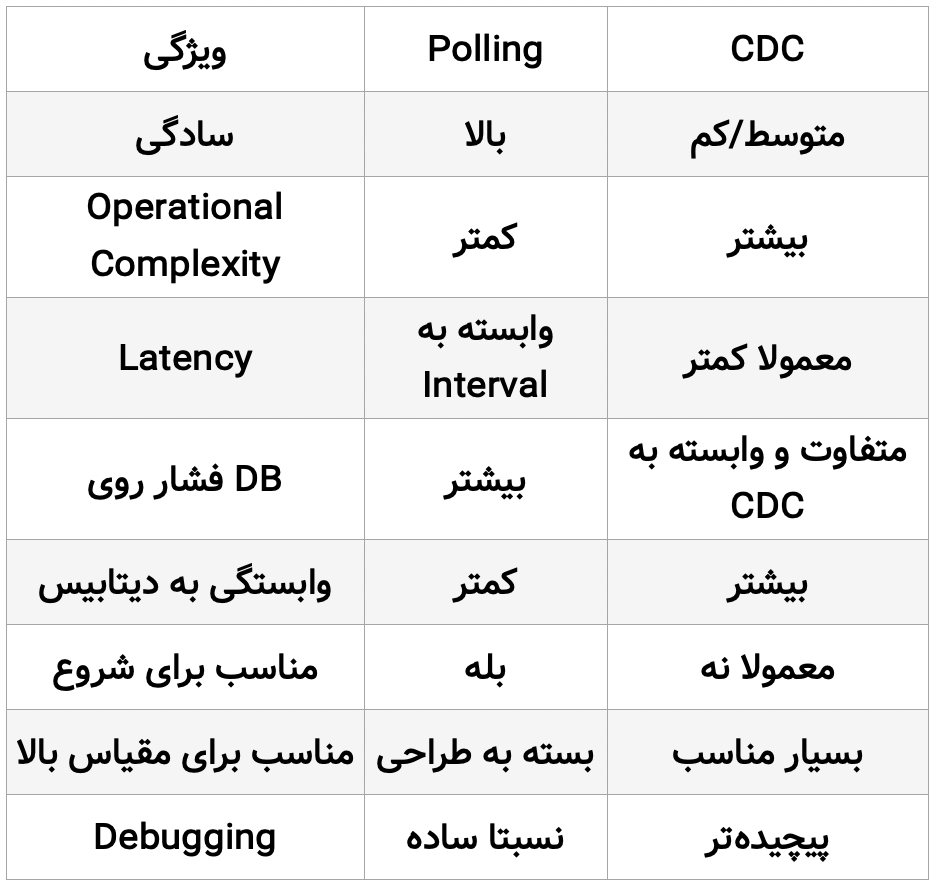
اگر سیستم شما تازه در حال شکلگیری است، Polling میتواند انتخاب سادهای باشد. اگر حجم Eventها زیاد است و Latency پایین اهمیت زیادی دارد، CDC میتواند گزینهی مناسبتری باشد.
بهصورت خودکار و در همهی معماریها نه. فرض کنید:
OrderCreated
OrderPaid
OrderShipped
Consumer باید همین ترتیب را ببیند. اگر:
OrderShipped
OrderCreated
OrderPaid
دریافت شود، ممکن است Business Logic دچار مشکل شود. بنابراین باید Ordering را آگاهانه طراحی کنیم. برای مثال:
aggregate_id = order-123
و سپس Eventهای مربوط به یک Aggregate را به یک Partition در Broker هدایت کنیم.
در کافکا Partition Key میتواند در چنین طراحیای کمک کند که Eventهای یک Aggregate به ترتیب در یک Partition قرار بگیرند.
Outbox Pattern و Message Ordering دو مسالهی مرتبط اما متفاوت هستند.
فرض کنید سیستم شما در هر ثانیه ۱,۰۰۰ Event تولید کند. در یک روز تقریبا ۸۶,۴۰۰,۰۰۰ Event خواهید داشت.
اگر Eventها را بعد از Publish حذف نکنید، جدول Outbox خیلی سریع رشد میکند. در نتیجه:
افزایش حجم دیتابیس
Indexهای بزرگتر
Backupهای سنگینتر
کوئریهای کندتر
هزینه Storage بیشتر
را در بر دارد. بنابراین Outbox به یک Lifecycle Strategy نیاز دارد.
برای نمونه:
Pending
   ↓
Published
   ↓
Retention Period
   ↓
Delete / Archive
۱. Delete
بعد از Publish موفق Event حذف شود. ساده و کمهزینه است، اما Replay تاریخی را سختتر میکند.
۲. Archive
Eventها بعد از مدتی به Storage دیگری منتقل شوند. برای Audit و Debugging مناسبتر است.
۳. Partitioning
جدول بر اساس زمان Partition شود. برای نمونه:
outbox_2026_09_18
outbox_2026_09_19
outbox_2026_09_20
و Partitionهای قدیمی حذف یا Archive شوند.
۱. جلوگیری از Lost Event
مهمترین مزیت Outbox این است که اگر Business Transaction کامیت شود، Event نیز همراه آن ذخیره میشود. در نتیجه Crash کردن Publisher بلافاصله بعد از Commit، باعث Lost Event نمیشود.
۲. عدم نیاز به 2PC
دیتابیس و Broker مجبور نیستند یک Distributed Transaction مشترک داشته باشند.
۳. جداسازی Business Operation از Message Publishing
Business Request لازم نیست منتظر Broker بماند.
۴. مناسب برای Event-Driven Architecture
Outbox برای ارتباط بین Microserviceها بسیار کاربردی است.
۵. Retry سادهتر
اگر Broker موقتا در دسترس نباشد:
Outbox
  ↓
Retry
  ↓
Retry
  ↓
Success
Event همچنان در دیتابیس باقی میماند.
۱. Complexity بیشتر
به جای دیتابیس تنها، چنین چیزی داریم:
Database
+
Outbox
+
Publisher
+
Broker
+
Retry
+
Monitoring
+
Cleanup
۲. Duplicate Event
Publisher ممکن است Event را بیش از یک بار ارسال کند. پس Consumer باید Idempotent باشد.
۳. Eventual Consistency
Event بلافاصله بعد از Commit به همه سرویسها نمیرسد. برای مدت کوتاهی ممکن است:
Order Service → CREATED Inventory Service → هنوز چیزی نمیداند
این تاخیر باید در طراحی Business قابل قبول باشد.
۴. رشد Outbox
اگر Lifecycle مناسبی نداشته باشید، Outbox تبدیل به یک جدول بسیار بزرگ میشود.
۵. Failureهای جدید
حالا باید مشکلاتی همچون:
Publisher Crash
Broker Down
Database Down
Poison Message
Retry Storm
Duplicate Event
Outbox Backlog
را نیز مدیریت کنید. بنابراین Outbox مشکل Reliability را حذف نمیکند؛ نوع Failureهایی که باید مدیریت کنید را تغییر میدهد.
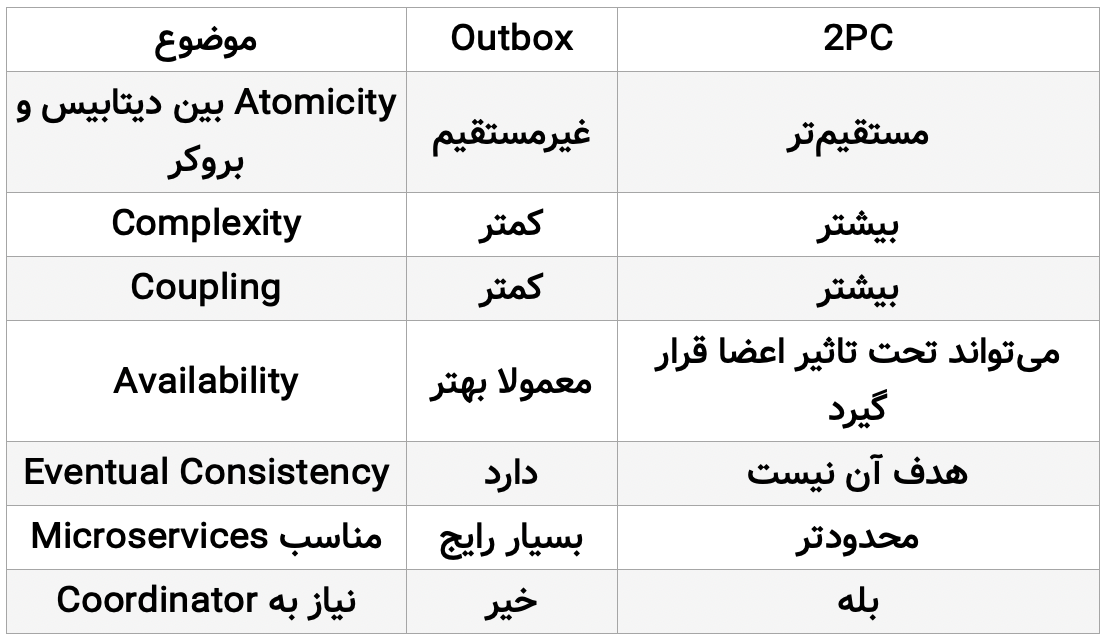
Outbox بهجای تلاش برای ساختن یک Transaction سراسری، Transaction را در محدودهی یک دیتابیس قرار میدهد.
روش ساده:
UPDATE DB
   ↓
PUBLISH EVENT
مزایا:
ساده
کمهزینه
Latency پایین
معایب:
Dual Write
احتمال Lost Event
Failure Window
روش Outbox:
UPDATE DB
   +
INSERT OUTBOX
   ↓
COMMIT
   ↓
PUBLISH ASYNC
مزایا:
Reliability بالاتر
Retry قابلیت
عدم Lost Event در Failureهای معمول بین Commit و Publish
معایب/هزینهها:
افزایش Complexity
Duplicate Handling
Operational Overhead
بنابراین اگر Event واقعا حیاتی نیست، Outbox همیشه بهترین انتخاب نیست.
برای نمونه اگر Eventها فقط برای تحیلیهای آماری غیرحیاتی استفاده میشوند و از دست رفتن درصد بسیار کوچکی از آنها قابل قبول است، ممکن است حفظ سادگی معماری ارزش بیشتری داشته باشد.
خیر.
یکی از سوءبرداشتهای رایج این است که Outbox فقط مخصوص مایکروسرویسها است. در یک Monolith نیز ممکن است نیاز داشته باشید بعد از تغییر دیتابیس، یک عملیات خارجی انجام دهید. برای نمونه:
Order Created
    ↓
Call a Webhook
یا:
User Registered
    ↓
Send Email
اگر Email Provider موقتا در دسترس نباشد، شاید نخواهید Registration را Fail کنید. میتوانید:
User
+
Email Event
را در یک Transaction ذخیره کنید و Email را بعدا ارسال کنید.
در نتیجه Outbox بیشتر از آنکه یک الگوی Microservices باشد، یک راهکار برای Asynchronous Messaging قابل اطمینان است.
معمولا وقتی Outbox ارزش زیادی پیدا میکند که:
Event از نظر Business مهم باشد.
Lost Event قابل قبول نباشد.
دیتابیس و Broker دو سیستم مستقل باشند.
سیستم Event-Driven باشد.
بین Serviceها ارتباط Asynchronous داشته باشید.
Retry و Reliability اهمیت داشته باشد.
Consistency فوری بین سرویسها ضروری نباشد.
اگر Event شما کاملا غیرحیاتی است، اضافهکردن Outbox ممکن است پیچیدگی غیرضروری ایجاد کند. برای نمونه:
User clicked button
این Event صرفا برای تحلیلهای (Analytics) تقریبی استفاده میشود. اگر از دست رفتن بعضی Eventها قابل قبول باشد، شاید Direct Publish یا حتی یک سیستم Analytics مستقل، انتخاب سادهتری باشد.
۱. Event ID یکتا داشته باشید. هر Event باید یک ID پایدار داشته باشد:
event_id = UUID
این ID برای Deduplication بسیار مهم است.
۲. Consumerها را Idempotent طراحی کنید
فرض کنید:
OrderPaid
دو بار دریافت شود. نتیجه نباید چنین چیزی باشد:
Payment = Payment × 2
Consumer باید بتواند Duplicate بودن را تشخیص دهد.
۳. Outbox را Index کنید. اگر از روش Polling استفاده میکنید، کوئریهایی مانند:
WHERE processed_at IS NULL ORDER BY created_at
باید با توجه به حجم و الگوی دسترسی مناسب Index شوند.
۴. Batch Processing را در نظر بگیرید
بهجای:
1 Event → 1 Query
ممکن است:
100 Events → 1 Batch
بهتر باشد. اما Batch بزرگ نیز میتواند Lock، Memory یا Retry Cost را افزایش دهد.
۵. Retry با Backoff
اگر Broker در دسترس نیست، نباید در هر میلی ثانیه درخواست جدید بفرستید. برای نمونه:
1s
2s
4s
8s
16s
...
به همراه محدودیت و سیاست مناسب Retry.
۶. Dead Letter را فراموش نکنید
ممکن است رویدادی داشته باشید که همیشه Fail شود. اگر بدون محدودیت Retry کنید:
Event
 ↓
Fail
 ↓
Retry
 ↓
Fail
 ↓
Retry
 ↓
...
یک Retry Storm ایجاد میشود. بنابراین باید برای Eventهای مشکلدار Strategy مشخصی داشته باشید.
یکی از Metricهای مهم در Outbox، تعداد Eventهای در انتظار انتشار است. برای نمونه:
Outbox Pending Events = 12
اما اگر:
Outbox Pending Events = 2,000,000
باشد، یعنی Publisher احتمالا عقب افتاده.
Metricهای مفید میتوانند شامل این موارد باشند:
Outbox Backlog
Publish Latency
Publish Failure Rate
Retry Count
Oldest Unprocessed Event Age
Consumer Lag
Dead Letter Count
مخصوصا:
Oldest Unprocessed Event Age
میتواند Metric بسیار ارزشمندی باشد. برای نمونه اگر قدیمیترین Event پردازشنشده:
Age = 45 minutes
باشد، حتی اگر تعداد Eventهای Pending کم باشد، احتمالا یک مشکل عملیاتی وجود دارد.
Outbox شما را مجبور میکند یک واقعیت مهم در سیستمهای توزیعشده را بپذیرید:
همهچیز قرار نیست بلافاصله Consistent باشد.
ممکن است:
T0:
Order Created

T0 + 20ms:
Outbox Published

T0 + 50ms:
Inventory Updated

T0 + 100ms:
Notification Sent
پس در فاصلهای کوتاه:
Order Service → CREATED
Inventory Service → قبلی State هنوز
این الزاما Bug نیست. اگر نیازمندی Business شما اجازهی چنین تاخیری را میدهد، Eventual Consistency میتواند یک Trade-off کاملا منطقی باشد.
در معماریهای Event-Driven، این موضوع یکی از پایههای مهم طراحی است. Microsoft نیز در راهنمای معماری خود تاکید میکند که در چنین معماریهایی باید Duplication، Ordering و Idempotency را آگاهانه طراحی کرد.
Outbox Pattern راهکاری برای حل یکی از مشکلات کلاسیک سیستمهای توزیعشده یعنی Dual Write Problem است. بهجای اینکه اپلیکیشن همزمان:
Database
+
Message Broker
را تغییر دهد، تغییر Business State و Event را در یک Transaction محلی ذخیره میکند:
Database
├── Business Data
└── Outbox Event
و بعد، یک Process مستقل Event را به Broker منتقل میکند.
مزیت اصلی این رویکرد این است که اگر Transaction اصلی Commit شود، Event مربوط به آن نیز ذخیره شده است و میتوان ارسال آن را Retry کرد.
اما Outbox پایان ماجرا نیست. شما همچنان باید با مواردی مثل:
پیامهای Duplicate
Idempotency
Ordering
Eventual Consistency
Retry
Outbox Growth
Monitoring
Cleanup
کنار بیایید.
اگر Lost Event برای سیستم شما غیرقابلقبول باشد، اما چند ثانیه Eventual Consistency قابلتحمل باشد، آیا حاضر هستید پیچیدگی مربوط به Outbox، Retry و Idempotency را به معماری اضافه کنید ؟ یا در چه نقطهای ترجیح میدهید سادگی معماری را به Reliability بالاتر ترجیح دهید ؟
برای مطالعهی عمیقتر، این منابع پیشنهاد میشوند:
Transactional Outbox در Microservices.io: توضیح رسمی Chris Richardson دربارهی مساله، اجزای Pattern، مزایا، محدودیتها و Message Relay.
AWS Prescriptive Guidance — Transactional Outbox: بررسی Dual Write، Outbox Table، CDC، Duplicate Message و Idempotency.
Debezium Documentation — Outbox Event Router: مستندات رسمی برای پیادهسازی Outbox با CDC و Transaction Log.
Microsoft Azure Architecture Center: نمونهی پیادهسازی Transactional Outbox و استفاده از Change Feed و Message Bus.
مقالهی The Outbox Pattern: A Love Letter to Eventual Consistency برای نگاه مفهومی و بررسی Polling، CDC، Idempotency، Ordering و مقایسه با Saga و Event Sourcing.

