
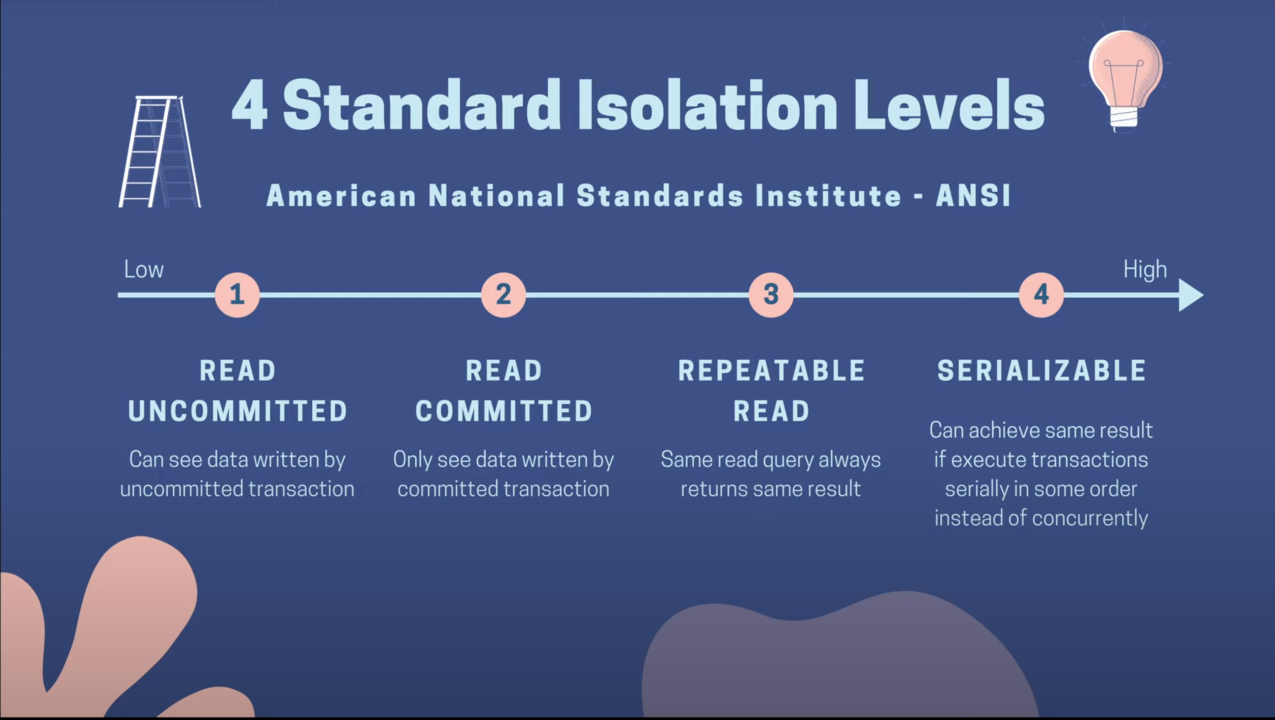
دو تراکنش، یک داده، یک سوال: چه کسی برنده میشود ؟ وقتی چند کاربر همزمان سراغ یک رکورد میروند، MySQL چطور تصمیم میگیرد چه چیزی را ببینند و چه چیزی را قفل کنند ؟ پاسخ این سوال در Transaction Isolation و بهخصوص رفتار InnoDB نهفته است.
فرض کنید در یک فروشگاه اینترنتی فقط یک عدد از یک محصول باقی مانده است. در همان لحظه دو کاربر روی دکمهی «خرید» کلیک میکنند. هر دو درخواست تقریبا همزمان میرسند و هر دو این سوال را از دیتابیس میپرسند:
SELECT stock FROM products WHERE id = 10;
اگر هر دو جواب بگیرند:
stock = 1
حالا چه اتفاقی میافتد ؟ آیا هر دو میتوانند محصول را بخرند ؟
اگر پاسخ «بله» باشد، چه کسی مسئول اشتباه است ؟ کد اپلیکیشن ؟ دیتابیس ؟ یا نحوهی مدیریت Transactionها ؟
اینجاست که مفهومی به نام Transaction Isolation Level وارد بازی میشود.
نکتهی جالب این است که انتخاب Isolation Level فقط یک انتخاب بین «سریع» و «کند» نیست؛ بلکه مشخص میکند وقتی چند تراکنش همزمان با یک داده کار میکنند، هر تراکنش دقیقا چه چیزی را ببیند و چه چیزی را نبیند.
قبل از اینکه سراغ Isolation Level برویم، باید یک قدم عقبتر برگردیم. چرا باید کوئریهای دیتابیس را داخل Transaction قرار دهیم ؟
فرض کنید هنگام خرید محصول، قرار است این چند کار همزمان انجام شوند:
۱. موجودی محصول بررسی شود.
۲. موجودی یک عدد کاهش پیدا کند.
۳. سفارش ایجاد شود.
۴. مبلغ سفارش ثبت شود.
۵. وضعیت سفارش تغییر کند.
اگر مرحلهی دوم موفق شود ولی مرحلهی سوم شکست بخورد، چه اتفاقی میافتد ؟
ممکن است موجودی محصول کم شده باشد، اما هیچ سفارشی برای مشتری ایجاد نشده باشد. یعنی دیتابیس وارد یک وضعیت ناقص شده است.
Transaction برای حل چنین مشکلاتی به وجود آمده است. بهصورت ساده Transaction یعنی:
این مجموعه عملیات را بهعنوان یک واحد منطقی در نظر بگیر؛ یا همهی آنها موفق شوند، یا تغییرات را برگردان.
برای نمونه:
START TRANSACTION;
UPDATE products SET stock = stock - 1 WHERE id = 10;
INSERT INTO orders (product_id, user_id) VALUES (10, 1001);
COMMIT;
اگر مشکلی پیش بیاید:
ROLLBACK;
در نتیجه Transaction یکی از پایههای اصلی مفهوم ACID است.
حرف I در ACID همان Isolation است. Isolation مشخص میکند تراکنشهای همزمان تا چه اندازه از تغییرات یکدیگر آگاه باشند.
طبق مستندات MySQL ،InnoDB هر چهار Isolation Level استاندارد SQL را پشتیبانی میکند و مقدار پیشفرض آن REPEATABLE READ است. اما این چهار سطح دقیقاً چه تفاوتی با هم دارند ؟
فرض کنید دو MySQL Transaction داریم:
Transaction A
Transaction B
هر دو تقریباً همزمان در حال خواندن و تغییر دادههای دیتابیس هستند.
Isolation Level تعیین میکند Transaction A هنگام کار کردن، چه مقدار از تغییرات Transaction B را ببیند.
در MySQL/InnoDB چهار سطح اصلی داریم:
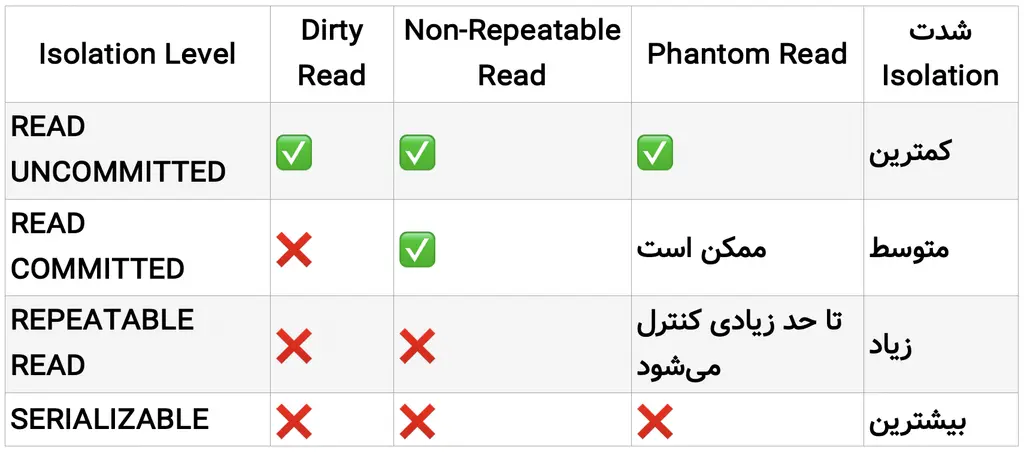
اما جدول بالا فقط شروع ماجراست چون تفاوت واقعی زمانی مشخص میشود که دو MySQL Transaction را همزمان اجرا کنیم.
بیایید از ضعیفترین سطح شروع کنیم. در READ UNCOMMITTED یک Transaction میتواند تغییراتی را ببیند که Transaction دیگری هنوز COMMIT نکرده است. یعنی «حتی اگر تغییر هنوز نهایی نشده، ممکن است آن را ببینی.»
این همان چیزی است که به آن Dirty Read میگوییم. برای نمونه فرض کنید موجودی محصول برابر است با:
stock = 10
Transaction A شروع میشود:
START TRANSACTION;
UPDATE products SET stock = 0 WHERE id = 10;
اما هنوز:
COMMIT;
انجام نشده است. حالا Transaction B اجرا میشود:
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
START TRANSACTION;
SELECT stock FROM products WHERE id = 10;
Transaction B مقدار 0 را میبیند در حالی که Transaction A هنوز تغییر خود را Commit نکرده است.
حالا اگر Transaction A تصمیم بگیرد رولبک کند (ROLLBACK) موجودی دوباره برابر با ۱۰ میشود.
پس Transaction B چیزی را دیده که در نهایت اصلا در دیتابیس باقی نمانده است، که به آن Dirty Read میگوییم.
مستندات InnoDB هم READ UNCOMMITTED را سطحی معرفی میکند که در آن Readها میتوانند از نسخهی قبلی/ناسازگار داده استفاده کنند و ممکن است Dirty Read رخ دهد.
مزیت این سطح چیست ؟
مزیت اصلی این سطح، سرعت و کاهش محدودیتهای Isolation است. برای نمونه اگر کوئری ما فقط گزارشی تقریبی از دادهها میخواهد و Consistency کامل اهمیت ندارد، این سطح عملکرد بهتری ارائه میدهد.
مشکل کجاست ؟
ممکن است دادهای را بخوانید که هرگز Commit نشود. برای عملیات حساس مثل: پرداخت، سفارش، موجودی، حساب بانکی، رزرو صندلی و… این رفتار معمولا قابل قبول نیست. در نتیجه READ UNCOMMITTED را میتوان اینطور به خاطر سپرد:
سریعتر و آزادتر، اما بدون تضمین اینکه چیزی که میبینی واقعا نهایی شده باشد.
حالا یک قدم جلوتر بریم. در READ COMMITTED دیگر Dirty Read نداریم. یعنی Transaction فقط دادههایی را میبیند که Transactionهای دیگر Commit کردهاند.
برای نمونه:
Transaction A:

UPDATE stock = 0
    |
    | هنوز کامیت نشده
    ↓
Transaction B:

SELECT stock
Transaction B مقدار تغییر داده نشده و فقط Commit شده را میبیند، نه مقدار موقتی Transaction A را.
اما یک نکتهی بسیار مهم:
در READ COMMITTED، هر Consistent Read میتواند Snapshot جدیدی داشته باشد. یعنی اگر یک Transaction یک Query را چند بار اجرا کند، ممکن است هر بار نتیجهی متفاوتی بگیرد؛ چون ممکن است Transaction دیگری بین این اجراها، داده را تغییر داده و آن را Commit کرده باشد.
منظور از Consistent Read، خواندن داده بر اساس یک Snapshot مشخص از دیتابیس است؛ بنابراین تغییرات Commit شدهی بعدیِ تراکنشهای دیگر لزوما در همان Transaction دیده نمیشوند.
برای نمونه فرض کنید:
stock = 10

Transaction A:

SET TRANSACTION ISOLATION LEVEL READ COMMITTED;
START TRANSACTION;
SELECT stock FROM products WHERE id = 10;
نتیجه:
10
حالا Transaction B:
START TRANSACTION;
UPDATE products SET stock = 5 WHERE id = 10;
COMMIT;
Transaction A دوباره کوئری میزند:
SELECT stock FROM products WHERE id = 10;
این Transaction A مقدار 5 را میبیند.
پس یک Transaction، در دو نقطهی زمانی مختلف، برای یک کوئری مشابه نتایج متفاوتی گرفته است. این همان چیزیست که به آن Non-Repeatable Read میگوییم.
چرا READ COMMITTED میتواند انتخاب خوبی باشد ؟
در سیستمهایی که دادهها دائما تغییر میکنند، دیدن Snapshot تازهتر میتواند مفیدتر باشد. برای نمونه سیستمهای گزارشگیری، سیستمهای پرترافیک، برخی سرویسهای OLTP، برنامههایی که نمیخواهند یک Transaction مدت زیادی به یک Snapshot قدیمی متکی باشد.
اما باید توجه کنیم که در این سطح، یک Transaction ممکن است در هر Query دادههای جدیدتری ببیند؛ بنابراین لزوما در تمام مدت اجرای خود یک تصویر ثابت از دیتابیس ندارد.
از طرف دیگر در این سطح هنگام اجرای UPDATE ،DELETE یا READ همراه با قفل، InnoDB فقط رکوردهایی را که با شرط جستوجو مطابقت دارند قفل میکند و از قفلکردن فاصلههای خالی بین آنها (Gap Lock) صرفنظر میکند. بنابراین، Transaction دیگری میتواند در همان محدوده رکورد جدیدی درج کند. در نتیجه اگر Transaction اول همان محدوده را دوباره بررسی کند، ممکن است رکورد تازهدرجشده را نیز ببیند و نتیجهی کوئری نسبت به اجرای قبلی تغییر کند.
در نتیجه READ COMMITTED را اینطور به خاطر بسپارید:
Dirty Read نداریم، اما دیتایی که در طول Transaction میبینیم میتواند تازهتر شود.
REPEATABLE READ سطح پیشفرض Isolation در InnoDB است. اسم آن تقریبا همهچیز را توضیح میدهد: اگر در یک Transaction دادهای را بخوانی، Readهای بعدی همان Transaction میتوانند همان Snapshot را ببینند. فرض کنید:
stock = 10

Transaction A:

SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
START TRANSACTION;
SELECT stock FROM products WHERE id = 10;
نتیجه: 10
حالا Transaction B مقدار را تغییر میدهد:
START TRANSACTION;
UPDATE products SET stock = 5 WHERE id = 10;
COMMIT;
Transaction A دوباره:
SELECT stock FROM products WHERE id = 10;
در یک Consistent Read معمولی، Transaction A همچنان Snapshot خودش را میبیند، یعنی 10، نه 5.
طبق مستندات MySQL، در REPEATABLE READ، Consistent Readهای داخل یک Transaction از Snapshot ایجادشده توسط اولین Read استفاده میکنند.
اما اینجا یک نکتهی بسیار مهم وجود دارد!
تا اینجا تصور بر این است که: «در REPEATABLE READ هر کوئری داخل Transaction همیشه همان داده را میخواند»، اما این تعریف دقیق نیست، چون بین SELECT معمولی و SELECT ... FOR UPDATE تفاوت مهمی وجود دارد.
SELECT معمولی یک Consistent Read است، اما SELECT ... FOR UPDATE یک Locking Read است.
SELECT معمولی داده را از Snapshot تراکنش میخواند؛ یعنی ممکن است نسخهای قدیمیتر از داده را ببینید.
اما SELECT ... FOR UPDATE برای تغییر داده استفاده میشود و وضعیت فعلی رکورد را میخواند و همزمان آن را قفل میکند تا تراکنش دیگری نتواند قبل از پایان تراکنش شما، آن را تغییر دهد.
این تفاوت برای طراحی سیستمهای واقعی فوقالعاده مهم است.
حالا برگردیم به همان فروشگاه اینترنتی. فرض کنید فقط یک محصول باقی مانده:
product_id = 10
stock = 1
دو مشتری تقریباً همزمان خرید میکنند.
اگر کد ما چیزی شبیه این باشد:
START TRANSACTION;
SELECT stock FROM products WHERE id = 10;
-- Check if stock is greater than 0 in application code
UPDATE products SET stock = stock - 1 WHERE id = 10;
INSERT INTO orders (...);
COMMIT;
ممکن است دو Transaction همزمان مقدار 1 را ببینند و هر دو فکر کنند محصول موجود است، و بعد هر دو بخواهند موجودی را کاهش دهند.
اینجاست که فقط انتخاب Isolation Level کافی نیست. ما باید عملی که قرار است روی داده انجام دهیم را نیز به شکل صحیح طراحی کنیم.
راه حل: استفاده از SELECT ... FOR UPDATE. در چنین سناریویی یکی از الگوهای رایج استفاده از SELECT ... FOR UPDATE است.
برای نمونه:
START TRANSACTION;
SELECT stock FROM products WHERE id = 10 FOR UPDATE;
این کوئری یک Locking Read است.
InnoDB رکوردهای پیداشده را قفل میکند و Transaction دیگری که بخواهد همان رکورد را برای تغییر یا Lock مشابه در اختیار بگیرد، باید منتظر بماند تا Transaction اول COMMIT یا ROLLBACK کند.
حالا فرض کنیم Transaction A زودتر به محصول برسد.
Transaction A:

SELECT ... FOR UPDATE

-> Product #10 locked and stock is 1

UPDATE stock = 0
INSERT order
COMMIT;

-> Unlock
در همین زمان Transaction B وقتی بخواهد:
SELECT stock FROM products WHERE id = 10 FOR UPDATE;
را اجرا کند، باید منتظر آزاد شدن Lock بماند.
بعد از Commit شدن Transaction B، Transaction A میتواند وضعیت جدید را بررسی کند. اگر موجودی صفر باشد، دیگر نباید سفارش دوم ایجاد شود.
یک پیادهسازی ساده برای خرید:
برای نمونه:
START TRANSACTION;
SELECT stock FROM products WHERE id = 10 FOR UPDATE;
در Application:
if stock > 0:
    continue purchase
else:
    reject purchase
سپس:
UPDATE products SET stock = stock - 1 WHERE id = 10;
INSERT INTO orders (product_id, user_id) VALUES (10, 1001);
COMMIT;
نکتهی مهم این است که SELECT ... FOR UPDATE باید داخل همان Transaction باشد. Lockهای ایجادشده توسط FOR UPDATE با COMMIT یا ROLLBACK آزاد میشوند.
آیا REPEATABLE READ جلوی همهی Race Conditionها را میگیرد ؟
خیر. Isolation Level بهتنهایی جایگزین طراحی صحیح Transaction نیست. ممکن است Isolation Level مناسبی انتخاب کرده باشید، اما اگر عملیات Read → Check → Update شما بدون Lock مناسب انجام شود و همچنان با Race Condition مواجه شوید.
به همین دلیل باید بین این دو مفهوم تفاوت بگذاریم:
Isolation: مشخص میکند Transaction چه چیزی را از تغییرات سایر Transactionها ببیند.
Locking: مشخص میکند چه کسی حق دارد همزمان دادهی خاصی را تغییر دهد یا Lock کند.
در سناریوهایی مانند موجودی کالا، رزرو ظرفیت یا تخصیص منابع، این تفاوت حیاتی است.
حالا میرسیم به قویترین سطح Isolation. اسم SERIALIZABLE یک ایدهی مهم را منتقل میکند:
رفتار Transactionهای همزمان تا حد ممکن شبیه این است که یکییکی اجرا شدهاند.
در InnoDB، سطح SERIALIZABLE نسبت به REPEATABLE READ سختگیرانهتر است. در این حالت حتی کوئریهای READ معمولی هم ممکن است دادهها را قفل کنند؛ بنابراین تراکنشهای همزمان بیشتر منتظر یکدیگر میمانند و سرعت و همزمانی سیستم کاهش پیدا میکند.
در نتیجه:
Consistency ↑
Concurrency ↓
یعنی هرچه Isolation را قویتر کنیم، معمولا فضای کمتری برای اجرای آزادانهی Transactionهای همزمان باقی میماند.
چرا همهچیز را SERIALIZABLE نکنیم ؟
اگر SERIALIZABLE بیشترین سطح Isolation را فراهم میکند، چرا همه جا از آن استفاده نکنیم ؟
چون سیستم واقعی فقط به Consistency نیاز ندارد. ما Performance و Concurrency هم میخواهیم.
تصور کنید هزاران کاربر همزمان در حال خرید هستند. اگر تعداد زیادی Transaction مجبور شوند منتظر Lockهای یکدیگر بمانند:
Transaction A

      ↓

    LOCK

      ↓

Transaction B → WAIT

      ↓

Transaction C → WAIT

      ↓

Transaction D → WAIT
در نتیجه Throughput سیستم کاهش پیدا میکند. بنابراین هدف این نیست که همیشه بیشترین Isolation را انتخاب کنیم. هدف این است که کمترین Isolation Levelی را انتخاب کنیم که نیاز Consistency و Business Logic ما را بهدرستی برآورده کند.
حالا چهار سطح را کنار هم ببینیم:
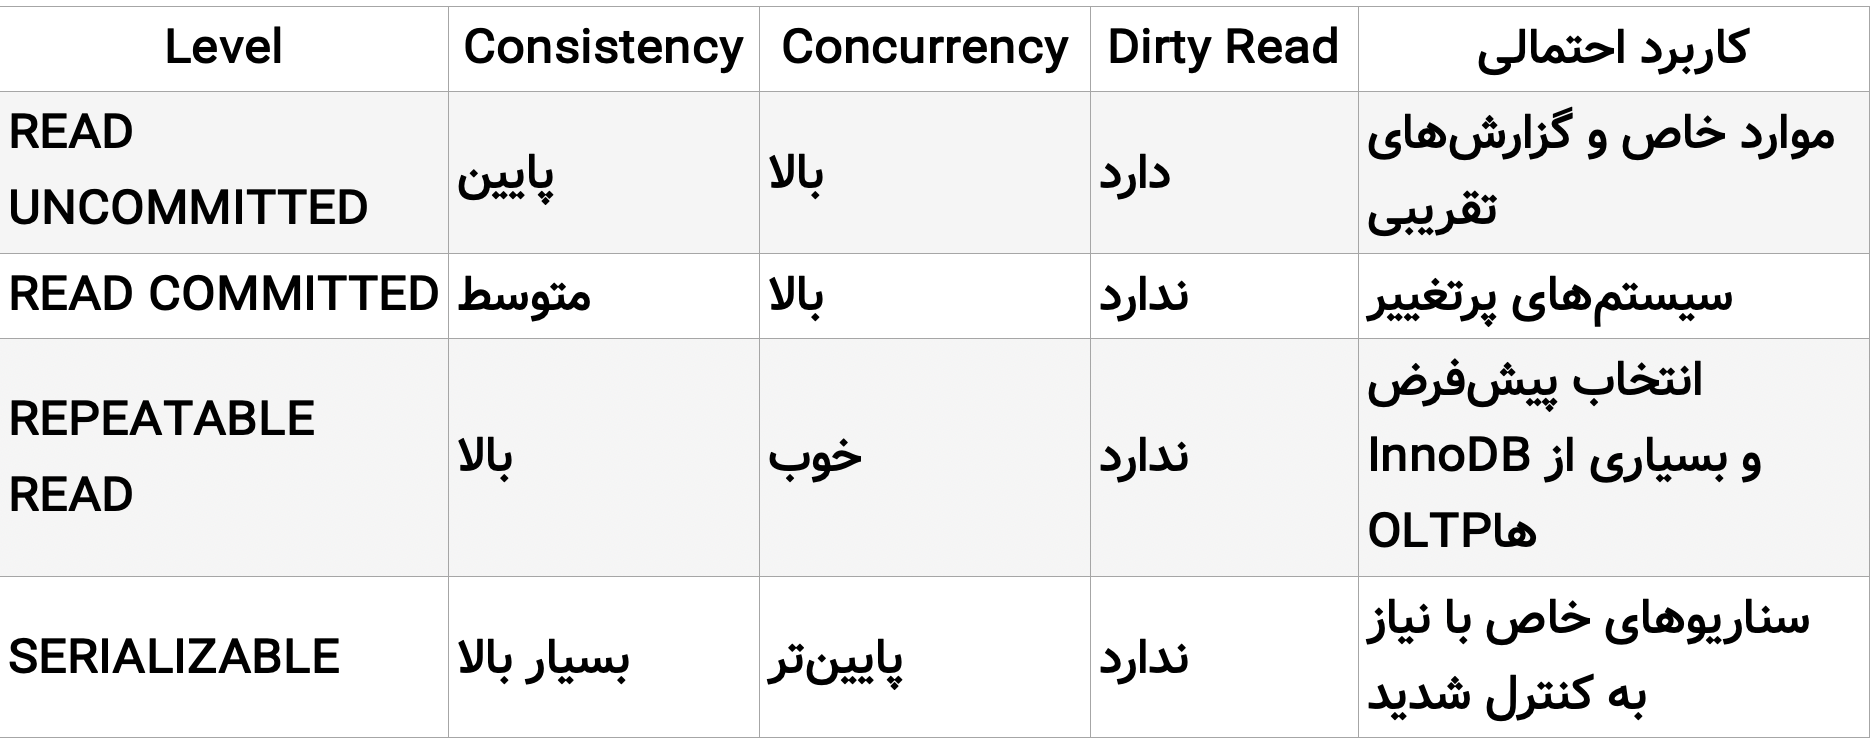
البته این جدول را نباید به شکل یک قانون مطلق در نظر گرفت. Performance واقعی به موارد بسیار بیشتری وابسته است: نوع Query، Indexها، تعداد Transactionهای همزمان، مدت زمان Transaction، تعداد Rowهای Lock شده، الگوی دسترسی به داده، Hot Rowها، طراحی Application، حجم داده و ...
وقتی درباره Lock صحبت میکنیم، یک سوال طبیعی به وجود میآید: «آیا Lock یعنی احتمال Deadlock ؟»
بله، ممکن است. فرض کنید:
Transaction A:

Lock Row 1
↓
Wait for Row 2
و همزمان:
Transaction B:

Lock Row 2
↓
Wait for Row 1
حالا:
A → منتظر B
B → منتظر A
هیچکدام نمیتوانند جلو بروند. این یک Deadlock است. Deadlock لزوما به معنی بد بودن Isolation Level نیست. MySQL نیز تاکید میکند که Deadlock میتواند زمانی اتفاق بیفتد که Transactionها Rowها یا Rangeهای مختلف را در ترتیب متفاوت Lock کنند. همچنین مستندات تصریح میکنند که احتمال Deadlock مستقیما با Isolation Level تعیین نمیشود؛ Deadlock بیشتر به نحوهی انجام Writeها و Lockها مربوط است.
۱. Transaction را کوتاه نگه دارید. این:
BEGIN
↓
SELECT
↓
UPDATE
↓
COMMIT
معمولا بهتر از Transactionی است که:
BEGIN
↓
SELECT
↓
API Call
↓
Heavy Computations
↓
Network Request
↓
UPDATE
↓
COMMIT
هرچه Transaction بیشتر باز بماند، Lockها نیز ممکن است مدت بیشتری درگیر باشند.
۲. ترتیب Lock گرفتن را ثابت نگه دارید
اگر Transactionهای مختلف قرار است دو Row را Lock کنند، بهتر است همهی آنها همان ترتیب را رعایت کنند. برای نمونه همیشه:
Row A
↓
Row B
نه اینکه یک Transaction:
A → B
و دیگری:
B → A
این موضوع یکی از توصیههای رسمی MySQL برای کاهش Deadlock است.
۳. Index مناسب داشته باشید
کوئریهایی مانند:
SELECT * FROM products WHERE id = 10 FOR UPDATE;
وقتی روی ستون جستوجو Index مناسب داشته باشند، کنترل Lockها بسیار قابلپیشبینیتر میشود. MySQL نیز ایجاد Index روی ستونهایی را که در SELECT ... FOR UPDATE و UPDATE ... WHERE استفاده میکنند را از راهکارهای کاهش Deadlock میداند.
۴. Deadlock را در Application مدیریت کنید
یک تصور اشتباه این است که «اگر Deadlock رخ داد، یعنی سیستم خراب است»
نه لزوما. در سیستمهای همزمان (Concurrent)، Deadlock ممکن است رخ دهد و InnoDB میتواند یکی از Transactionها را بهعنوان Victim انتخاب و Rollback کند. Application باید در چنین شرایطی بتواند Transaction را در صورت مناسب بودن سناریو دوباره اجرا کند.
یک اشتباه رایج، Lock کردن همهچیز است. گاهی بعد از آشنایی با FOR UPDATE، وسوسه میشویم:
SELECT * FROM products FOR UPDATE;
اما این ایدهی خوبی نیست. اگر فقط قرار است یک محصول را تغییر دهیم، چرا باید تعداد زیادی Row را Lock کنیم ؟
بهتر است کوئری تا حد ممکن دقیق باشد:
SELECT stock FROM products WHERE id = 10 FOR UPDATE;
و مهمتر از آن، ستون id باید Index مناسب داشته باشد.
قاعدهی ساده:
فقط چیزی را Lock کن که واقعا لازم داری و Transaction را سریع تمام کن.
آیا همیشه باید REPEATABLE READ + FOR UPDATE استفاده کنیم ؟
خیر. اما برای سناریویی که در آن یک Row را میخوانیم، بر اساس مقدار آن تصمیم میگیریم، سپس همان Row یا دادهی وابسته را تغییر میدهیم، ترکیب:
REPEATABLE READ
+
SELECT ... FOR UPDATE
اغلب یک الگوی بسیار مناسب است. برای مثال Overselling:
START TRANSACTION;
SELECT stock FROM products WHERE id = 10 FOR UPDATE;
--- Check Stock in the Application Code
UPDATE products SET stock = stock - 1 WHERE id = 10;
INSERT INTO orders (...);
COMMIT;
FOR UPDATE باعث میشود Row موردنظر برای تغییرات همزمان Lock شود و Transaction دیگر نتواند بدون انتظار همان Row را برای تغییر، در اختیار بگیرد.
البته این کد یک نکتهی دیگر هم دارد: حتماً باید نتیجهی stock بررسی شود. یعنی اگر:
stock = 0
نباید سفارش ایجاد شود.
یک راه دیگر: شرط را داخل UPDATE بیاوریم. گاهی میتوانیم منطق را حتی Atomicتر طراحی کنیم.
برای نمونه:
UPDATE products SET stock = stock - 1 WHERE id = 10 AND stock > 0;
سپس بررسی کنیم که چند Row تغییر کرده است. اگر:
Rows affected = 1
یعنی موجودی با موفقیت کاهش یافته است.
اگر:
Rows affected = 0
یعنی محصول موجود نبوده یا شرایط Update برقرار نبوده است.
الگوی:
SELECT
↓
CHECK
↓
UPDATE
در بسیاری از سناریوها مناسب است، اما اینکه کدام الگو بهتر است به Business Logic واقعی شما بستگی دارد.
برای نمونه میتوان برای Transaction یا Session سطح Isolation را تنظیم کرد.
یعنی:
SET TRANSACTION ISOLATION LEVEL READ COMMITTED;
یا:
SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
و برای SERIALIZABLE:
SET TRANSACTION ISOLATION LEVEL SERIALIZABLE;
MySQL امکان تنظیم Isolation Level را برای Session و همچنین بهصورت پیشفرض برای Connectionهای بعدی فراهم میکند. مقدار پیشفرض InnoDB نیز REPEATABLE READ است.
در یک Application واقعی بهتر است تغییر Isolation Level کاملا آگاهانه انجام شود؛ نه صرفا برای اینکه یک کوئری کند است، سطح Isolation را پایین بیاوریم.
یک راهنمای عملی ساده:
اگر Consistency خیلی مهم نیست، ممکن است READ UNCOMMITTED مناسب باشد، اما برای عملیات حساس معمولا انتخاب مناسبی نیست.
اگر میخواهید Readها دادهی Commitشدهی جدید را ببینند READ COMMITTED میتواند گزینهی مناسبی باشد.
اگر با InnoDB کار میکنید و نیاز به Snapshot پایدار در Transaction دارید REPEATABLE READ انتخاب پیشفرض و قدرتمند InnoDB است.
اگر نیاز دارید رفتار Transactionها تا حد زیادی سریال شود SERIALIZABLE را بررسی کنید؛ اما هزینهی آن روی Database Concurrency را فراموش نکنید.
Isolation Level در واقع یک سوال ساده اما بسیار مهم است:
وقتی چند MySQL Transaction همزمان با یک داده کار میکنند، هر Transaction دقیقا چه چیزی را باید ببیند و برای چه چیزی باید منتظر بماند ؟
چهار سطح اصلی InnoDB را میتوان اینطور خلاصه کرد:
READ UNCOMMITTED: بیشترین آزادی، کمترین Isolation
READ COMMITTED: فقط دادههای Commit شده
REPEATABLE READ: اسنپشات پایدار برای Consistent Read
SERIALIZABLE: بیشترین محدودیت و کمترین Database Concurrency
و این نکته مهم که:
انتخاب Isolation Level بهتنهایی مشکل Concurrency را حل نمیکند.
اگر قرار است دادهای را بخوانید و بر اساس آن تصمیم بگیرید که همان داده را تغییر دهید، باید به Locking نیز فکر کنید.
همینطور Deadlock را نمیتوان صرفا با انتخاب یک Isolation Level «خاموش» کرد. باید Transactionها را درست طراحی کنیم، ترتیب Lock گرفتن را هماهنگ نگه داریم و در Application امکان Retry کردن Transaction شکستخورده را در نظر بگیریم.
حالا اگر در یک فروشگاه اینترنتی با این سناریو مواجه شوید:
۱۰۰۰ کاربر ↓ همزمان ↓ برای خرید آخرین 10 عدد از یک محصول
به نظرتان کدام طراحی بهتر است ؟
A) REPEATABLE READ + SELECT ... FOR UPDATE
B) READ COMMITTED + UPDATE ... WHERE stock > 0
C) SERIALIZABLE
D) Other Combination
اگر در پروژهای با Overselling، Deadlock یا مشکلات Transaction روبهرو شدهاید، خوشحال میشوم تجربهتان را در کامنتها با من به اشتراک بگذارید.
منابع برای مطالعه بیشتر
برای مطالعهی عمیقتر، مستندات رسمی MySQL بهترین نقطهی شروع هستند:
مستندات MySQL درباره Transaction Isolation Levels در InnoDB
مستندات MySQL درباره SELECT ... FOR UPDATE و Locking Reads
مستندات MySQL درباره Deadlock در InnoDB
مستندات MySQL درباره راهکارهای کاهش و مدیریت Deadlock
مستندات MySQL درباره Locking و Transaction Model در InnoDB

