
اگر بخواهیم همهی آن کارهایی که در علوم اجتماعی انجام میشود را کنار هم بگذاریم، به چنین چرخهای میرسیم:
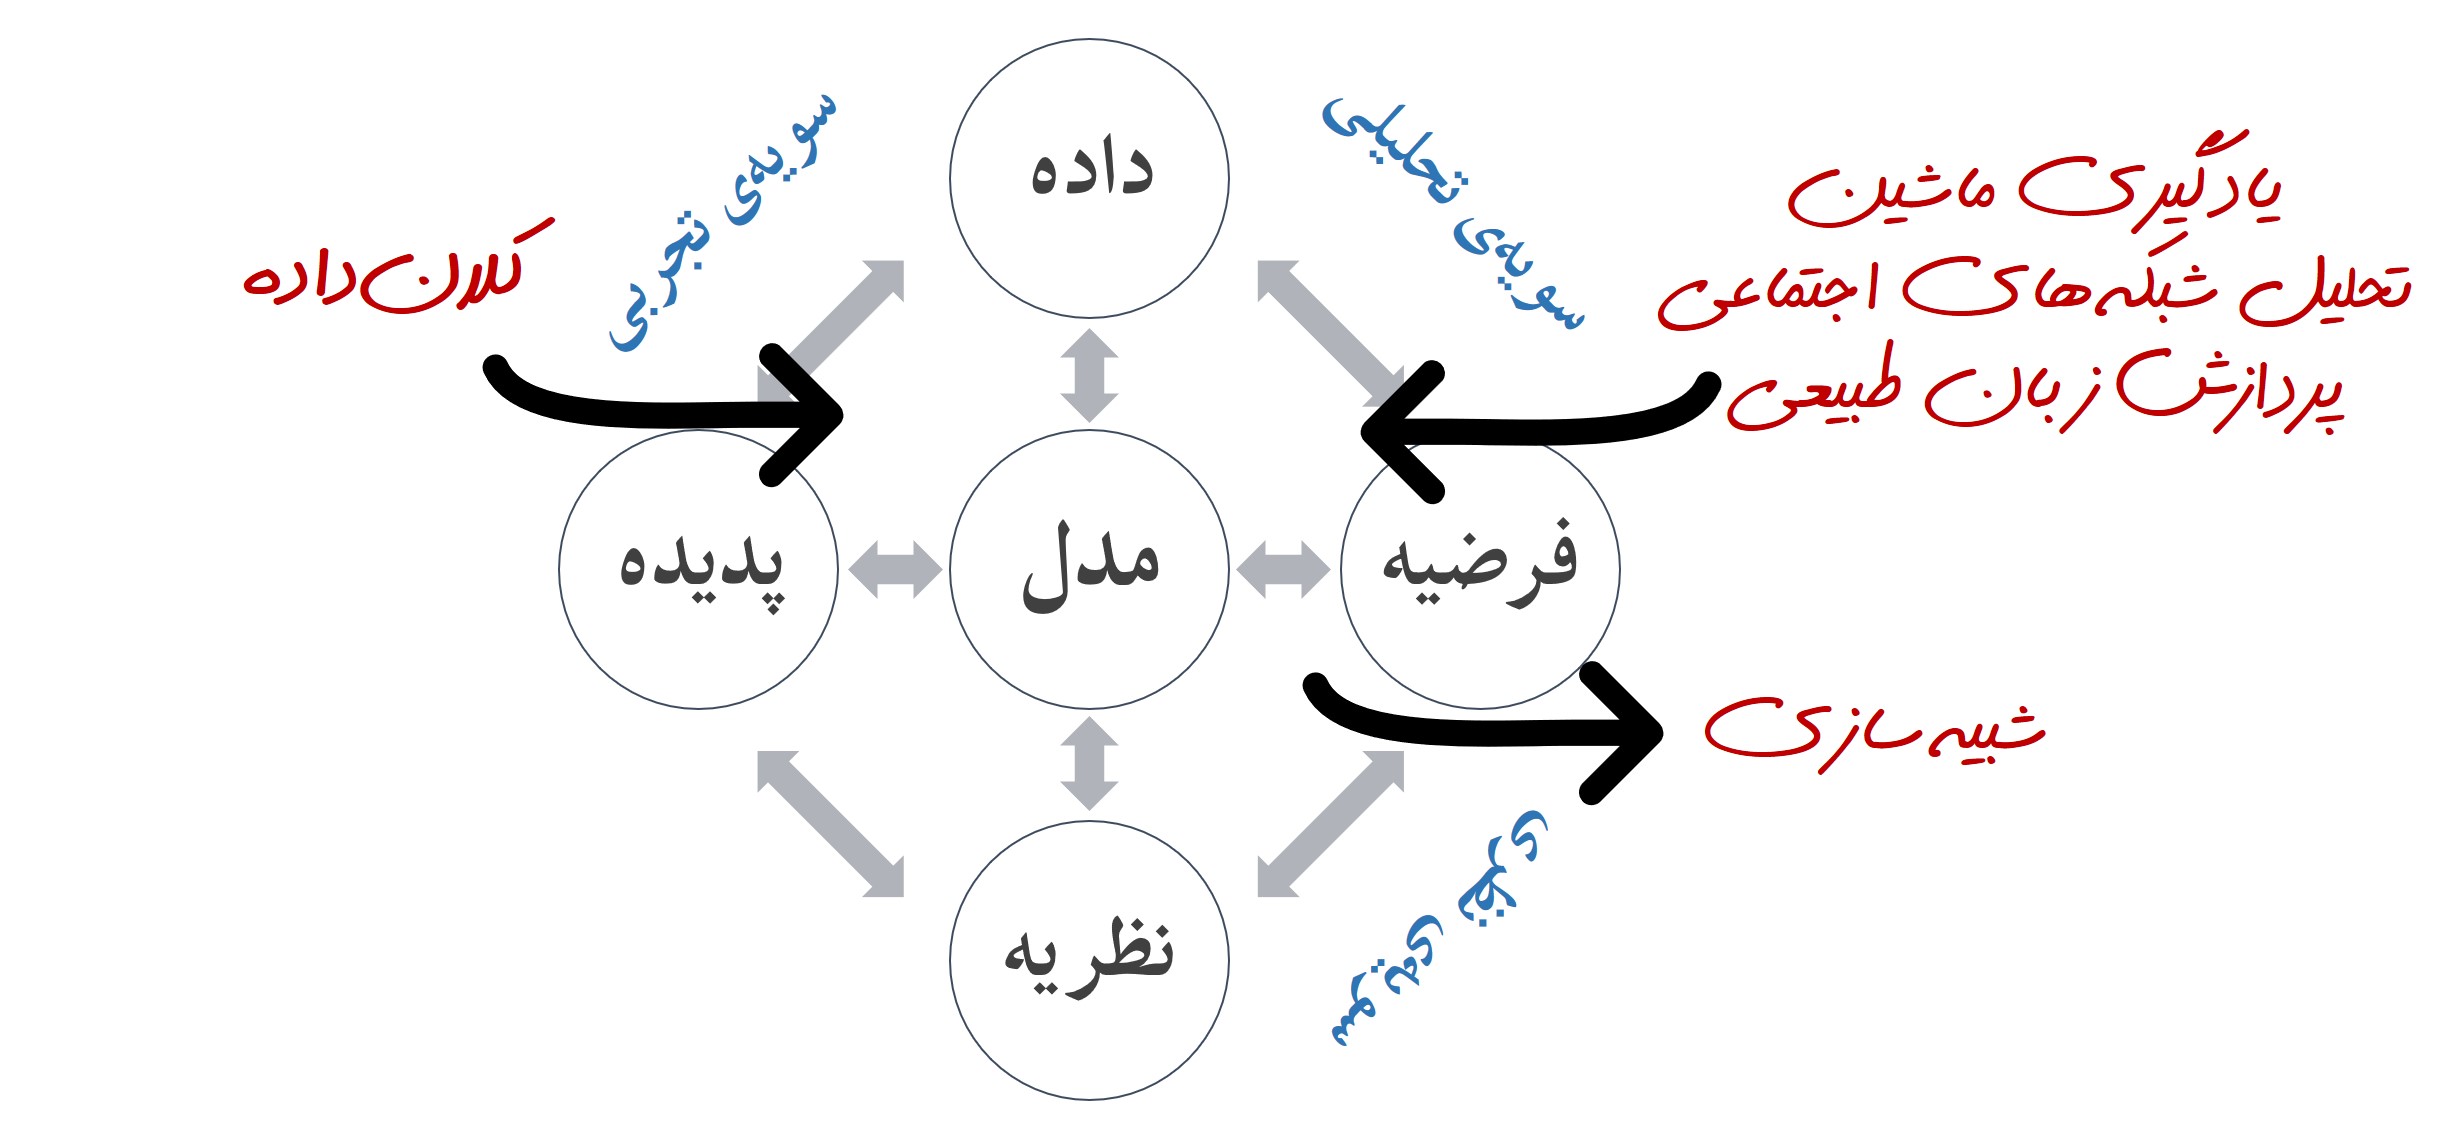
تفصیل همهی جزییات این چرخه و قواعد حاکم بر هر بخش، از حوصلهی این یادداشت خارج است و در سایر یادداشتها به صورت مختصر به آنها پرداختهام و میپردازم.
همینقدر مختصر را داشته باشید که اگر میخواهیم پژوهش اجتماعی محاسباتیمان روشمند و نتایج آن معتبر باشد، نمیتوانیم از هر گوشهی این چرخه که بخواهیم وارد شویم و از سوی دیگرش خارج شویم؛ هرچند بسیاری از مقالات و شبهپژوهشهای کنونی گرفتار این آفت شدهاند و به همین دلیل است که دچار بحران تکرارپذیری هستیم.
بر اساس این چرخه، پژوهشهای اجتماعی محاسباتی را به صورت کلی میتوانیم به سه دسته تقسیم کنیم:
برخی از این پژوهشها، تلاش میکنند دادههای مرتبط با یک پدیده (= کلانداده / دادههای انبوه / بیگدیتا) را استخراج و مدل انتزاعی مطلوبشان را طراحی کنند. این قبیل مدلها فقط میتوانند تصویری نسبتاً جزیی و دادهبنیاد از یک پدیدهی اجتماعی به ما بدهند.
این قبیل پژوهشها به جای خود مفید و کارگشا است، اما نه میتوانند گزارهی تحلیلی معتبری دربارهی پدیده بیان کنند و نه امکان نظریهپردازی بر اساس آنها وجود دارد.
گام بعدی آن است که دادههای حاصل از مرحلهی قبل یا مدل انتزاعشده از آنها را با استفاده از ابزارهایی مثل «یادگیری ماشین»، «پردازش زبان طبیعی» و «تحلیل شبکههای اجتماعی» تحلیل کنیم. خروجی این قبیل پژوهشها فرضیاتی است که میتوان بر اساس آنها دربارهی چرایی، چگونگی و چیستی پدیده حرفهایی زد که تا حدود زیادی معتبرند. اما توانایی پیشبینی تغییرات آینده (آیندهپردازی / آیندهپژوهی) را ندارد.
پژوهش گروه بلومنستاک دربارهی فقر در رواندا بر اساس مدلسازی دادههای تلفن همراه و استفاده از یادگیری ماشین نمونهی خوبی برای این مسیر است.
نمونههای موفق دیگری از «تحلیل شبکههای اجتماعی» را در آینده بررسی خواهیم کرد.
هر دادهای که ما در اختیار داریم، هرقدر هم که انبوه، لحظهای و فریبنده باشد هم «گذشته» است. یعنی ما هیچوقت هیچ دادهای از آینده (حتی یک ثانیهی آینده) نداریم و تا وقتی چنین باشد (که ظاهراً همیشه چنین خواهد بود)، هیچوقت نمیتوانیم مطمئن باشیم که مدلها و تحلیلهای دادهبنیاد ما توان پیشبینی آینده را دارند یا خیر. ما نهایتاً میتوانیم حدس بزنیم و امیدوار باشیم که حدسهایمان صحیح از آب دربیاید.
اما ما به پیشبینی آینده هم نیاز داریم. اساساً سیاستگذاری و مدیریت اجتماعی نیازمند اطمینان از پیامدهای مثبت و منفی تحلیلها در آینده است. برای این که بتوانیم با اتکا به پژوهشهای محاسباتیمان، آیندهپژوهی هم بکنیم، به «شبیهسازی» نیاز داریم.
ما جامعهی فرضیمان را با حداکثر جزییاتی که (با استفاده از مدلها، فرضیهها و دادههای گردآوریشده در مراحل قبل) از وضعیت کنونی جامعه در اختیار داریم، طراحی میکنیم. سپس برخی از متغیرها را بر اساس مسالهی پژوهشیمان تغییر میدهیم و نتیجه را مشاهده میکنیم.
نرمافزارها و فناوریهای گوناگونی برای انجام شبیهسازیهای اجتماعی وجود دارد. اما برای این که تصور دقیقتری از آن داشته باشید، میتوانید نسخهی آموزشی بازی معروف سیمسیتی (SimCityEdu) را امتحان کنید. شما در این بازی، با انجام تغییرات شهری (مثلاً تعطیل کردن نیروگاه فسیلی بزرگ شهر و احداث یک نیروگاه خورشیدی کوچک)، منتظر واکنش شهروندان باشید.
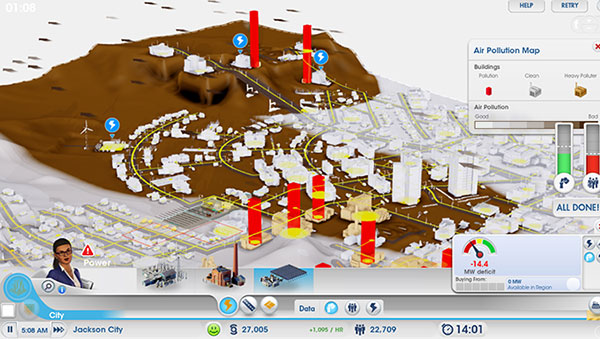
البته شبیهسازیهای واقعی و علمی اینقدرها هم ساده نیستند و انبوهی از متغیرها را باید تنظیم کرد تا موتور هوش مصنوعی بتواند واکنش عاملها (افراد، گروهها و ...) را پیشبینی کند. این نمونهای از یک نرمافزار تجاری شبیهسازی اجتماعی است که برای تحلیل رفتار مردم در زمان اشغال نظامی، آشوب و ... طراحی شده است.
خلاصه این که برای انجام هر پژوهش اجتماعی به صورت کلی و پژوهش اجتماعی محاسباتی به صورت ویژه، راههای مختلفی وجود دارد. این که کدام راه مناسبتر است را «مسالهی پژوهش»، «بودجهبندی زمانی و مالی»، «دادههای در دسترس»، «هدف پژوهش» و ... مشخص میکند. در این یادداشت چند مسیر معتبر را مرور کردم.
اما علاوه بر این سه مسیر، گاهی هم ممکن است یک پژوهشگر اجتماعی، بخواهد فقط با مراجعه به پدیده و بدون طی کردن هیچکدام از مراحل دیگر به مدلسازی و نظری برسد. این کار هم ناممکن نیست، اما یا باید به حس ششم پژوهشگر اعتماد کرد یا به تخیل قویاش. :-)

