
فرض کنید از شما میخواهند ظرف مدت کوتاهی، مثلاً یک ماه، با هزینهی اندکی، مثلاً صد میلیون تومان، نقشهی توزیع فقر و ثروت در سطح کشور را با دقت بسیار زیاد ترسیم کنید. یعنی روی نقشه نشان دهید که هر محله از نظر وضعیت اقتصادی در کجای هرم فقر و ثروت قرار میگیرد و جزو دهک چندم است. راهحل پیشنهادیتان چیست؟ به نظرتان این کار شدنی است؟
دکتر جاشوا بلومنستاک استاد دانشگاه برکلی است. او و گروه پژوهشیاش چنین پژوهشی را در کشور رواندا انجام دادند و کارشان به یکی از موفقترین و شناختهشدهترین نمونههای کاربردِ علوم اجتماعی محاسباتی تبدیل شد.
رواندا کشوری کوچک و فقیر است در شرق آفریقا که حدود سیزده میلیون نفر جمعیت دارد. حدود شصت درصد از مردم این کشور زیر خط فقر زندگی میکنند.
دکتر بلومنستاک و همکارانش دادههای ناشناسسازیشدهی یک میلیون و پانصد هزار نفر از کاربران بزرگترین شرکت تلفن همراه رواندا را دریافت کردند. این دادهها شامل سوابق تماس و پیامک مشترکان (چیزهایی مثل مدت تماس، زمان تماس، مخاطب، آنتنهای مخابرهکننده و ...) در طول زمان بود.
آنها میخواستند با تحلیل این دادهها، افرادی که ثروت بیشتری دارند را شناسایی کنند تا بتوانند با مشخص کردن موقعیت مکانی این افراد روی نقشه (با استفاده از مکان آنتنها) نقشهای از پراکندگی ثروتمندان به دست بیاورند.
برای انجام این پژوهش دو گام مهم باید برداشته میشد:
گروه ابتدا باید میفهمید که کدام بخش از دادههای تماس و پیامک افراد رابطهی مستقیمی با وضعیت اقتصادیشان دارد. ممکن است در تخمین اولیه چنین به نظر بیاید که مثلاً افراد پولدار تماس بیشتری در طول روز میگیرند یا مبلغ ماندهی اعتبار سیمکارتشان بیشتر است. این تخمینها نادرست نبود. اما باید دقیقترین شاخصها مشخص میشد.
به همین دلیل گروه با 856 نفر از افرادی که دادههای تماس و پیامکشان در اختیار بود، تماس گرفتند و با پرسیدن چند سوال تلاش کردند وضعیت اقتصادی آنها را برآورد کنند. این همان کاری است که هماکنون به شکل روزمره در بسیاری از پیمایشهای اجتماعی و اقتصادی انجام میشود.
حالا دو دسته داده در اختیار داشتند: آ) دادههای تماس و پیامک 1 میلیون و پانصد هزار نفر و ب) وضعیت اقتصادی 856 نفر از این افراد.
حالا نوبت به ماشین رسیده بود. زیرا با توجه به این که تعداد شاخصهای در دسترس برای هر فرد به حدود ده هزار عنوان میرسید، قطعاً محاسبه و مدلسازی و انتخاب مرتبطترین شاخصها به شکل دستی ممکن نبود.
پژوهشگران دادههای تماس و پیامک و وضعیت اقتصادی این 856 نفر را به یک ماشین یادگیرنده دادند تا ارتباط نحوهی تماس و پیامک هر فرد با وضعیت اقتصادی او را مشخص کند و به یک مدل برسد.
اینجا باید کمی دربارهی نحوهی یادگیری ماشین هم حرف بزنیم. پدرو دومینگو که یکی از چهرههای برجستهی این حوزه است، یادگیری ماشین را اینگونه توضیح میدهد:
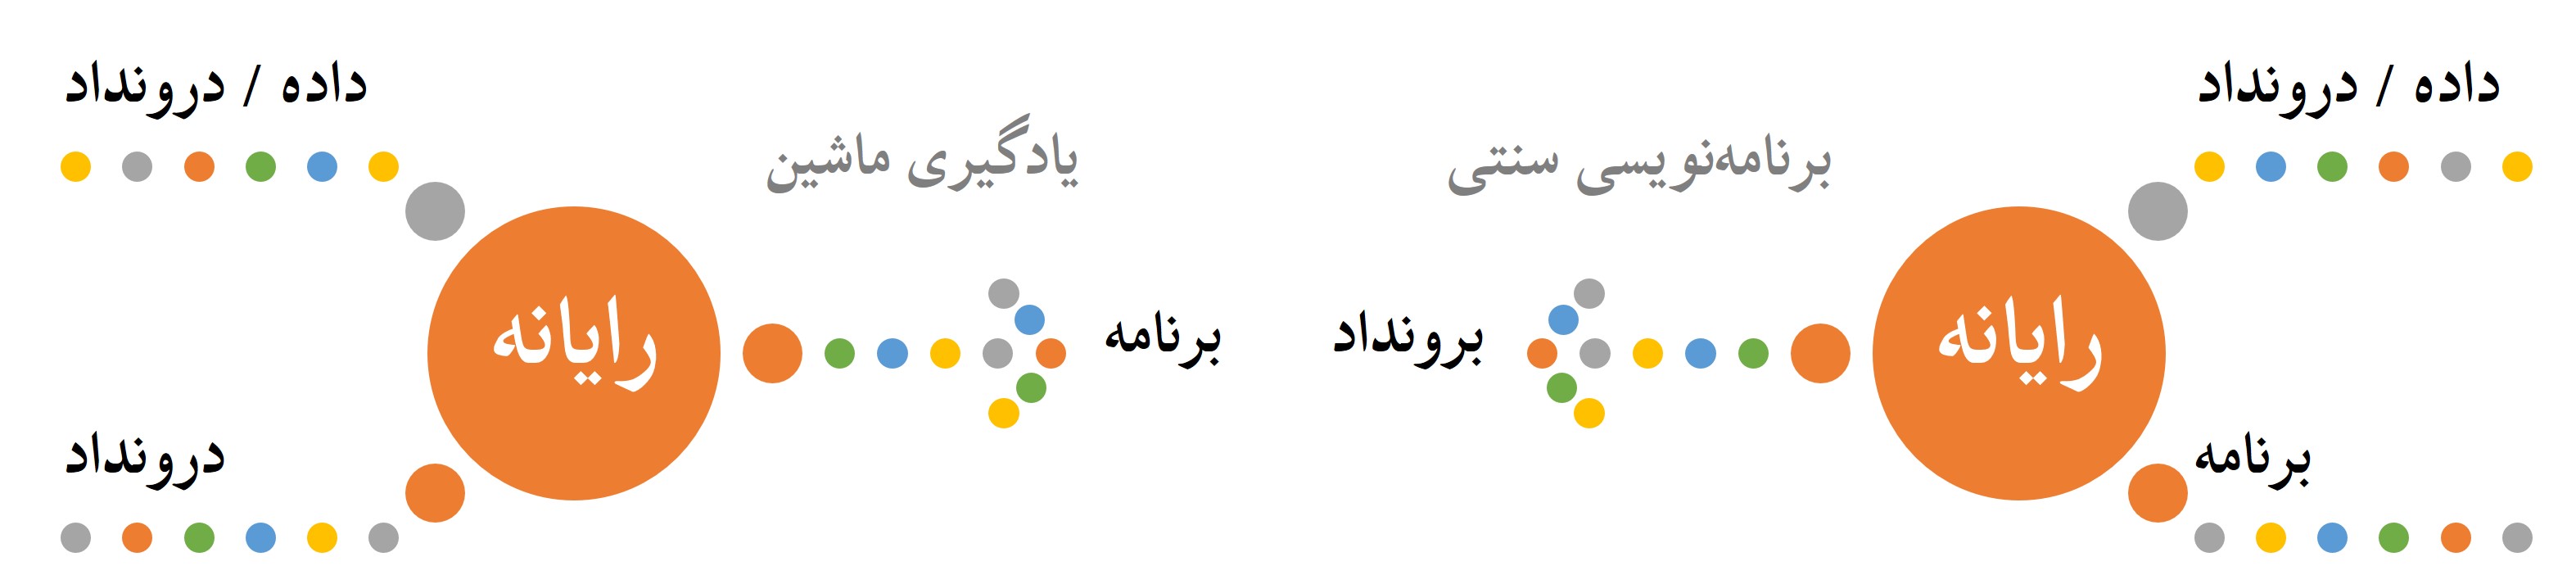
در برنامههای رایانهای به شکل سنتی (نمودار سمت راست)، برنامهنویس برنامهای که لازم دارد (مثلاً نرمافزار محاسبهی حقوق و دستمزد) را مینویسد. سپس دادههایی که در اختیار دارد (مثلاً ساعت ورود و خروج کارکنان) را به آن وارد میکند. هدف کلی این است که از ضرب و تقسیم این دادهها بر اساس برنامهی نوشتهشده، برونداد مطلوب (مثلاً میزان حقوق هر فرد) به دست بیاید.
اما در ماشینهای یادگیرنده، برنامهنویس دادههایی که در اختیار دارد را به همراه آنچه مطلوب است در نهایت به دست آورد به ماشین میدهد و از ماشین میخواهد نحوهی رسیدن از این درونداد به آن برونداد را مشخص کند. خروجی در نهایت مدلی است که قابلیت استفاده در دادههای مشابه در آینده را خواهد داشت.
گروه بلومنستاک دادههای تلفن همراه 856 را داشتند که در واقع درونداد محسوب میشد. وضعیت اقتصادی آنها را هم داشتند که در این پژوهش، همان بخش برونداد و مجهولی است که ما برای بقیهی یک میلیون و پانصد هزار نفر نیاز داریم. پس این دو را به ماشین دادند و مدلی را به دست آوردند.
نتیجه جالب بود. بر اساس محاسبات ماشین، با کنار هم گذاشتنِ شبکهای از دادههای تماس و پیامک میشد وضعیت اقتصادی فرد را پیشبینی کرد و مثلاً معنادارترین داده این بود که میانگین پیامکهای ارسالشده توسط دوستان فرد (کسانی که با آنها تماس و پیامک بیشتری دارد) در پرپیامکترین روز هفتهشان چقدر است.
همینجا باید تذکر داد که چرایی ربطِ این دو داده به یکدیگر را باید در بستر فرهنگی رواندا بررسی کرد و خودش میتواند موضوع یک پژوهش دیگر باشد. همینقدر میدانیم که نمیتوانیم عینِ همین مدل را برای کشورهای دیگر به کار ببریم. زیرا رفتار تماس و پیامک مردم کشورها یکسان نیست.
خلاصه این که با استفاده از مدلِ محاسبهشده، وضعیت اقتصادی سایر مشترکان برآورد و با توجه به موقعیت مکانی مشترک (بر اساس آنتنهای مخابراتی استفادهشده در ساعات شب) روی نقشه جانمایی شد.
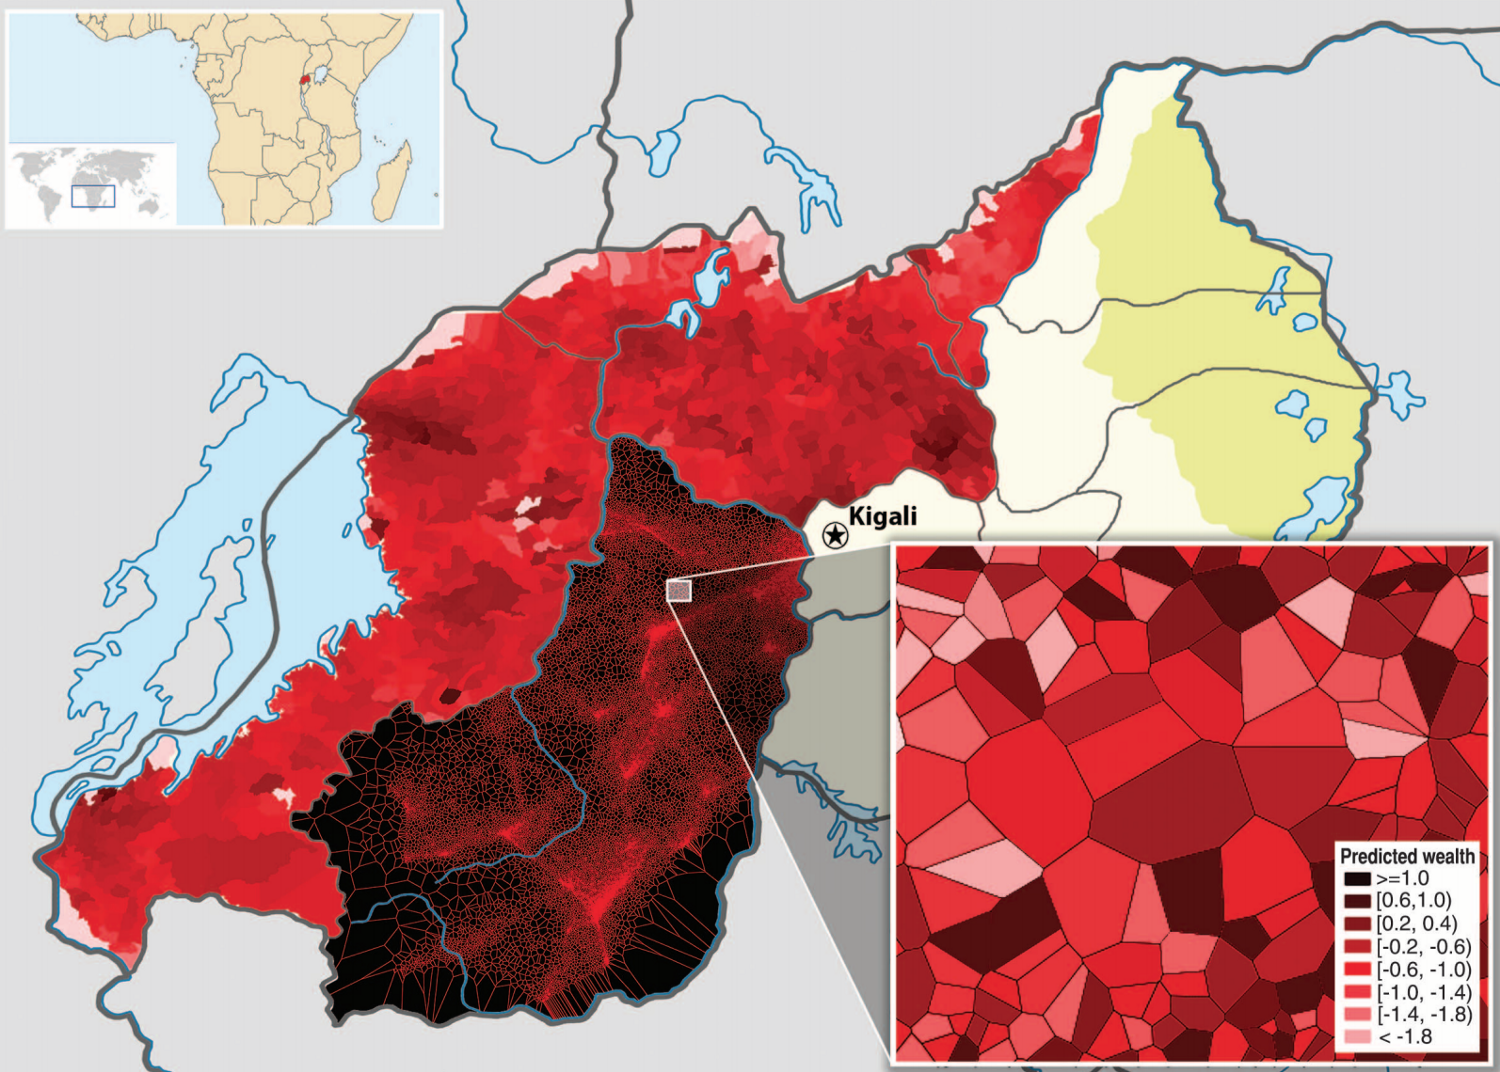
نقشه ترسیم شد. اما باید اعتبارسنجی هم میشد. یعنی باید متوجه میشدند که برآوردشان از وضعیت اقتصادی کشور چقدر واقعی است. اما هیچ منبع دادهی دیگری وجود نداشت که پراکندگی فقر را به این دقت نشان بدهد و امکان مقایسه را فراهم کند. ناچار به نتیجهی پیمایش ملیای که چند وقت پیشتر توسط دولت انجام شده بود و وضعیت اقتصادی استانهای رواندا را نشان میداد اکتفا کردند.
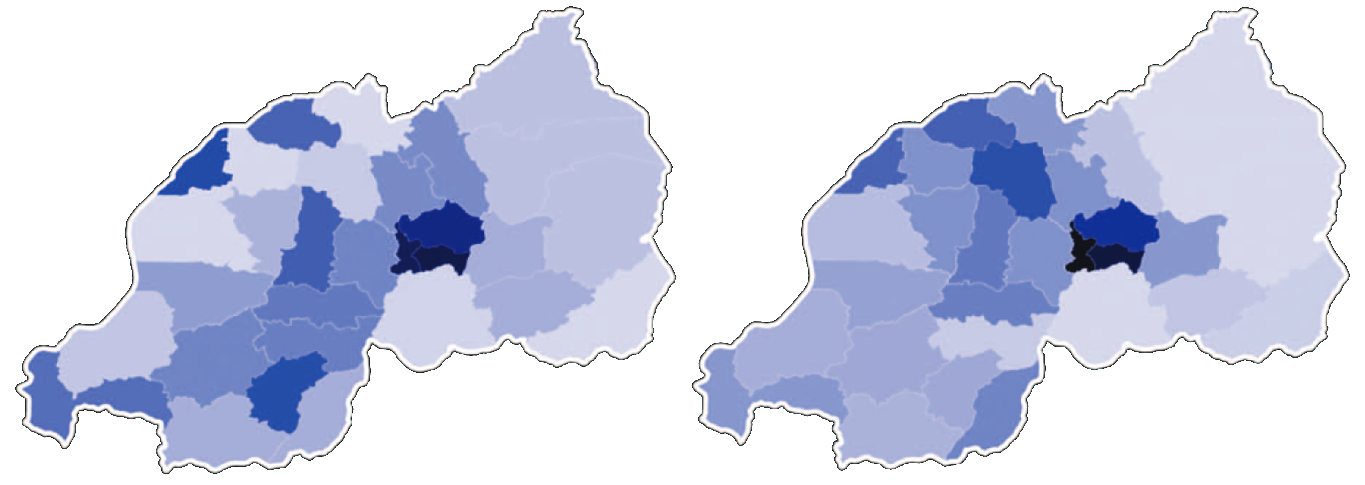
نتیجه باورکردنی نبود. گروه بلومنستاک توانسته بودند نقشهی فقر در رواندا را با دقت 92 درصد ترسیم کنند. به علاوه، کشور بر اساس نقشهی دولت به 30 استان تقسیم میشد و وضعیت نواحی کوچکتر مشخص نبود. اما نقشهی محاسباتی شامل 21000 ناحیهی کوچک (= تعداد آنتنهای مخابراتی) میشد.
همچنین تهیهی نقشهی دولتی بیش از یک سال زمان و نزدیک به یک میلیون دلار هزینه بُرد و نقشهی محاسباتی بلومنستاک به دوازده هزار دلار و دو هفته زمان نیاز داشت. به عبارت دیگر با هزینهای که برای پیمایش ملی انجام شده بود، میشد تا هفت سال هر ماه پیک پیمایش محاسباتی انجام داد.
بلومنستاک کارش را به خوبی انجام داد و پژوهش او الان به یکی از نمونههای مرجع در کلاسهای علوم اجتماعی محاسبای و استفاده از کلانداده (= بیگدیتا) تبدیل شده است. دولتهای مختلف (مثلاً افغانستان، توگو و ...) از او دعوت میکنند تا کارهای مشابهی را برایشان انجام دهد.
چرا استفاده از یادگیری ماشین در سیاستگذاری و پژوهش اجتماعی این همه مهم و کارگشا است؟
1. هزینهی بسیار کم (12،000 دلار در برابر 1،000،000 دلار)
2. سرعت بسیار زیاد (2 هفته در برابر بیش از 50 هفته)
3. نقشههای لحظهای در برابر نقشههای ایستای چندساله (سرشماریها در بهترین حالت در فواصل پنجساله انجام میشوند.)
4. امکان ارزیابی سریع پس از هر تصمیم سیاستی (مثلاً گران کردن بنزین)
5. امکان مشاهدهی لحظهای تغییرات اجتماعی در مواقع بحران (مثلاً وقوع زلزله)
در یادداشتهای بعدی بیشتر دربارهی چرایی استفاده از هوش مصنوعی و یادگیری ماشین و این که چرا پژوهش بلومنستاک را یک نمونهی عالمانه میدانیم، صحبت میکنم. اگر میخواهید بیشتر دربارهی او و سایر پژوهشهایش بدانید، اینجا را ببینید:
مقالهی نهایی او و همکارانش درباره ی رواندا را هم میتوانید اینجا ببینید:

