
این روزها استفاده از ریکامندر سیستم ها متداول شده. وقتی که به IMDb میریم و بهمون فیلم مورد علاقمون رو پیشنهاد میکنه یا وقتی که وارد آمازون میشیم و کالاهایی بهمون معرفی می کنه که جذابند، داریم از یک ریکامندر سیستم استفاده می کنیم.
در ایران هم ریکامندر سیستم یکتانت وظیفه هدایت کاربران به صفحات مورد علاقشون رو بر عهده داره.
من 7 ماه گذشته رو صرف تولید و توسعه ریکامندر سیستم یکتانت کردم و این مقاله، خلاصه ای هست از ایده های الگوریتمی که در این فرایند استفاده شده اند.
بدیهیست بیشتر از 60 درصد این زمان، صرف انتقال ریکامندر به محیط محصول (Production) و اسکیل آن شده است اما تمرکز این مقاله بر ارائه ایده ها، چالش ها و الگوریتم هاست. امیدوارم مطالعه آن برای شما مفید باشد.
ریکامندر سیستم ها از نقطه نظر محصول به دو دسته کلی تقسیم می شوند.
1. آیتم محور (Item Based)
در این دسته، ریکامندیشن برای یک آیتم (صفحه وب) تولید می شود. برای مثال در یک صفحه با عنوان "انتخابات مجلس"، یک مطلب با عنوان "آخرین نتیجه شمارش آرا" پیشنهاد داده می شود.
در این نوع ریکامندیشن هر کاربری که وارد صفحه "انتخابات مجلس" می شود، همان ریکامندیشن را مشاهده می کند که سایر کاربران مشاهده می کنند.
2. کاربر محور (User Based)
در این دسته، ریکامندیشن بر اساس سلیقه کاربر تولید می شود. مثلا من به عنوان یک برنامه نویس پایتون، زمانی که وارد یک وب سایت میشم، مطلبی تحت عنوان "آخرین کرک نرم افزار PyCharm" به من ریکامند میشود. این اتفاق ممکن هست زمانی رخ بدهد که من در حال مطالعه یک خبر سیاسی هستم.
هر کدام از دو دسته می توانند به عنوان یک محصول جداگانه توسعه داده شوند.
ریکامندر سیستم ها از نقطه نظر الگوریتم و دیتای ورودی هم به دو دسته کلی تقسیم می شوند.
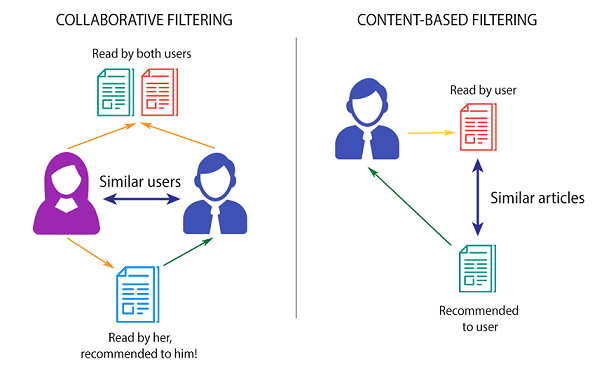
1. محتوا محور (Content Based)
در این دسته، ریکامندر سیستم محتوای آیتم ها را آنالیز می کند و مثلا متوجه می شود که خبر "ترامپ پیروز انتخابات شد" محتوای نزدیکی به خبر "آخرین نتایج انتخابات آمریکا" دارد.
2. بازدید محور (Collaborative Filtering)
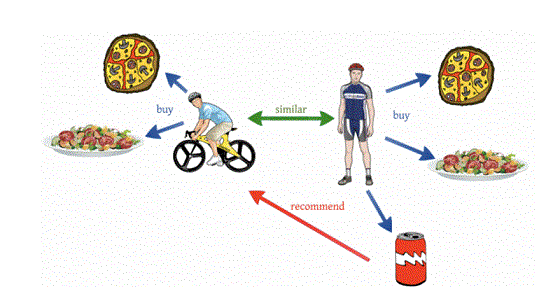
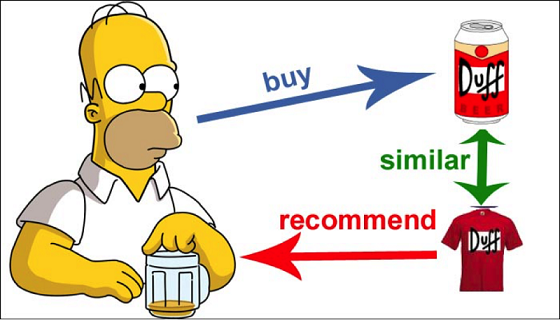
در این دسته، ریکامندر سیستم با صرف نظر کردن از محتوای آیتم ها، دیتای بازدید کاربران از آن ها را معیار قرار می دهد. برای مثال، در تصویر زیر، ریکامندر سیستم شباهت بین دو کاربر را با نزدیکی محصولاتی که قبلا خریداری کرده اند، درک کرده و در نتیجه نوشابه ای که کاربر اولی خریده را به دومی پیشنهاد می کند.
فاکتورهای زیادی در انتخاب الگوریتم ریکامندر سیستم موثرند. در زیر به تعدادی از آن ها اشاره می شود.
1. دیتا
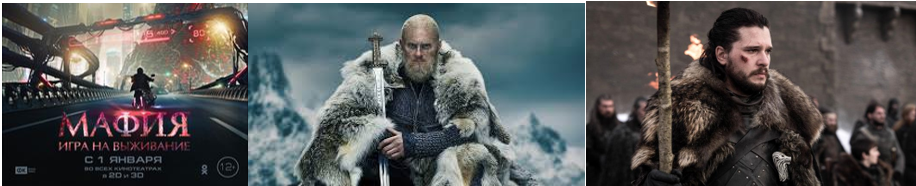
در بسیاری از سایت ها محتوای متنی وجود ندارد. مثلا در سایت یوتیوب برای هر ویدیو فقط یک تیتر وجود دارد و اگر قرار باشد از الگوریتم محتوا محور استفاده بشود، ممکن است فیلم Game of Thrones به فیلم Game of Survival ریکامند بشود. در صورتی که از روابط بازدیدی احتمالا می توان فهمید، که Game of Thrones به فیلم Vikings شبیه تر هست.
2. میزان تغییرات (Turnover)
الگوریتم بازدید محور نقض اساسی در وب سایت هایی دارد که میزان تغییرات (Turnover) در آن ها بالاست.
زیرا در این نوع الگوریتم، مدتی زمان لازم هست تا یک آیتم یا کاربر جدید، دیتای کافی را کسب کند (Learning Rate). این مسئله در سایت های خبری مثل انتخاب به حدی است که می تواند الگوریتم رو به طور کامل بی مصرف بکند. به این مشکل Cold Start هم گفته می شود.
3. تمایل به مطالب پربازدید (Trends)
راه حل بازدید محور، تمایل بیشتری به پیشنهاد مطالبی دارد که پربازدیدتر هستند. در مقابل الگوریتم محتوا محور هیچ اهمیتی به میزان بازدید نمی دهد. این قاعده ممکن هست مثبت یا منفی باشد.
4. پراکندگی بازدید کاربران
در سایت هایی مثل انتخاب که کاربران وفادار دارند، کاربران ممکن است مطالب متنوع مشاهده کنند. در این صورت عملکرد الگوریتم بازدید محور دچار مشکل می شود.
5. شباهت بیش از حد (Overspecialization)
فرض کنید به یک مطلب در مورد ویندوز 7، سه مطلب دیگر در مورد ویندوز 7 ریکامند بشود. در این صورت شانس کلیک کاربر مقداری کمتر از وقتی است که یکی از آن ها در مورد یک سیستم عامل دیگر باشد. به این مشکل شباهت بیش از حد یا Overspecialization می گویند. الگوریتم محتوا استعداد بسیار بیشتری برای درگیر شدن با این مشکل دارد. الگوریتم بازدید محور متنوع تر پیشنهاد می کند.
جدول زیر حاصل ترکیب تقسیم بندی الگوریتمی و محصولی است که 4 گروه زیر را تولید می کند.
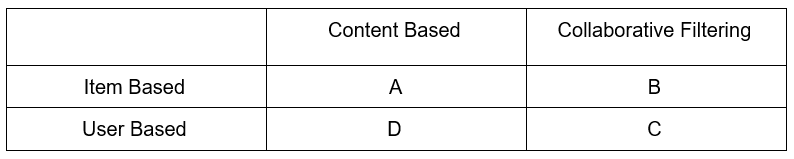
در یکتانت من کار رو با گروه A شروع کردم. یعنی ریکامندیشن برای آیتم و براساس محتوا.
یک ماه R&D در محیط آفلاین و چهار ماه پیاده سازی و ریزه کاری زمان برد تا ریکامندر سیستم یکتانت کاملا جا افتاد. به مرور زمان و با نتیجه دهی سیستم بود که افراد دیگه به پروژه اضافه می شدند و قسمت های مختلف اون قوی تر از قبل بازنویسی می شد. حتی برای توسعه لازم بود که سیستم های جانبی مثل سرویس استخراج دیتای وب هم بازنویسی و تقویت بشوند.
در طی این پروسه کم کم مشخص شد، سه دسته دیگر ریکامندر سیستم نیز مورد نیاز هستند. چرا که در بسیاری از سایت های متقاضی (مثل سایت های دانلود موزیک یا نرم افزار) روش محتوا محور پاسخگو نبود و ریکامندیشن بر اساس کاربر نیز به اهداف مجموعه اضافه شده بود.
در این روش، مغز الگوریتم ریکامندر به یک تابع خلاصه می شود: تابع اِمبد کردن هر آیتم(صفحه وب) بر اساس محتوای آن
تکست امبدینگ (Text Embedding)
اگر بتوانیم یک متن را به یک بردار(نقطه) در عالم ریاضیات تبدیل کنیم - طبیعتا به طوری که دو مطلب مشابه در نزدیکی هم قرار بگیرند - تا حد زیادی مسئله ریکامندیشن حل میشود. به این صورت که برای تولید ریکامندیشن های هر مطلب، مطالبی را که وکتورهای نزدیکی به آن دارند، ریکامند می کنیم. این روش در واقع همان روش Nearest Neighbor در ماشین لرنینگ کلاسیک هست.
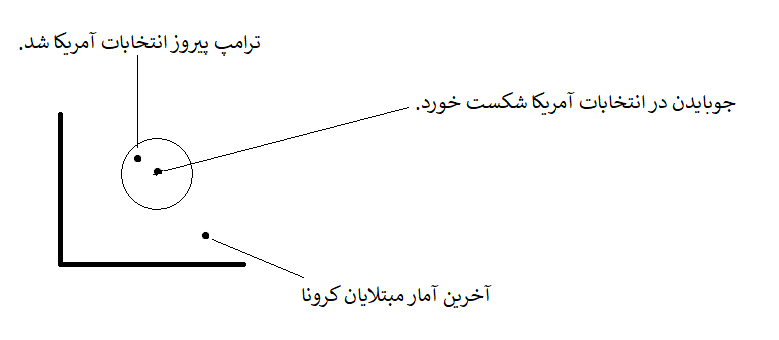
هر بُعد از این فضا می تواند یک مشخصه (characteristics) از متن باشد. مثلا در حالت ساده یک بُعد می تواند نشان دهنده تعداد کلمات "ترامپ" در یک متن و یا در حالت پیشرفته نشان دهنده میزان سیاسی بودن آن متن باشد.
تکست امبدینگ پایه ای (Basic Text Embedding)
برای امبدینگ متن، ساده ترین روش، استفاده از فرکانس تکرار کلمات هست. به این صورت که هر بُعد از فضا برای یک کلمه در نظر گرفته می شود و تعداد بارهایی که آن کلمه در متن تکرار شده، به عنوان مقدار اون بُِعد مقداردهی می شود.
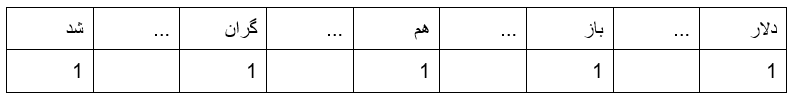
اگر یک کلمه بیشتر از یک بار در متن تکرار شود، تعداد تکرار یا همان TF (مخفف Term Frequency) در بردار قرار داده می شود. در نتیجه یک مطلب بلند که بارها از کلمه ترامپ استفاده می کند، مقدار بزرگی برای ترامپ در بردار آن لحاظ می شود. در نتیجه وقتی دو متن در مورد انتخابات آمریکا به طور مکرر از کلمات یکسانی مثل "ترامپ"، "بایدن" و "آمریکا" استفاده می کنند، امید داریم که بردارهای آن ها نزدیک شوند.
اما سادگی این روش و به طبع، نارسا بودن آن در چند مثال دقیق تر محسوس می شود.
1. هم معنایی
آ: بیماری کرونا جان هزاران نفر را گرفت.
ب: صدها انسان از مریضی covid19 جان باختند.
بردار مربوط به دو متن بالا کاملا متمایز است. چرا که کلمات "کرونا" و "covid19"، "صدها" و "هزاران"، "بیماری" و "مریضی" همه دو به دو متفاوت هستند.
به طور خلاصه دو عبارت "کرونا" و ترامپ" همان اندازه متفاوتند که دو کلمه "کرونا" و "covid19" متفاوتند.
2. عدم درک نزدیکی ها
آ: فرهاد مجیدی به باشگاه استقلال پیوست.
ب: لیگ برتر وارد فصل نقل و انتقالات می شود.
در دو عبارات بالا، اگرچه "استقلال" و "لیگ برتر" هم معنی نیستند ولی حداقل نزدیکند. روش ابتدایی تکست امبدینگ متوجه آن نمی شود.
3. تحلیل لغوی به جای معنایی
آ: یک سر بریده در چمدانی پیدا شد
ب: فروش چمدان با قیمتی ویژه
ممکن است دو خبر بالا به دلیل مشابهت در کلمه چمدان نزدیک هم باشند. مخصوصا اگر در متن کامل چندین بار کلمه "چمدان" استفاده شده باشد. در صورتی که یکی اقتصادی و دیگری جنایی است.
4. وزن یکسان کلمات
آ: رقابت ترامپ و بایدن
ب: رقابت جاوا و پایتون
دو عبارت کلمات مشترک "رقابت"، "و" را دارند. این باعث نزدیک شدن بردار آن ها می شود در حالی که کاملا متفاوت هستند. این مشکل به آن دلیل است که کلمات "رقابت"، "و" و "ترامپ" به یک اندازه ارزش دارند. ایده اولیه حذف کلمات بی معنایی مثل "و" (اصطلاحا stop words) از پردازش هاست اما مشکل همچنان باقیست. کلمه "رقابت" همان قدر ارزش دارد که "ترامپ" دارد.
5. کلمات جفت
آ: حسن روحانی رئیس جمهور شد.
ب: یک روحانی رئیس اداره شد.
دو متن بالا بسیار نزدیکند زیرا در کلمات "روحانی" و "رئیس" اشتراک دارند. حال آن که انسان می فهمد "رئیس جمهور" و "حسن روحانی" هر کدام یک عبارت هستند. تکه کد پایتونی که نمایندگی هوش مصنوعی رو ایفا می کنه، کلمات رو با space از هم جدا میکند و این باعث شکسته شدن "رئیس جمهور" به "رئیس" و "جمهور" می شه.
تکست امبدینگ پیشرفته (Advanced Text Embedding)
برای تکست امبدینگ بهتر، از تکنیک های پیچیده تری استفاده می شود که در زیر مورد به مورد بیان شده است.
1. امبدینگ کلمات (word2vec)
در این روش سعی می کنیم به جای این کل عبارت را تبدیل به وکتور کنیم، ابتدا هر کلمه را تبدیل به وکتور کنیم و سپس وکتور کل متن را از میانگین گیری بین کلمات مختلف تولید کنیم. در این صورت می توان مکانیزم تبدیل کلمه به وکتور که همان word2vec نام دارد را طوری طراحی کرد تا کلماتی که مشابه هستند، وکتورهای نزدیک به هم داشته باشند.
مثلا در شکل زیر که در دو بعد ترسیم شده است، کلمه piano نزدیک به کلمه guitar است.
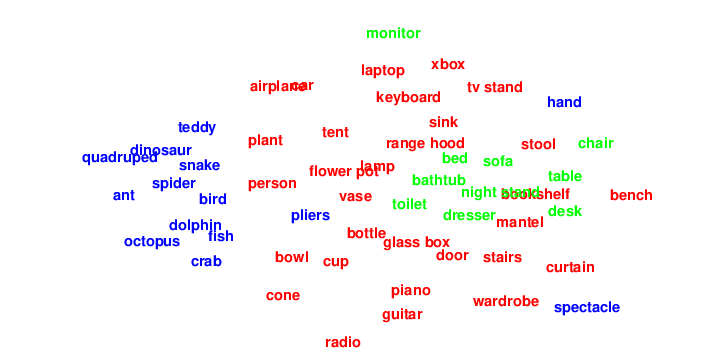
برای آموزش این مدل، حجم زیاد داده آنالیز می شود و میزان نزدیکی کلمات در فضای N بعدی، از تکرار آن ها در نزدیکی هم در متون داده شده به دست می آید.
2. تحلیل معنایی به جای تحلیل لغوی (Semantic Analysis)
زمانی که به تیتر خبر "سر بریده داخل چمدانی در فرودگاه پیدا شد." نگاه می کنیم، می فهمیم آن خبر جنایی است. وقتی تیتر "فروش چمدان در فرودگاه" را می بینیم، می فهمیم یک متن اقتصادی یا تبلیغاتی است. دسته بندی معنایی به ما کمک می کند که بفهمیم آن متون متفاوت هستند، هر چند که ممکن است، بردارهای نزدیک داشته باشند.
تشخیص موضوعات صفحات در یکتانت توسط یک سیستم "تشخیص موضوعی" انجام می شود که خارج از توضیح این مقاله است، اگر چه که اساس تقریبا یکسانی دارد.
3. تاثیر فراوانی (TF-IDF)
وقتی که یک انسان متنی را بررسی می کند، کلماتی مانند "ترامپ" در تحلیل محتوای متن تاثیر بیشتری نسبت به کلماتی مانند "سلام" دارند. این ذهنیت ناشی از کمبود کلمه دومی است که باعث می شود متوجه تاثیرگذاری آن در یک متن شویم.. برای این کار از فرمول tf-idf به عنوان وزن کلمات استفاده می کنیم.
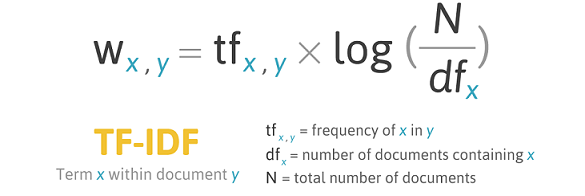
در این فرمول کلماتی که مکررا استفاده می شوند مثل کلمه "گربه" وزن بسیار کوچکی می گیرند. (چرا؟) و در نتیجه کلمات کمیاب در همه متون اما پر تکرار در متن فعلی نقش بزرگ تری خواهند داشت.
4. جفت های پرتکرار (Bigram)
این مدل قابلیت چسباندن کلماتی که مکرر با هم تکرار شدند رو داره. برای مثال "جمهوری اسلامی" رو به "جمهوری_اسلامی" تبدیل می کنه. برای آماده سازی آن باید حجم زیادی داده خام به عنوان ورودی بهش داده بشه تا متوجه بشه چه کلماتی جفت هستند.
ارزیابی چنین سیستمی کاملا کیفی است. خبری از داده آموزش (train) و آزمون (test) نیست. مسئله کاملا unsupervised هست و هیچ متدی وجود ندارد که برای کیفیت سیستم را در یک عدد خلاصه کند.
به علاوه ریکامندیشن ها تا حدی سلیقگی هستند و ممکن است از نظر یک نفر جالب باشند و از نظر نفر دیگر جذاب نباشند. همه این مسائل، کار رو برای اصلاح الگوریتم (Fine Tuning) سخت می کند. مسئله پارامترهای زیادی دارد که انتخاب آن ها بدون وجود متد ارزیابی امکان پذیر نیست.
در نتیجه باید از ایده ها و روش های غیر مستقیم استفاده کنیم که دو مورد از آن ها در زیر ذکر شده اند.
1. نرخ کلیک (CTR)
در این روش نرخ کلیک کاربران بر روی ریکامندیشن ها به طور ساده نتیجه معیاری کیفیت ریکامندر سیستم در نظر گرفته می شود. اما در انتخاب این نوع روش باید به عوامل زیر توجه داشت.
2. ارزیابی چشمی
در این روش باید ریکامندیشن ها رو ببینیم و قضاوت کنیم که چه قدر خوب هستند! اما باز هم در عین سادگی نکات خیلی ظریفی باید رعایت شوند.
در هر صفحه وب اطلاعات دیتای وجود دارد. این شامل تیتر، متن، تصاویر، خصیصه های h1 و h2 و همچنین اطلاعاتی مثل دسته بندی هر صفحه هست. انتخاب بخشی از این دیتا که به عنوان فیچر ورودی باید وارد الگوریتم بشود، بدیهی نیست.
باید این رو توجه داشت که استفاده از تمام دیتا مشکل بی معنی کردن وکتورها رو داره. مثلا اگه کل دیتای یک متن ورودی گرفته ممکنه بخشی از اون اقتصادی و بخشی سیاسی باشه و ترکیب آن ها وکتور رو به فضای متفاوتی ببرد.
از طرف دیگر استفاده صِرف از تیتر مشکلاتی رو داره که قبلا بیان شده اند. مثلا تیتر صفحه ای "زبان سرخ رسانه" بود که ریکامندیشن های اون مطالب ورزشی می شدند که در تیتر کلمه "سرخ" رو داشتند مثل "جدال سرخ آبی ها".
بعد از آنالیزها مشخص شد استفاده از تیتر به همراه بخشی از ابتدای متن مفیدترین روش است.
حال آن که همه آیتم ها به بردار تبدیل شده اند، پایه برای تولید ریکامندر سیسم کاربر محور هم مهیا می شود.
درواقع با در اختیار داشتن همان وکتورهای قسمت پیشین، می توان فهمید علاقه هر کاربری کجاست. هر کاربر نقاطی را مشاهده می کند که بهم نزدیک هستند و در نتیجه می توان مطالبی را که در همان ناحیه ها وجود دارند به او پیشنهاد داد.
برای عملیاتی تر شدن روش در یکتانت از خوشه بندی (clustering) استفاده کرده ایم.
صفحاتی که کاربران در فضای وب می بینند، در دیتای یکتانت رکورد می شوند. این دیتا به فرمت زیر هست.
user_i, item_j, timestamp
حال اگر به ایده امبدینگ برگردیم، یک روش دیگر برای اِمبدینگ آیتم ها، استفاده از بردار بازدید آن ها توسط کاربران است. در واقع برای هر آیتم یک بردار به طول تمام کاربران در نظر میگیریم که هر کاربری از آن آیتم بازدید کرده مقدار یک و سایرین مقدار صفر می گیرند. برای مثال در تصویر زیر دو ماشین سیاه مشابهند چون کاربران مشابهی آن ها را دیده اند.
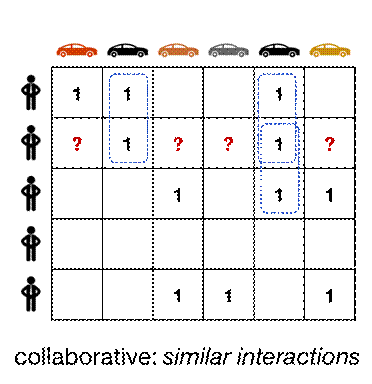
در این روش بردارها و کل ماتریس به شدت اسپارس هستند. زیرا هر آیتم توسط کاربران بسیار کمی دیده شده و هر کاربر هم آیتم های کمی دیده است. علاوه بر این همان ایرادات روش پایه ای امبدینگ متن، این جا هم با تفاوت هایی وجود دارند.
در نتیجه برای امبدینگ پیشرفته تر (و کاهش ابعاد) از تجزیه ماتریس استفاده می شود.
تجزیه ماتریس فرایند شکستن ماتریس های sparse به ماتریس های کوچک تر است. یکی از الگوریتم های آن که در ریکامندر سیستم یکتانت استفاده می شود، ALS نام دارد.
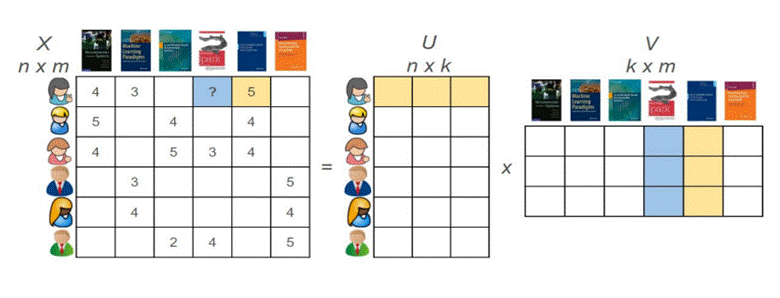
اگر تعداد کاربران n، تعداد آیتم ها m باشد، ماتریس بازدید کاربران از صفحات وب n x m می شود. در تجزیه ماتریس، آن ها به دو ماتریس کوچک تر k x m و m x k تبدیل می شوند که ضرب آن ها ماتریسی نزدیک به ماتریس اصلی را ایجاد می کند. k در این جا یک هایپر پارامتر است که تعداد فیچرهای در نظر گرفته شده برای هر آیتم و هر کاربر می باشد.
در ماتریس آیتم ها، آن ها به بردارهای معنی داری متناظر شده اند به طوری که آیتم های مشابه بردارهای نزدیک به هم دارند. از همین بردارها می توان مسیر الگوریتم قبلی را طی کرد. برای هر آیتم، آیتم های با بردار نزدیک به آن را ریکامند می کنیم.
طرف دیگر الگوریتم تجزیه ماتریس، امبدینگ کاربران است. در ماتریس U هر کاربر به یک بردار k بعدی تبدیل شده که دو کاربر شبیه به هم بردار نزدیک دارند. علاوه بر این ضرب بردار کاربر i در آیتم j یک عدد تولید می کند که نشان دهنده میزان علاقه کاربر i به آیتم j است.در واقع پیش بینی می کند که میزان علاقه هر کاربر به هر آیتم که قبلا ندیده، چه قدر است. از این رو می توان با مرتب کردن علاقه های پیش بینی شده برای هر کاربر آیتم هایی که احتمالا از نظر او جذاب خواهند بود را به او ریکامند کرد.
هر دو الگوریتم کاربر محور به گونه ای طراحی شده اند که احتمال ریکامندکردن مطالب تکراری زیاد می شود. از نقطه نظر محصولی چنین اتفاقی نباید بیفتند چرا که ریکامندیشن تکراری نه تنها برای کاربران جذاب نیست، بلکه منزجر کننده هم خواهند بود.
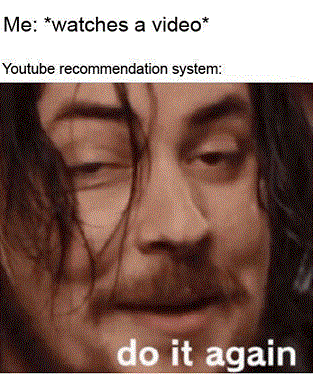
دوستی می گفت "دیجی کالا هر هفته search history من رو بهم ایمیل می کنه." ترکیبی از مشکل overspecialization و پیشنهاد آیتم تکراری
زنگ تفریح | آینده ریکامندر سیستم کابر محور
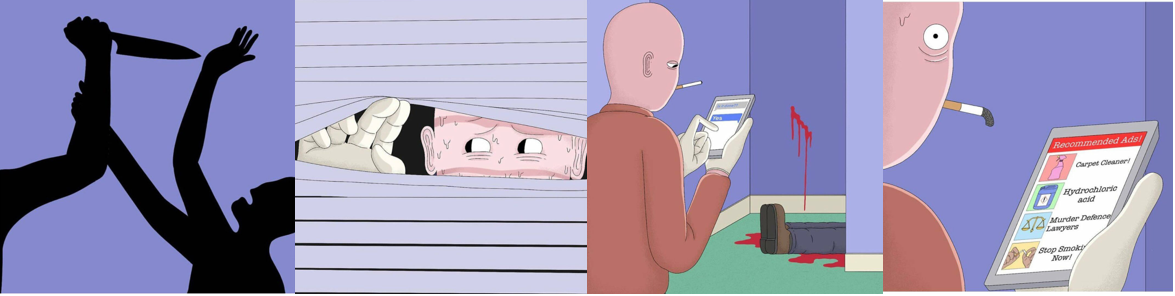
اگرچه که این مقاله با تمرکز بر روی الگوریتم ها نوشته شد، چالش هایی در مرحله محصول (پروداکشن) هستند که تاثیر زیادی روی الگوریتم ها داشته اند. در این قسمت گزیده کوتاهی از آن ها رو بیان می کنم.
همسایه یابی عملیات سنگینی و غیر قابل استفاده در پروداکشن هست. برای بهینه کردن آن از روش های تقریبی استفاده می شود. ما در ریکامندر سیستم یکتانت از کتابخانه Annoy استفاده کردیم که با به کارگیری جمعی از تکنیک های الگوریتمی و فنی، روش سریع تری برای همسایه یابی استفاده می کند.
در این معماری، پروژه به دو قسمت fetch و manager شکسته شد که در قسمت manager، ریکامندیشن ها تولید و در fetch صرفا پاسخگویی به fetch بدون پردازش اضافی انجام می شود. در این صورت fetch بسیار سبک و قابل توزیع روی چند سرور می شود.
با چنین ایده ای و استفاده از 2 سرور 2 هسته ای اضافه، پاسخ گویی سریع تر می شود و اسکیل سیستم از حدود 100 ریکوئست بر ثانیه تا 500 ریکوئست بر ثانیه افزایش پیدا کرد.
برای ذخیره ریکامندیشن ها کل اطلاعات در دیتابیس داخل مموری Redis ذخیره شدند تا پاسخگویی سریعترین حالت باشد.
توضیح واضحات
بدیهیست بسیاری از دانش گفته شده در کتابخانه ها و مدل هایی نهفته است که در از آن ها به عنوان black-box استفاده می شود.
به علاوه با توجه به ماهیت علمی الگوریتمی و به منظور خلاصه سازی این مقاله از ارائه توضیحات در زمینه جزئیات کتابخانه ها و ابزارهای استفاده شده، زیرساخت داده ها و تکنیک های جزئی اما موثر تا حد زیادی خودداری شده است. در صورتی که علاقه مند به گرفتن اطلاعات بیشتر در این زمینه باشید و اهداف کاملا آکادمیک (آموزشی یا تحقیقاتی) داشته باشید، می تونید به لینکدین من پیام بدید.
موقعیت شغلی Data Scientist در یکتانت
در یکتانت موقعیت شغلی دیتاساینتیست به طور خلاصه، به معنای حل مسائل شرکت از طریق الگوریتم های مبتنی بر داده ست. این روش میتواند مانند گفته های بالا از طریق الگوریتم های ماشین لرنینگ یا از طریق روش های ساده تر مثل if-else باشد. البته بخش اعظمی از کار انتقال محصول به محیط پروداکشن و انجام کارهای نرم افزاری آن است.
اطلاعات بیشتر در مورد موقعیت های شغلی یکتانت رو از این جا می تونید بررسی کنید.
در صورتی که مایل بودید می تونید از خود من در موردش بپرسید.
این پست در بلاگ شخصی من و بلاگ مهندسی یکتانت به صورت مشترک منتشر شده است. در صورتی که محتوای این مقاله براتون جالب بود، با دنبال کردن هر دو صفحه می تونید مطالب مشابهی رو در آینده در آینده دریافت کنید.
اگر سوالی داشتید حتما کامنت کنید و اگر مطلب رو مفید دانستید می تونید برای دوستانتون هم ارسال کنید.
مطلب قبلی: الستیک سرچ/ کیبانا / لاگ استش - شفاف ببینیم
contact:
e-mail: [email protected]
LinkedIn: Armin Zirak


