
اگر با استک الستیک آشنایی ندارید ابتدا خوندن این پست رو بهتون توصیه میکنم.
این نوشتار از دو بخش تشکیل شده؛ در بخش اول «تجربهی ما» از معماری استک قدیمی خودمون توی یکتانت صحبت میکنیم، چالشهایی که داشت رو بررسی و معماری جدید رو معرفی میکنیم و در بخش دوم «بایدها و نبایدها در تنظیمات ELK، فوت کوزهگری!» یه سری نکات کلی راجع به استک الستیک رو مورد بررسی قرار میدیم که موقع بالا آوردن استک باید به اونها توجه بشه.
تصور کنید که به عنوان نیروی SRE توی یک شرکت استخدام شدید و اولین وظیفهای که دارین اینه که استک قبلی شرکت رو به یک استک جدید منتقل کنید و کاری کنید که قابل اتکا باشه و بشه در مقیاس بالا ازش استفاده کرد؛ واکنشتون چیه؟ واکنش من:
من جواد علیپناه هستم. مدتیه که در شرکت یکتانت به عنوان نیروی SRE مشغول به کار شدم و قراره توی این نوشتار براتون از تجربیاتم روی استک الستیک و موارد مهم راجع به تنظیمات اون بگم. اگر هم براتون سوال یا ابهامی پیش اومد خوشحال میشم زیر این نوشته کامنت بذارید.
وقتی من وارد یکتانت شدم دیدم که بعضی از تیمها از استک الستیک استفاده میکنن؛ باقی تیمها هم وسوسه شده بودن که سمتش بیان و جوّ غالب استفاده از امکانات جذاب این تکنولوژی بود. سؤالی که وجود داشت اما این بود که آیا معماری فعلی برای استفاده همهی تیمها مناسبه؟ مناسب به این معنی که ۱. تیمها بدون درد و خونریزی و در مدت زمان خیلی کم بتونن لاگهایی که داشتن رو به الستیک بفرستن و ازش استفاده کنن ۲. استک موجود کشش اضافه شدن تیمها رو داشته باشه ۳. تیمها بتونن لاگها رو به هر فُرمتی بفرستن و در هر زمانی این فرمت بتونه تغییر کنه.
برای اینکه یه دید کلی از معماری قدیمی داشته باشید تصویر ۲ رو نگاه کنید:
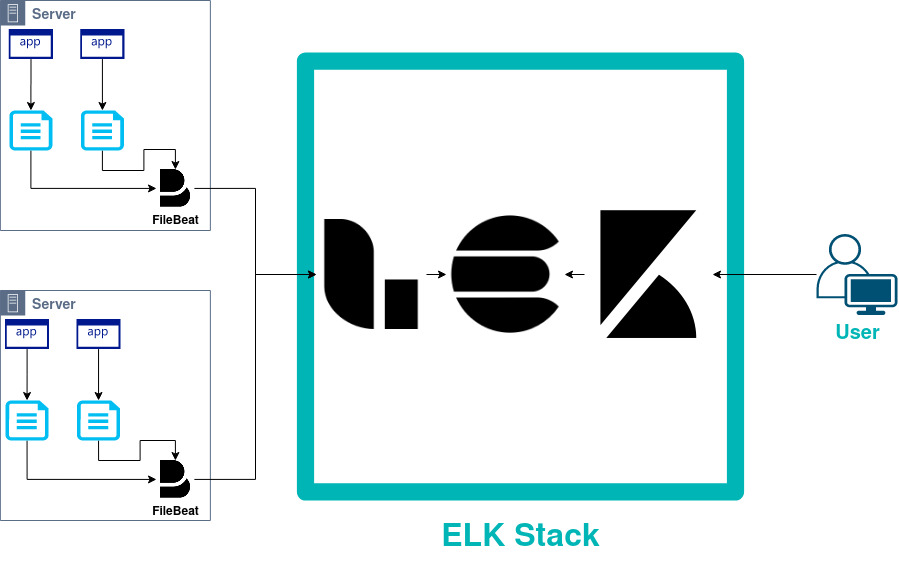
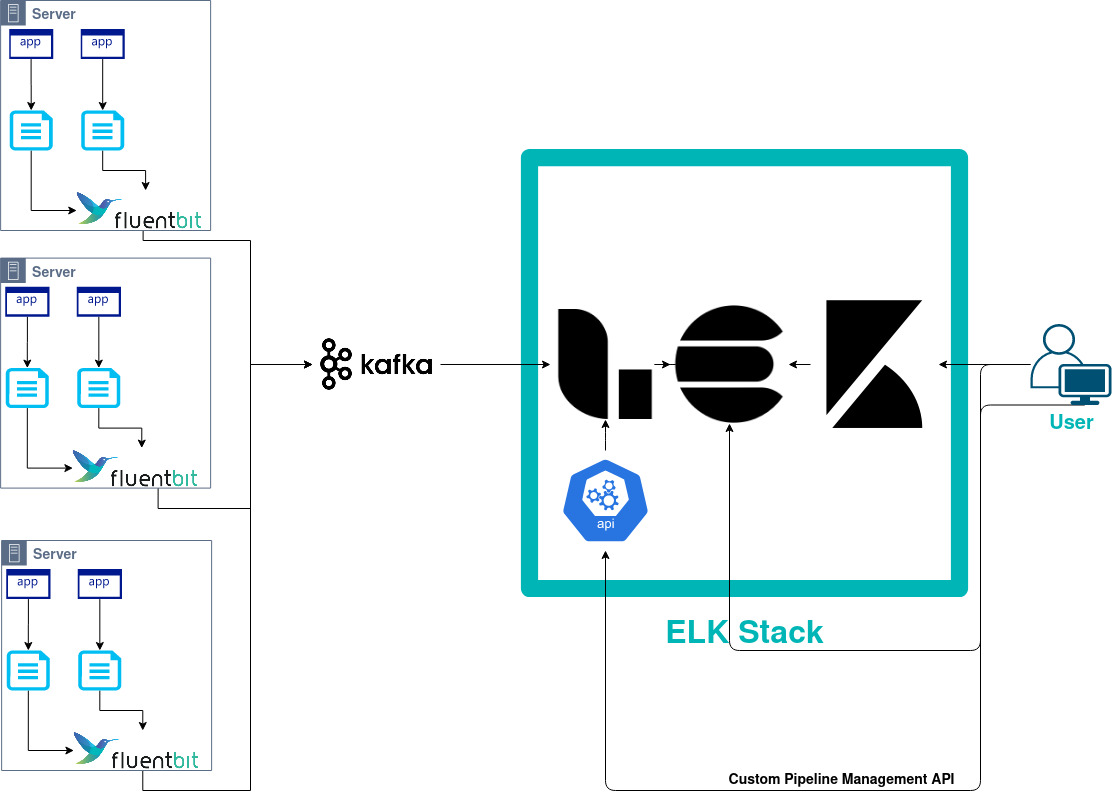
همونطور که توی تصویر میبینید توی این معماری روی هر سرور یک نسخه فایلبیت وجود داره که فایل لاگ سرویس رو میخونه و اون رو به لاگاستش Forward میکنه؛ لاگی که به دست لاگاستش میرسه بدون ساختار هست پس لاگاستش باید اون رو Parse کنه و به فرمت JSON در بیاره و بعد برای الستیکسرچ بفرسته. در انتها کاربر از طریق کیبانا برای دادهها داشبورد میسازه و اونها رو به صورت نمودار و چارت مشاهده میکنه.
سوال مهمی که ابتدای کار برای ما وجود داشت این بود که آیا به معماری جدیدی نیاز داریم یا نه؟
برای موارد ۴ و ۵ که بهشون اشاره شد راهکار مناسب بدون تغییر معماری وجود داشت ولی موارد دیگه استفاده از سیستم فعلی رو با چالش مواجه کرده بود. این شد که من و تعدادی از دوستان مأمور تحقیق و توسعهی یک معماری مناسب در زمان کوتاه شدیم...
برای اینکه این نوشتار طولانی نشه از پرداختن به فرآیند تصمیمگیری و گزینههای پیشرو صرفنظر میکنم و فقط تصمیماتی که برای حل معایب بالا گرفتیم رو میگم:
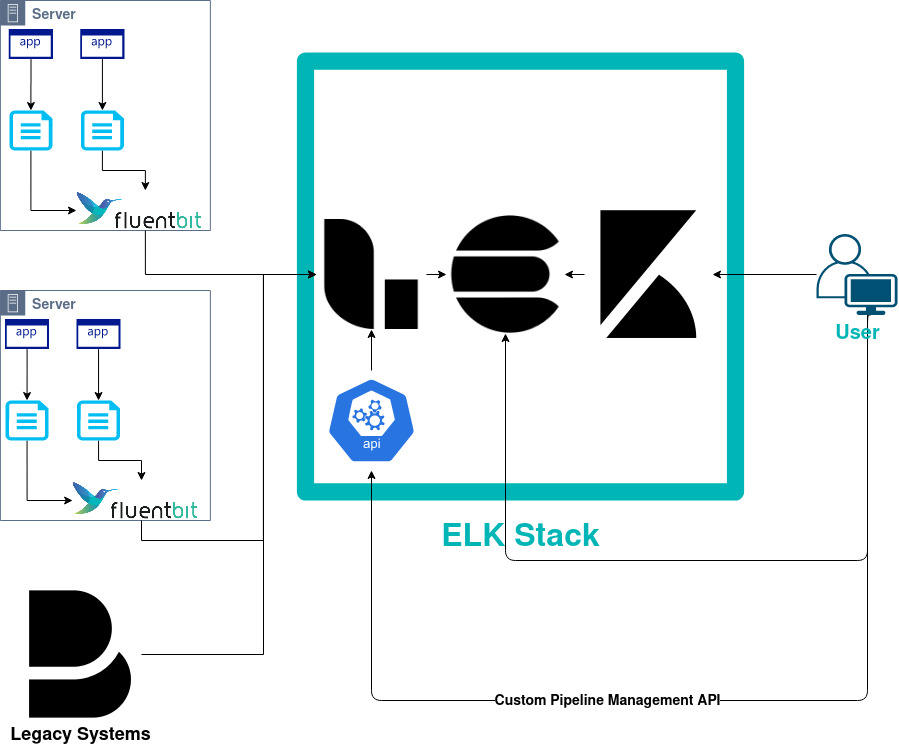
که پُرواضحه یعنی نه! :) گزینهی دوم این بود که تیمها با همون فرمت قبلی لاگ کنن اما ما لاگ ساختارمند توی لاگاستش دریافت کنیم. چطوری؟ با Parser/Forwarderهای محلی (کنار خود سرویس). از بین همهی گزینهها ما تصمیم گرفتیم فلوئنتبیت رو به استکمون اضافه کنیم چون خیلی Lightweight و سریعه، تنظیمات راحت و سرراستی داره، میشه براش پایپلاین تعریف کرد و از منابع متعدد لاگهای متفاوت با فرمتهای مختلف رو پارس کرد و جدای از همهی اینها پلاگینهای متعددی رو هم پشتیبانی میکنه که دقیقا مناسب کار ما بود.
ما همین گزینه رو انتخاب کردیم و با همین تصمیم به چندین دستاورد مهم رسیدیم:
- بار خیلی زیادی از روی دوش لاگاستش برداشته میشد. (Parse کردن و ساختار دادن)
- میشد فرمت مشترکی برای پایپلاینهای مختلف در آورد.
- تغییر فرمت لاگ یک سرویس فقط تا فلوئنتبیت منتشر میشد و نیازی به تغییر در جاهای دیگه نداشت.
۳. با تصمیمی که برای حل مشکل دوم گرفتیم این مشکل هم خودبخود حل شد و معماری جدید ما به شکل زیر در اومد:
راهحلهای پیشنهادی برای موارد ۴ و ۵ توی بخش «بایدها و نبایدها در تنظیمات ELK، فوت کوزهگری!» اومده.
آن کس که بداند و بداند که بداند
اسب خرد از گنبد گردون بجهاند
با در نظر گرفتن این بیت، بهتره که همیشه تا جایی که میشه از خودمون سوال بپرسیم، به ایرادات خودمون واقف باشیم و در آینده در صدد اصلاح اونا بربیایم یا حدأقل اثر منفی اونها رو کمینه کنیم.
ایراداتی که به معماری جدید وارده به صورت تیتروار:
هیچوقت کار روی یک سیستم زیرساختی تموم نمیشه. حتی اگر در اون تغییری هم ایجاد نکنید همیشه باید حواستون به دسترسپذیری (Availability)، اتکاپذیر بودن و امن بودن اون باشه. ما هم با در نظر گرفتن این موارد به مرور به رفع ایرادات میپردازیم و اگر نکتهی جالبتوجهی وجود داشت حتما در آینده پستهای بیشتری در این باره منتشر میکنیم.
پاسخ به این سؤالات به صورت خلاصه:
در نهایت معماریای که مد نظر ماست و باید بهش برسیم مطابق تصویر ۵ خواهد بود:
توی این بخش از کلیترین بایدها و نبایدها شروع میکنم و به مرور وارد نکات جزئی توی تنظیمات ELK میشم. پُرواضحه که همه چیز را همگان دانند؛ فلذا اگر چیزی رو از قلم انداختم، که حتما انداختم، خوشحال میشم که زیر همین پست اونها رو با من به اشتراک بذارید.
قبل از اینکه به توضیح این مشکل بپردازم باید بدونید که الستیکسرچ به صورت کلاستر استفاده میشه که از ۱ یا بیشتر الستیکسرچ تشکیل شده. این کلاستر یک مستر (Master) داره که وظایف مشخصی از قبیل ساخت و حذف ایندکسها، تخصیص شارد و ... رو انجام میده.
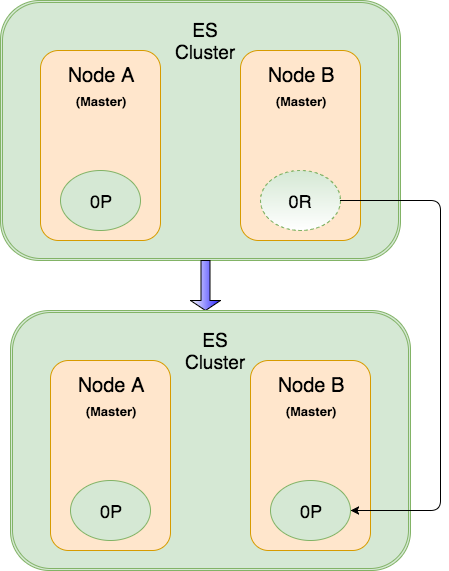
مستر از طریق مکانیزم رأیگیری انتخاب میشه و نودهایی (Node) که واجد شرایط (master eligible) هستن میتونن توی فرآیند رأیگیری شرکت کنن و اون رو انتخاب کنن. حالا فرض کنید که دوتا نود واجد شرایط دارید: A و B؛ و A به عنوان مستر انتخاب شده. یک لحظه ارتباط بین این دوتا دچار اختلال میشه؛ توی چنین شرایطی هر نود خودش رو تنها عضو کلاستر میبینه و خودش رو به عنوان مستر انتخاب میکنه و وظایف مستر رو به عهده میگیره. این اتفاق باعث میشه که شما دوتا مستر داشته باشید و تمامی کارهایی که باید یک مستر مجزا انجام میداد در دو جا انجام میشن و ممکنه ناسازگاری توی کلاستر بروز کنه. برای مثال توی تصویر ۶ میبینید که نود B بعد از Split Brain شارد کپی (Replica) رو شارد اصلی (Primary) در نظر گرفته.
برای حل این مشکل چیکار میشه کرد؟
خبر خوب! توی ورژنهای جدید الستیکسرچ یعنی ۷ به بعد این مشکل پیش نمیاد. اینجا یه پست خیلی جالب از خود الستیک هست که توضیح داده چطور این مشکل رو رفع کردن. البته همیشه توصیه میشه که تعداد نودهای واجد شرایطتون فرد باشه تا تعداد رأیها مساوی نشه و بشه تصمیمگیری کرد.
اگر به هر دلیلی از ورژنهای قبلی استفاده میکنید باید علاوه بر فرد بودن تعداد نودها مقدار discovery.zen.minimum_master_nodes رو برابر با e/2 + 1 بذارید که e تعداد کل نودهای واجد شرایطه. این مقدار میگه که حتما نصف بعلاوه یک از تعداد کل نودهای واجد شرایط باید حضور داشته باشن تا بشه فرآیند انتخاب مستر رو انجام داد. پس اگر کلاستر شما دو تیکه بشه، فقط توی بخش بزرگتر مستر انتخاب میشه.
زمان اجرای الستیکسرچ شما باید مقدار حدأقل و حدأکثر RAMی که استفاده میکنید رو به JVM اعلام کنید. البته این فقط مربوط به استفاده از فضای Heap مربوط به JVM هست و نود شما مقدار بیشتری رو مصرف خواهد کرد. همه جا توصیه شده که این مقادیر رو یکسان و کمتر از ۳۲ گیگابایت مقداردهی کنید؛ ولی چرا؟
نکته اینجاست که الستیکسرچ زمان اجرا سعی میکنه تمامی Heapای که بهش اختصاص داده شده رو از سیستمعامل بگیره و اون رو قفل کنه (برای اطلاعات بیشتر راجع به قفل کردن فضای آدرس مجازی اینجا رو ببینید). اگر شما مقادیر -Xms و -Xmx که به ترتیب حدأقل و حدأکثر رو مشخص میکنن یکسان نذارید باعث میشه که نود شما نتونه تمامی فضای Heapش رو قفل کنه، پس بنا به شرایط تعدادی از صفحات حافظهاش Swap میشن، فرآیند Gorbage Collection به شدت طولانی میشه و در کل عملکرد سیستم افت میکنه.
حالا چرا زیر ۳۲ گیگابایت؟ در واقع اگر بخوام دقیقتر بگم این مقدار آستانهی Compressed oops روی سیستم شماست (برای اطلاعات بیشتر راجع به Compressed oops اینجا کلیک کنید). فرض کنید شما میزان RAM رو کمی بالاتر از این آستانه گذاشته باشید؛ در این حالت مقدار رم قابل استفاده برای الستیکسرچ کمتر از حالتیه که مقدار RAM رو کمی پایینتر از آستانه ست کرده باشید. جالبه نه؟ برای اطلاعات بیشتر اینجا رو ببینید.
اگر سروری دارید که منابع زیادی داره، توصیه میشه که به جای یک الستیکسرچ با RAM خیلی زیاد چندین نود با مقدار RAMی حدود ۳۰ گیگابایت روش بالا بیارید.
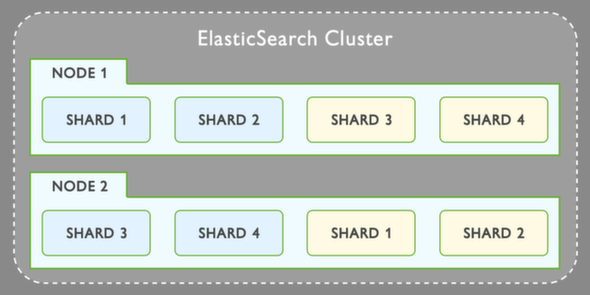
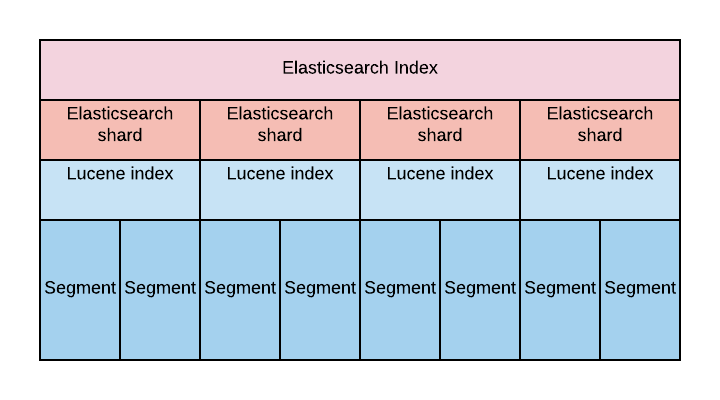
فرض من اینه که مخاطب این نوشته با مفاهیم کلاستر، ایندکس و شارد توی الستیکسرچ آشنایی داره؛ اگر با این مفاهیم آشنایی ندارید اینجا میتونه نقطهی شروع خوبی باشه. همینطور تصاویر ۷ و ۸ میتونه یک دید کلی راجع به این مفاهیم بهتون بده.
۱. چندتا نود داشته باشم؟
۲. چندتا ایندکس توی هر نود داشته باشم؟
۳. چندتا شارد به ازای هر نود داشته باشم؟
اینها سوالاتیه که هرکسی که سعی میکنه الستیکسرچ بالا بیاره حدأقل یه بار از خودش میپرسه. جواب این سوالات یه جملهاس:
بستگی داره!
و واقعا هم به خیلی چیزها بستگی داره. هیچ کس نمیتونه هیچ نسخهی از پیش تعیین شدهای برای همه راجع به این سوالات بده ولی راههایی هست که بتونید از طریق اونها برای کارکرد مدنظر خودتون جواب درستی به این سوالات بدید. یکی از متدلوژیهایی که میشه استفاده کرد توی این لینک قابل مشاهده است.
برای مثال توی استفادهای که ما داشتیم به نظر میرسه تا مدت زیادی ۳ نود الستیکسرچ با ۱ شارد اصلی (Primary) و ۱ الی ۲ شارد کپی (Replica) به ازای هر ایندکس کافی باشه. اما برای مقایسه نتفلیکس از کلاستری با ۲۵۰ نود استفاده میکنه. پس واقعا بستگی داره!
تنها نکتهای که باید توجه کنید اینه که در هر نود تعداد شاردها از ۲۰تا به ازای هر گیگابایت RAMی که به الستیکسرچ اختصاص دادید بیشتر نشه و سایز هر ایندکس هم کمتر از چیزی حدود ۵۰گیگابایت باشه تا جستجوهای شما در زمان معقول پاسخ داده بشن. در حالت کلی شاردهای کمحجم با تعداد زیاد باعث کند شدن عملیات Recovery، ایندکس کردن و عملکرد کلی الستیکسرچ میشه و شاردهای حجیم هم به شدت روی زمان جستجوی شما تأثیر منفی میذاره.
اگر در کارکرد شما جستجو بیشتر اتفاق میافته (Read Heavy) توصیه میشه که تعداد کپی بیشتری به ازای هر شارد داشته باشید تا عملیات جستجو سریعتر باشه ولی اگر بیشتر نوشتن و ایندکس کردن اتفاق میافته (Write Heavy) تعداد کپی بیشتر به معنی لود بیشتر روی استک برای پخش کردن این کپیها بین نودهای شماست.
ایجاد یک سرویس امن، اتکاپذیر و همیشه در دسترس کاری سخت، زمانبر و نیازمند دانش کافی از اون سیستم و تحقیق و توسعهی مداومه. کاری که در تیم SRE یکتانت در حال انجامش هستیم و داریم یک راه طولانی، پر از چالش و جذاب رو طی میکنیم. اگر فکر میکنید که این مسائل برای شما جذابه و دوست دارید در این راه کنار ما باشید حتما به صفحهی فرصتهای شغلی ما سر بزنید.


