
فناوری GPU-Direct که توسط NVIDIA توسعه یافته است به GPUها این امکان را میدهد تا به طور مستقیم با یکدیگر و با سایر بخشهای سیستم ارتباط برقرار کنند بدون آنکه نیاز به عبور از کانال CPU وجود داشته باشد. این تکنولوژی با کاهش تاخیر و افزایش سرعت انتقال دادهها، بهرهوری را در برنامههای محاسباتی با عملکرد بالا، یادگیری عمیق و هوش مصنوعی به طور قابل توجهی افزایش میدهد. با استفاده از GPU-Direct، دادهها میتوانند مستقیماً بین حافظههای GPU و سایر دستگاههای ورودی/خروجی منتقل شوند که منجر به بهبود کارایی و کاهش مصرف منابع سیستمی میشود. این فناوری به خصوص در محیطهای محاسباتی بزرگ و پیچیده که نیاز به پردازش همزمان حجم عظیمی از دادهها وجود دارد، مزایای بسیاری به همراه دارد. در ادامه معماری سطح بالا و عناصر مهم در استفاده از این فناوری را مرور می کنیم.
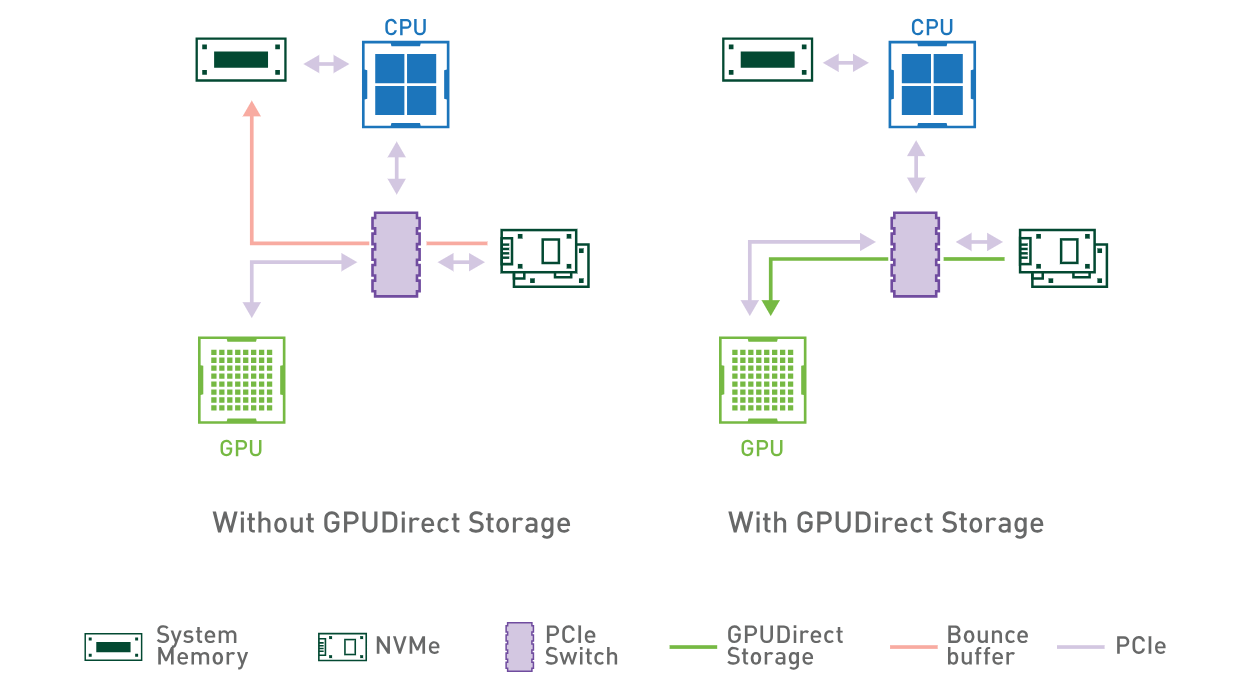
معماری سطح بالای GPUDirect شامل دو کاربرد مختلف است. یکی ارتباط مستقیم از استوریج به GPU بوده و دیگری ارتباط مستقیم از واسط شبکه به GPU است. همانطور که در شکل 1 نمایش داده شده است، با استفاده از فناوری GPUDirect دیگر نیازی به استفاده از حافظه اصلی سیستم و درگیر کردن CPU در خواندن/نوشتن روی استوریج نیست. بلکه این کار به صورت مستقیم و از طریق سوییچ PCIe به طور مستقیم انجام می گیرد (شکل سمت راست). اگر دسترسی به GPUDirect وجود نداشته باشد، لازم است تا اطلاعات ابتدا از استوریج به حافظه اصلی سیستم منتقل شده و سپس از طریق CPU در اختیار GPU قرار گیرند که در نتیجه سرعت و پهنای باند انتقال اطلاعات از طریق CPU خود گلوگاه شده و باعث می شود از ظرفیت پردازش بالا و موازی GPU نتوانیم به درستی بهره برداری کنیم (شکل سمت چپ).
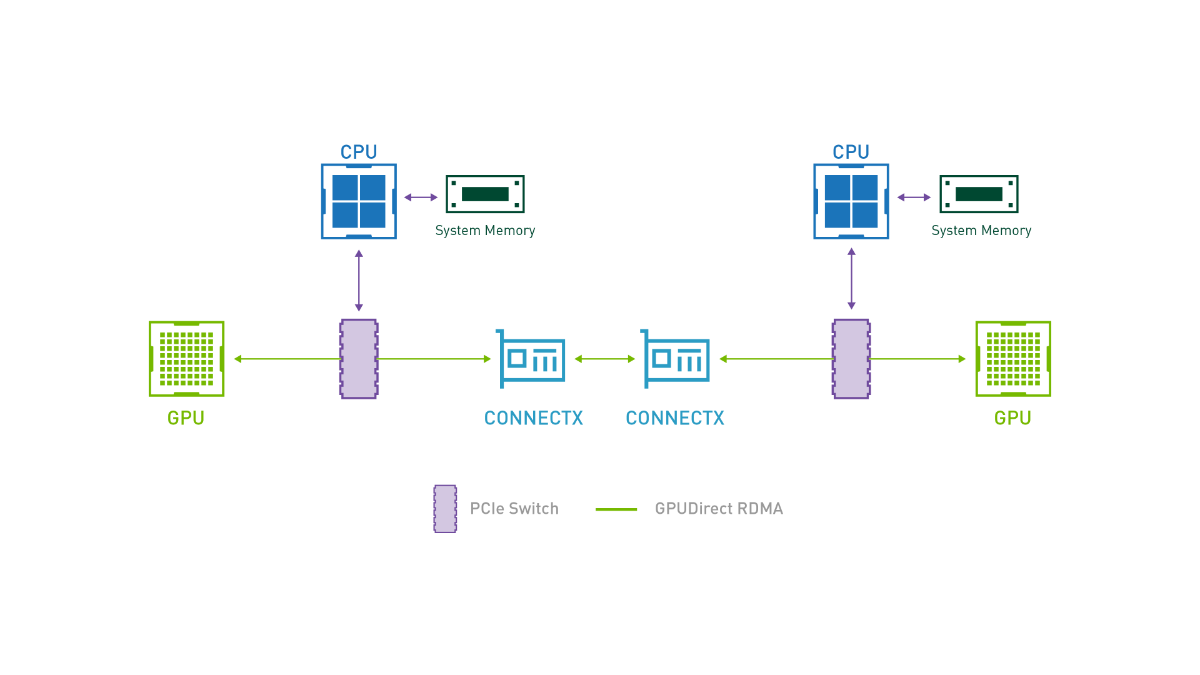
مدل دوم که در دنیای واقعی مسائل بیشتری را حل می کند خواندن مستقیم اطلاعات از روی واسط شبکه است. همانطور که در شکل 2 نشان داده شده، دو کامپیوتر که هر کدام دارای GPU هستند، می توانند از طریق واسط شبکه با یکدیگر و به طور مستقیم ارتباط داشته باشند. به این صورت که هر کدام از GPUها از طریق سوییچ PCIe به کارت شبکه متصل شده و از طریق فناوری GPUDirect می توانند به صورت مستقیم اطلاعات تبادل کنند. این کار باعث می شود تا با افزایش پهنای باند ورودی بتوان اطلاعات را به طور مستقیم، بدون واسطه و با سرعت بالا روی GPUها پردازش کرد. در این مدل، فناوری GPUDirect به قابلیت RDMA یا همان Remote Direct Memory Access وابسته است. این فناوری توسط کارت های شبکه از خانواده ConnectX ارائه می شود.
دقت شود که در هر دو مدل معماری GPUDirect، لازم است تا GPUها از قابلیت GPUDirect که توسط NVIDIA ارائه شده، پشتیبانی نمایند. در ادامه لیستی از GPUهایی که این فناوری را پشتیبانی می کنند، ارائه می گردد:
جهت بهره برداری از قابلیت GPUDirect، لازم است تا وابستگی های سخت افزاری و نرم افزاری مورد نیاز بررسی شود. در ادامه این وابستگی ها تشریح می شود:
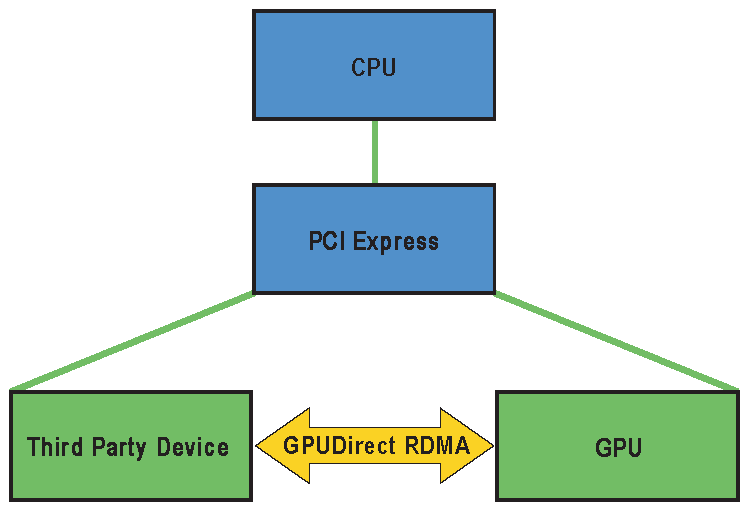
شکل 3 نمای کلی از ارتباطات مبتنی بر RDMA بین GPU و ابزارهای استوریج و شبکه را نمایش می دهد که عموما از طریق PCIe انجام می شود. فناوری ConnectX مبتنی بر همین ارتباطات توسعه یافته است. انواع واسط های شبکه مورد استفاده از این خانواده در ادامه می آید. سری کارتهای شبکه ConnectX شرکت NVIDIA برای ارائه عملکرد بالا، تأخیر کم و ویژگیهای پیشرفته در برنامههای مختلفی از جمله رایانش ابری، مراکز داده، هوش مصنوعی، یادگیری ماشین و محاسبات با عملکرد بالا (HPC) طراحی شدهاند. همه این کارتها از قابلیت GPUDirect پشتیبانی میکنند اما در سرعت، عملکرد و پهنای باند متفاوت هستند:
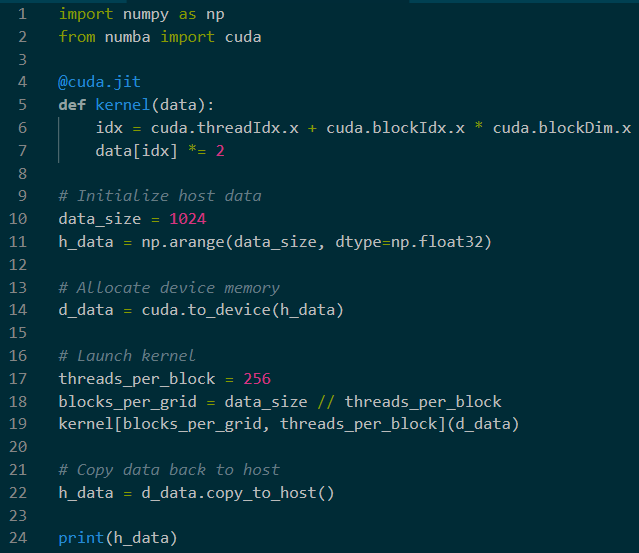
برای استفاده از فناوری GPUDirect با بهرهگیری از کتابخانههای CUDA، میتوان از زبانهای برنامهنویسی پایتون یا C استفاده کرد. در اینجا یک مثال ساده با هر دو زبان برای آشنایی بیشتر، تشریح میشود:
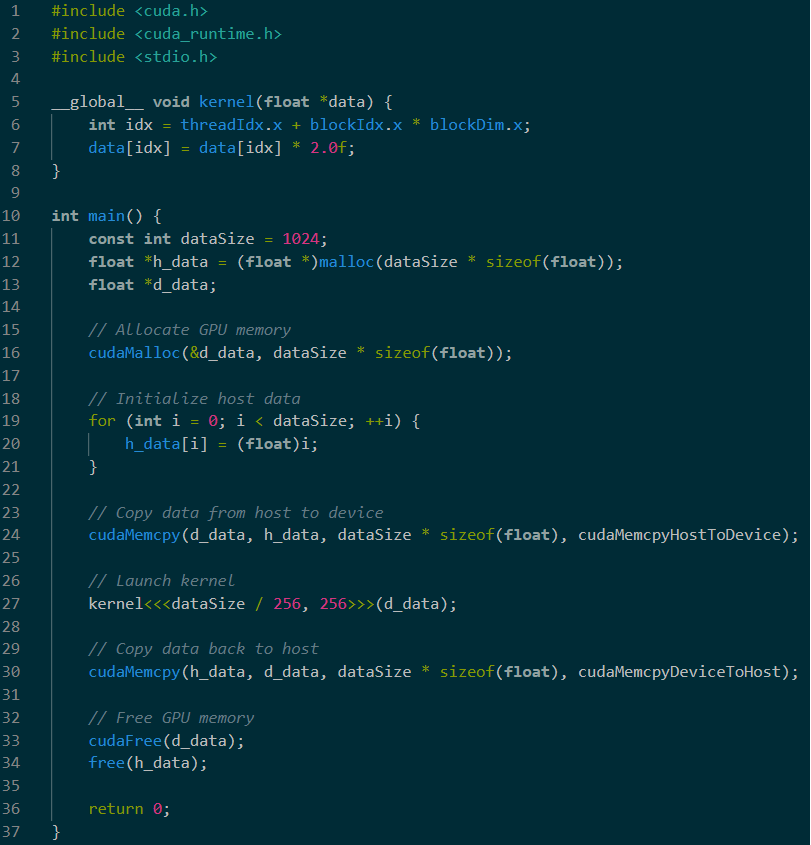
مثال زیر نحوه استفاده از GPUDirect RDMA را با زبان C نشان میدهد. این کد اجازه میدهد تا دادهها به صورت مستقیم بین حافظه GPU و دستگاههای دیگر انتقال یابند. در کد C یک آرایه از دادهها به اندازه 1024 عنصر در حافظه میزبان ایجاد و مقداردهی اولیه میشود. سپس حافظهای در GPU برای این دادهها تخصیص داده شده و دادهها از حافظه میزبان به GPU انتقال داده میشوند. یک کرنل CUDA به نام kernel روی دادههای GPU اجرا شده که در این کرنل، هر عنصر از آرایه دو برابر میشود. پس از اتمام محاسبات، دادههای تغییر یافته از GPU به حافظه میزبان برمیگردند. در نهایت، حافظه تخصیص داده شده در GPU آزاد و حافظه میزبان نیز آزاد میشود.
مثال زیر کد مشابهی را به زبان پایتون نشان میدهد که از کتابخانه Numba استفاده کرده و یک محیط برنامهنویسی مبتنی بر CUDA فراهم میکند. در کد پایتون زیر از کتابخانه Numba برای برنامهنویسی CUDA استفاده شده است. ابتدا یک آرایه از دادهها به اندازه 1024 عنصر در حافظه میزبان (host) ایجاد و مقداردهی اولیه میشود. سپس این آرایه به حافظه دستگاه (device) یعنی GPU انتقال داده میشود. کرنل CUDA که به نام kernel تعریف شده، دادهها را دو برابر میکند. این کرنل با استفاده از تعداد مشخصی از بلوکها و نخها اجرا میشود. در نهایت، دادههای تغییر یافته از GPU به حافظه میزبان برگردانده و چاپ میشوند.
منابع:


