
قصدم نوشتن نکات و حقه های اسکریپی بود که بعد از نظرسنجی قرار بر این شد که با یه آموزش کوتاه و سریع، کارهایی که میشه باهاش انجام داد رو نشونتون بدم و قبل از درگیر شدن با مسائلی که زیر کاپوت میگذره و ممکنه باهاش درگیر نشین، اول با دیدن سریعتر خروجی لذت کار کردن باهاش رو بچشین. تو پست های بعدی سعی میکنم کمکم نکات فنیترش رو هم بگم براتون.
اسکریپی یه فریمورک آزاد و اوپن سورسه که به درد جمع آوری اطلاعات از وبسایتها میخوره.
همونطور که میدونین کلی اطلاعات به درد بخور داخل اینترنت و وبسایت های مختلف هست که میتونین کلی کار با مزه باهاش انجام بدین.
اگر توسعه دهندهی وب هستین و برای سرویسی که راه انداختین نیاز به منبع اطلاعاتی دارین. اگر دیتاساینتیست هستین و نیاز به استخراج دیتا برای آنالیز و ترین کردن مدلتون دارین، اسکریپی میتونه گزینهٔ جذابی براتون باشه.
تو این آموزش با هم به راه اندازی پروژه ی اسکریپی و استخراج اسامی و اطلاعات تمامی هتل های ایران از سایت hotelyar.com و ذخیره کردنش داخل فایل به صورت JSON میپردازیم.
# میتونین به صورت سیستمواید و بدون استفاده از virtualenv اسکریپی رو نصبش کنید اما با استفاده از virtualenv دستتون توی انتقال پروژه و مدیریت پکیجها بازتره.
اول نیاز داریم تا اسکریپی رو نصب کنیم. env مورد نظرتون رو بسازین و بعد از اکتیو کردنش با این دستور اسکریپی رو نصب کنید:
(.env) $ pip3 install scrapy
بعدش با این دستور یه پروژه ی اسکریپی تعریف کنید:
(.env) $ scrapy startproject tutorial
بعد از اجرای این دستور یه دایرکتوری با ساختار زیر درست میشه (که قابل تغییره و این رو تو پست های بعدی میبینیم ).
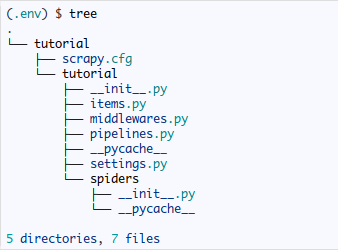
scrapy.cfg: این فایل مربوط به تنظیمات دیپلوی پروژه میشه که فعلا بهش نیازی نداریم.
middlewares.py: داخل این فایل میتونین عملیاتی که قبل یا بعد از زدن ریکوئست(تنظیم کردن پروکسی، تغییر هدر ریکوئست و این مدل کارها)، عملیاتی که انجین اسکریپی روی آیتم انجام میده و یه سری کارهای دیگه رو برای پروژه تعریف کنین.
pipelines.py: به وسیله ی پایپلاین میتونین آیتم اکسترکت شدهٔ نهایی رو تمیز کنین یا داخل فایل یا دیتابیس مقصد ذخیره کنین.
settings.py: اینجا هم میتونین تنظیمات گلوبال پروژه رو تعریف کنین. آدرس دیتابیس، فعال و غیر فعال کردن middleware ها و pipeline ها و یه سری تنظیمات دیگه اینجا انجام میشه.
قبل از اینکه شروع کنین به نوشتن اسپایدر اول سایت رو دقیق بررسی کنین. ببینین چه اطلاعاتی رو میخواین و چطوری باید بهش رسید.
تو این لینک لیست تقریبا کاملی از هتل های ایران داریم.
یه فایل پایتون به اسم hotels.py داخل دایرکتوری spiders تو مسیر پروژمون با محتویات زیر میسازیم.
چند نوع اسپایدر وجود داره برای اکستند کردن داخل کلاسی که میسازین من ترجیح میدم از همین کلاس پیش فرض و ساده و ابتدایی scrapy.Spider استفاده کنم. لیست کامل مدل های مختلف و کارایی اسپایدرها رو میتونین داخل این لینک ببینین:
https://doc.scrapy.org/en/latest/topics/spiders.html
# توجه کنین که کل مراحل درخواست زدن async انجام میشه و اگر ببینین داخل متد scrapy.Request، مقدار callback رو روی تابعی که مرحله ی بعد تو بازی میاد تنظیم کردم.
اگر به لینکی که ما رو به هتل ها میرسونه نگاه کنین همشون یه الگو خاص دارن:
https://hotelyar.com/hotel/84/...
میتونیم همهی لینک ها رو از صفحهی اول استخراج و یونیک کنیم و داخلش دنبال اون لینکی بگردیم که دوبار کلمهی hotel داخلش تکرار شده.
# اگر کلمهی hotel داخل یه لینکی دوبار تکرار بشه حاصل split کردن لینک به کلمهی hotel میشه یه آرایه با ۳ عضو، غیر این باشه هم به کارمون نمیاد. (خط ۲۴)
در آخر هم بعد از ذخیره سازی اسپایدر رو با اسمی که براش گذاشتیم اجرا میکنیم.
(.env) $ scrapy crawl hotel_info -o hotel.jl
اطلاعات استخراج و داخل فایل hotel.jl به صورت json ذخیره میشن.
در نهایت هر کدوم از json ها رو میتونین داخل این سایت بررسی کنین و با فرمت آدمیزادی ببینیدش D:
در آخر نکته هایی که باید بهش توجه بشه callback ها هستن که حتما یکم باهاشون بازی کنین. متد جدید بنویسین و سعی کنین پروسه رو پیچیده کنین. هر متدی که نوشته شد شبیه ساز یکی از مراحل از باز کردن صفحهی حاوی لینک تا پیدا کردن لینک صفحات هتل ها و در نهایت استخراج اطلاعات بود. خیلی این پست طولانی شد و به نظرم خلاصه ترین مدلی بود که میتونستم ازش در بیارم. باز هم اگر نکتهای بود خوشحال میشم بهم اطلاع بدین.
لینک های مفید:
https://www.w3schools.com/xml/xpath_intro.asp
https://doc.scrapy.org/en/latest/index.html


