
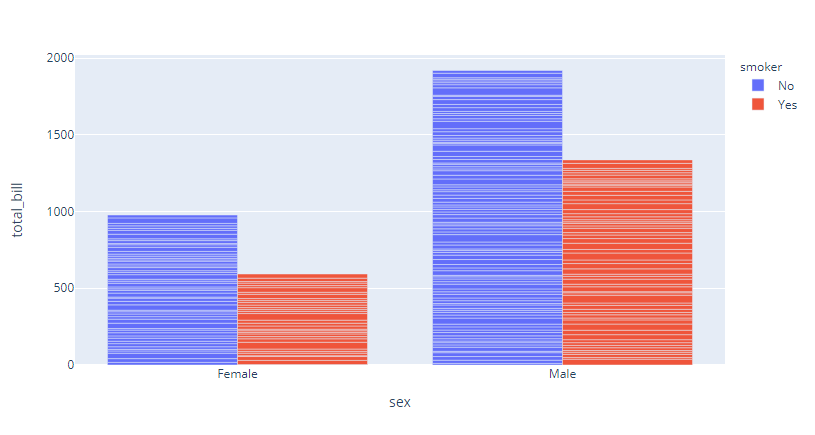
df = px.data.tips() fig = px.bar(df, x="sex", y="total_bill", color="smoker", barmode="group") fig.show()
براحتی میتوان با آرگمان هایی که نشان دادیم، لیبل های X و Y را نام گذاری کرد و لجند را با color تعیین کردیم.
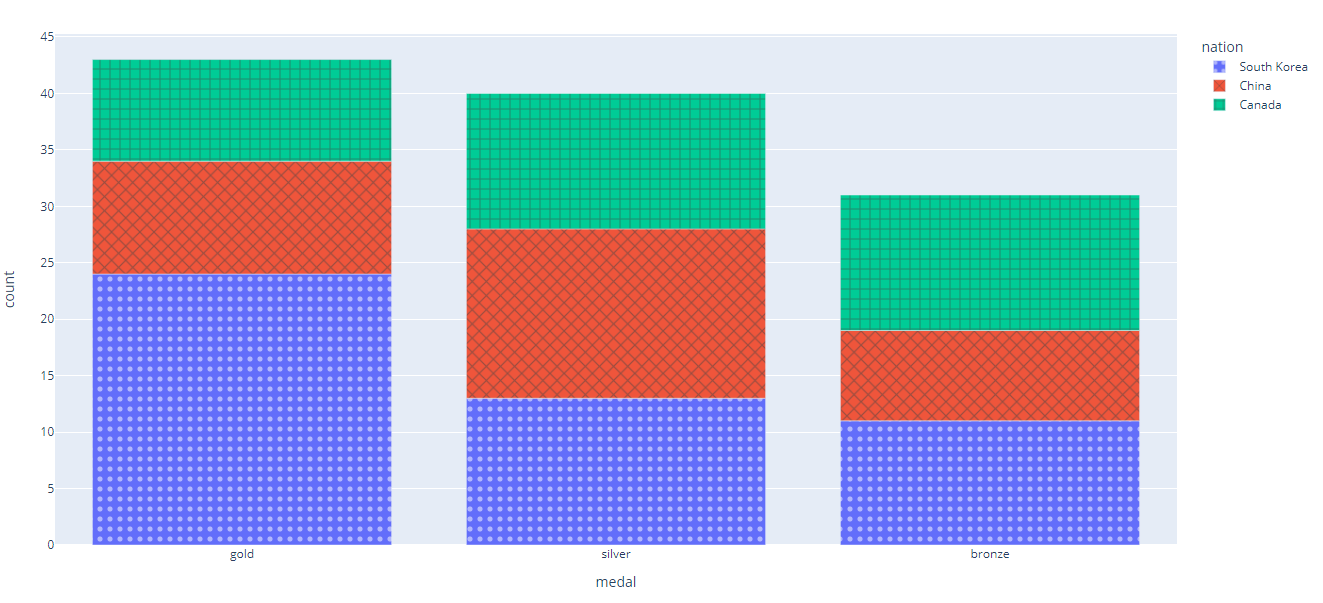
از آرگومان های px میتوان برای هم نوع هاشور و نام ستون اطلاعات موثر در نوع هاشور استفاده کرد.
df = px.data.medals_long() fig = px.bar(df, x="medal", y="count", color="nation", pattern_shape="nation", pattern_shape_sequence=['.', 'x', '+']) fig.show()
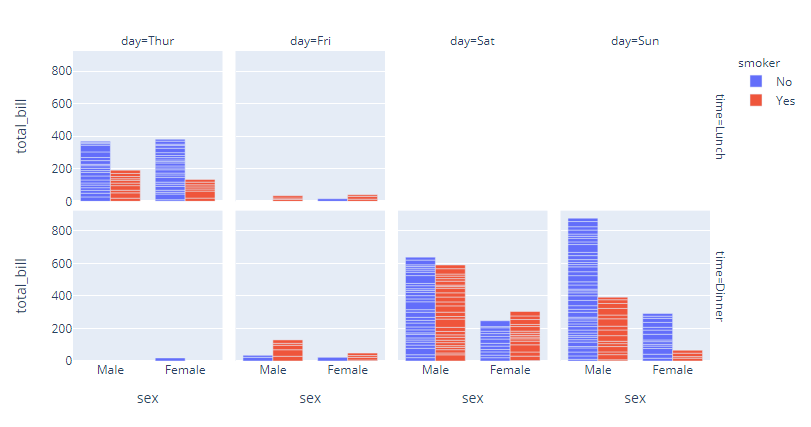
df = px.data.tips() fig = px.bar(df, x="sex", y="total_bill", color="smoker", barmode="group", facet_row="time", facet_col="day", category_orders={"day": ["Thur", "Fri", "Sat", "Sun"], "time": ["Lunch", "Dinner"]}) fig.show()
این آرگومان برای زمانی میباشد که چند نمودار مربوط به یکدیگر در شکل باشد و شکل، لیبل عمودی و
افقی جامعی برای دسته بندی این نمودار ها داشته باشد.
این آرگومان ها را میتوان برای انواع نمودار های تک بعدی و دو بعدی استفاده کرد؛ و برای بعضی از نمودار های
سه بعدی. مثال بعدی را نیز در مورد نمودار scatter میزنیم.
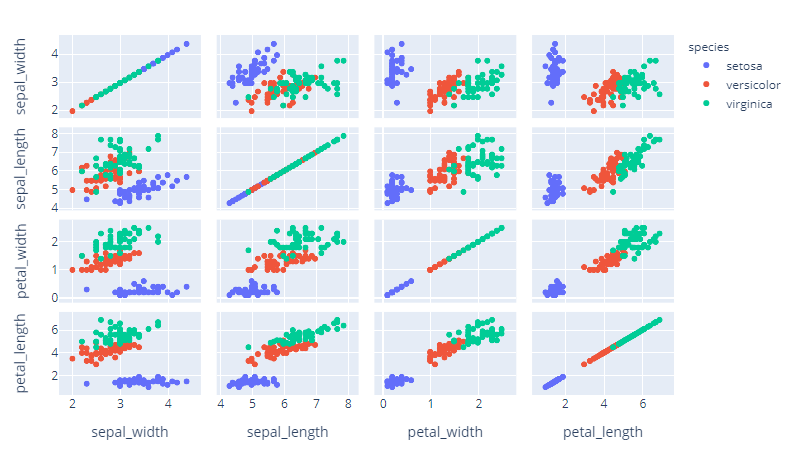
df = px.data.iris() fig = px.scatter_matrix(df, height=500, dimensions=["sepal_width", "sepal_length", "petal_width", "petal_length"], color="species") fig.show()
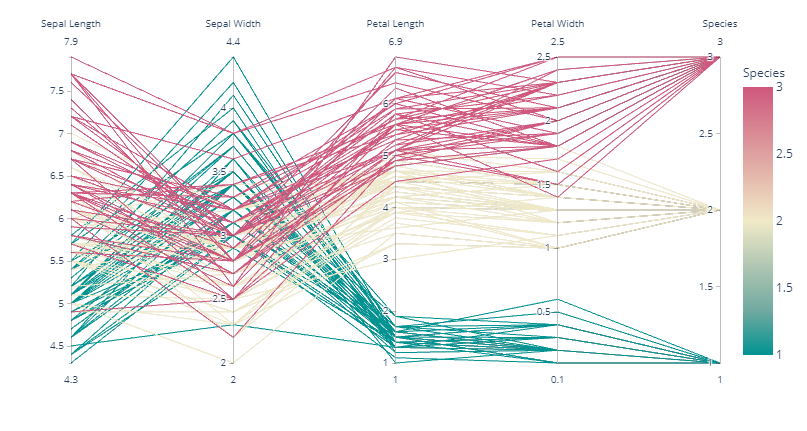
در این سبک از نمودار، هر ردیف از دیتافریم ما با یک علامت چند خطی نشان داده می شود که مجموعهای از محورهای موازی را طی می کند، که هر سطر برای یک بعد است.
df = px.data.iris() fig = px.parallel_coordinates(df, color="species_id", labels={"species_id": "Species", "sepal_width": "Sepal Width", "sepal_length": "Sepal Length", "petal_width": "Petal Width", "petal_length": "Petal Length", }, color_continuous_scale=px.colors.diverging.Tealrose, color_continuous_midpoint=2) fig.show()
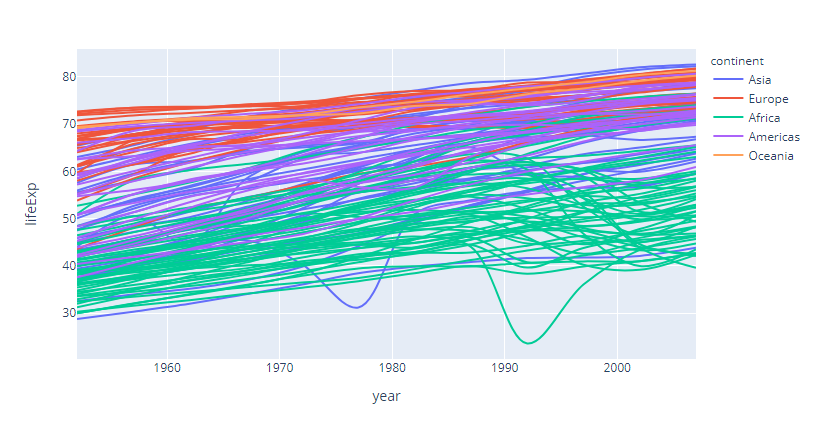
df = px.data.gapminder() fig = px.line(df, x="year", y="lifeExp", color="continent", line_group="country", hover_name="country", line_shape="spline", render_mode="svg") fig.show()
نکته: همانگونه که میبینید، تمامی این داده ها به صورت آماده در ماژول پلاتلی اکسپرس موجود است.
از لحاظ اندازه، این اطلاعات از سال 1957 تا 2010 جمع آوری شده.
خروجی:
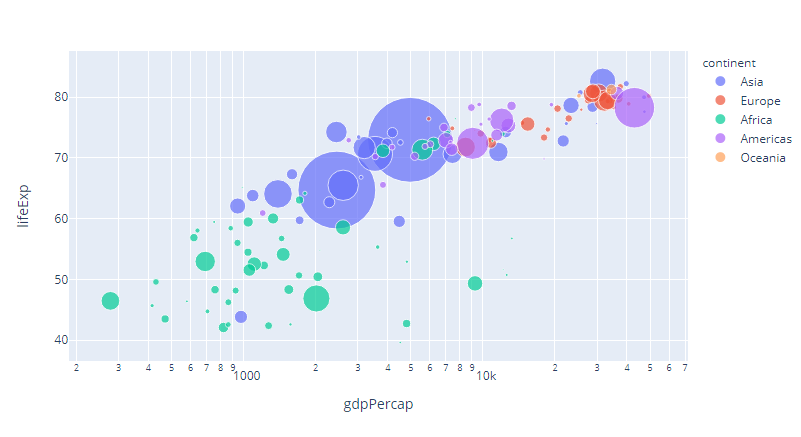
میتوان با آرگومان size سایز هر نقطه را بر اساس ستونی از داده ها مقدار دهی کرد. همچنین با آرگومان log_x میتوان تراکم نقاط در نمودار را یکپارچه کرد.
df = px.data.gapminder() fig = px.scatter(df.query("year==2007"), x="gdpPercap", y="lifeExp", size="pop", color="continent", hover_name="country",log_x=True, size_max=60) fig.show()
برای تمیز تر بودن نمودار، کشور های کوچکتر را به عنوان other countries ، جدا میکنیم.
df = px.data.gapminder().query("year == 2007").query("continent == 'Europe'") df.loc[df['pop'] < 2.e6, 'country'] = 'Other countries' fig = px.pie(df, values='pop', names='country', title='Population of European continent') fig.show()
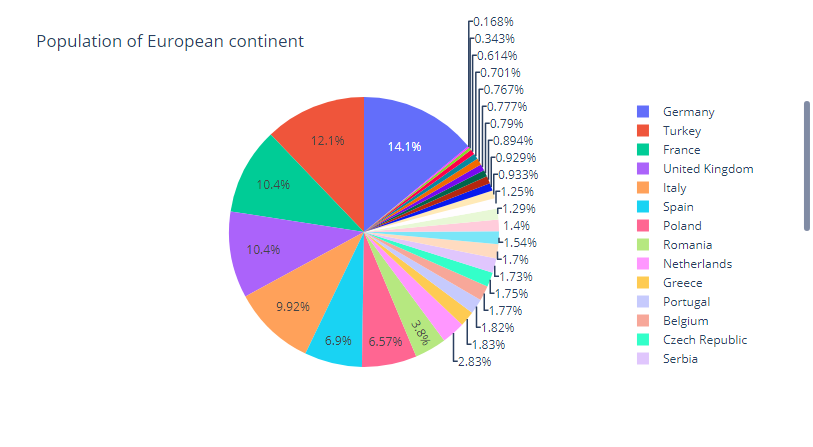
لیست کشور ها قابل اسکرول بوده و تمام کشورها با جمعیت بیش از دو میلیون در این لیست هستند، و در انتهای لیست، other countries قرار دارد.
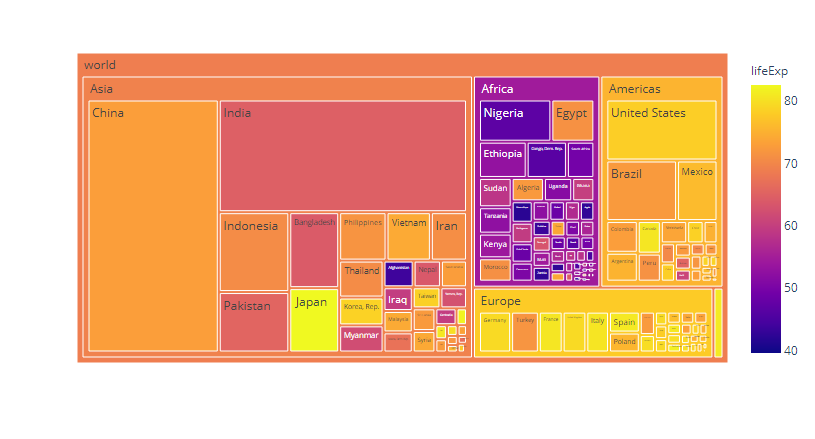
این نوع نقشه را معمولا در نقشه ی بورس به کرات مشاهده کرده ای د و با عملکرد آن نیز آشنایی دارید.
df = px.data.gapminder().query("year == 2007") fig = px.treemap(df, path=[px.Constant('world'), 'continent', 'country'], values='pop', color='lifeExp', hover_data=['iso_alpha']) fig.show()
نکته: خروجی متد gapminder() یک دیتافریم است که میزان امید به زندگی را در هفتاد سال اخیر جمع آوری
کرده است. منبع آن هم از سایت gapminder.org میباشد که به جمع آوری داده های غیرقابل دسترسی معروف
است.
خروجی:
خب تا اینجا تقریبا یه چیزایی راجع به پلاتلی اکسپرس و نحوه پیاده سازی نمودارای مختلف رو یاد گرفتیم. تو
قسمتای بعدی بیشتر وارد جزییات میشیم و سعی میکنیم به شکل های حرفه ای تر نزدیک شیم.
انجمن هوش مصنوعی دانشگاه اصفهان
احسان قیچی ساز
امیر محسن براهیمی
ابوالفصل شیشه گر
علیرضا عشقی


