
نمودار های BarPlot
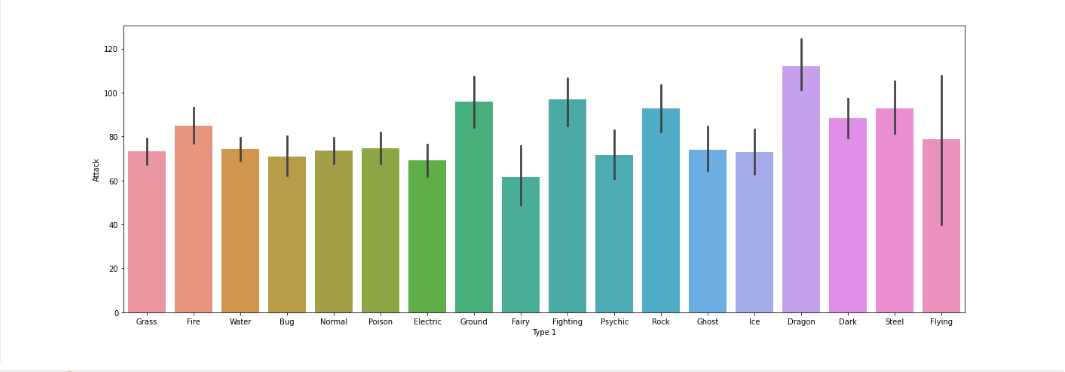
نمودار های Bar plot یا نمودار میله ای رابطه بین یک متغیر عددی و یک متغیر طبقه ای را نشان میدهد. این تابع پارامتر های مختلفی میگیرد .دو تا از مهم ترین پارامتر های این تابع :
متغیر محور افقی نمودار : X
متغیر محور عمودی نمودار : Y
plt.figure(figsize=(20,7))
sns.barplot(x=pokemon['Type 1'], y= pokemon['Attack'])
plt.show()
مرتب سازی نمودار براساس یک متغیر به کمک متد groupby():
plt.figure(figsize=(20,7))
order = pokemon.groupby(['Type 1']).mean().sort_values('Defense' , ascending = False).index
sns.barplot(x=pokemon['Type 1'], y= pokemon['Defense'] , order=order)
plt.show()
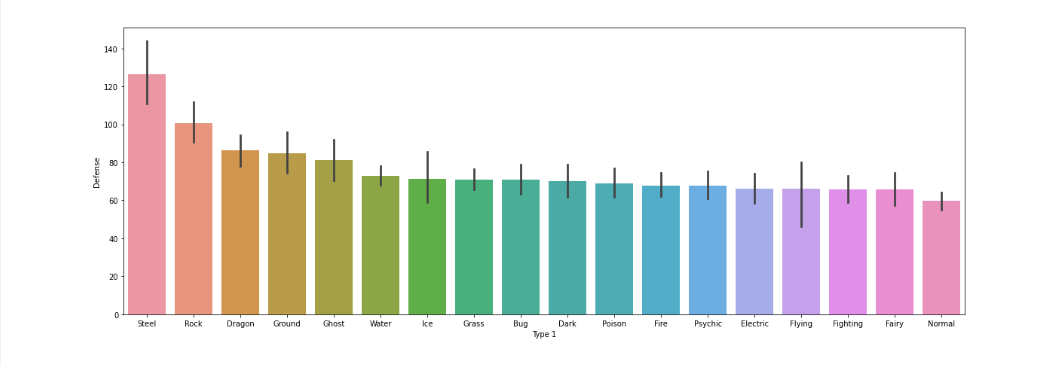
در نمونه ی بالا، نمودار براساس متغیرDefence به طور نزولی مرتب شده است.
نمودار count یک مورد خاص برای نمودار میله ای زمانی است که می خواهید تعداد مشاهدات هر دسته را به جای محاسبه آماری برای متغیر دوم نمایش دهید.
titanic = sns.load_dataset("titanic") #load dataset
sns.catplot(x="deck", kind="count", palette="ch:.25", data=titanic)
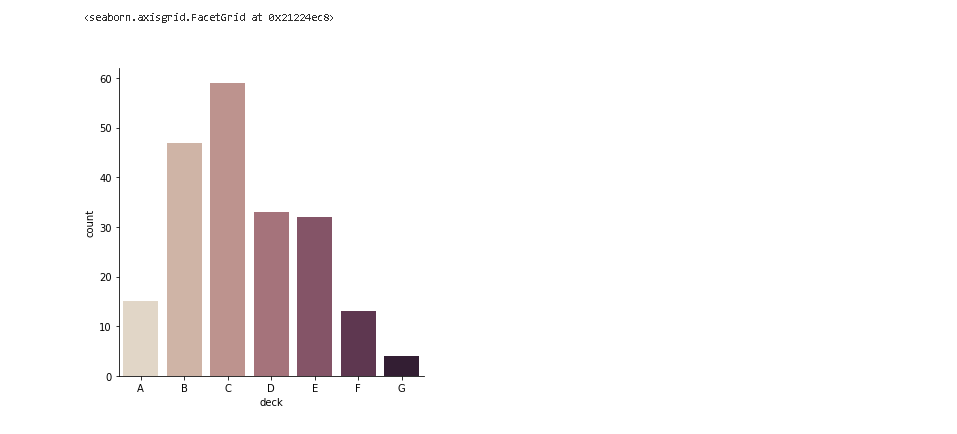
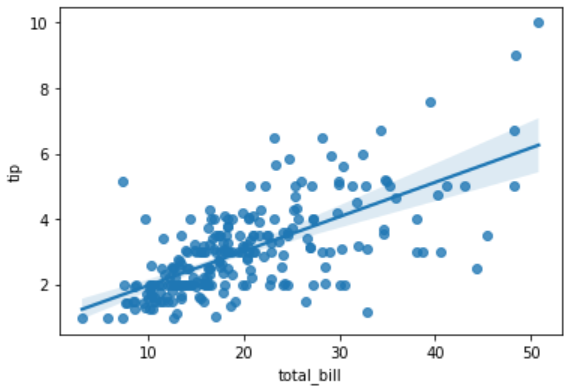
در کتابخانه ی Seaborn می توانیم در نمودارهای scatter خط رگرسیون رسم کنیم جهت بررسی مجدد قدرت رابطه ی بین داده ها و یا پیدا کردن بهترین خط که با داده ها مطابقت دارد:
تابع RegPlot() با گرفتن متغیر های x و y مدل رگرسیون را روی آن اعمال می کند مانند زیر:
tips = sns.load_dataset("tips") #load dataset
sns.regplot(x="total_bill", y="tip", data=tips)
برای بررسی اینکه آیا مدل رگرسیون ساده می تواند برای دیتاست به کار گرفته شده مناسب باشد یا خیر از دستور زیر استفاده می کنیم:
anscombe = sns.load_dataset("anscombe") #load dataset
sns.residplot(x="x", y="y", data=anscombe.query("dataset == 'I'"), scatter_kws={"s": 80})
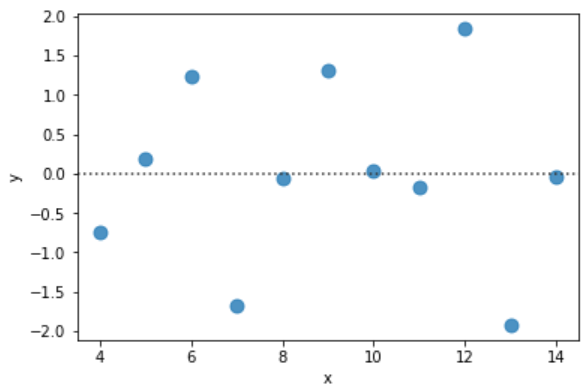
به دلیل اینکه مقادیر به صورت پراکنده اطراف خط y=0 قرار گرفته اند، مدل رگرسیون ساده مناسب برای این دیتاست می باشد.
sns.residplot(x="x", y="y", data=anscombe.query("dataset == 'II'"), scatter_kws={"s": 80})
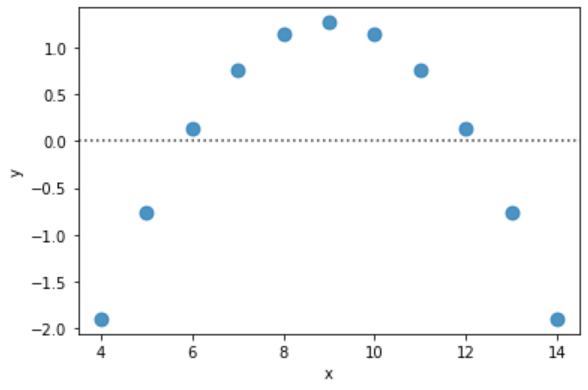
در این حالت مقادیر اطراف خط y=0 پراکنده نیستند و نظم خاصی دارند، پس میتوان گفت رگرسیون ساده مناسب این دیتاست نیست.
برای بررسی وضعیت داده مورد نظر نسبت به سایر متغیر ها از دستور زیر کمک می گیریم:
sns.lmplot(x="total_bill", y="tip", hue="smoker", data=tips)
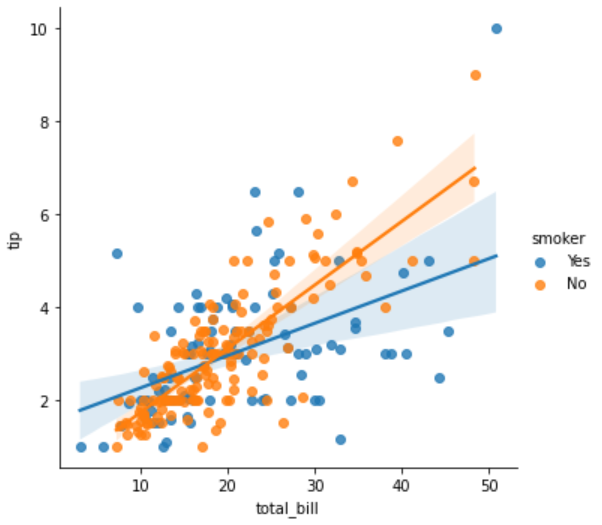
همچنین می توان به شکل زیر وضعیت یک متغیر را مشروط به متغیر یا متغیر های دیگر بررسی کنیم:
sns.lmplot(x="total_bill", y="tip", hue="smoker", col="time", data=tips)
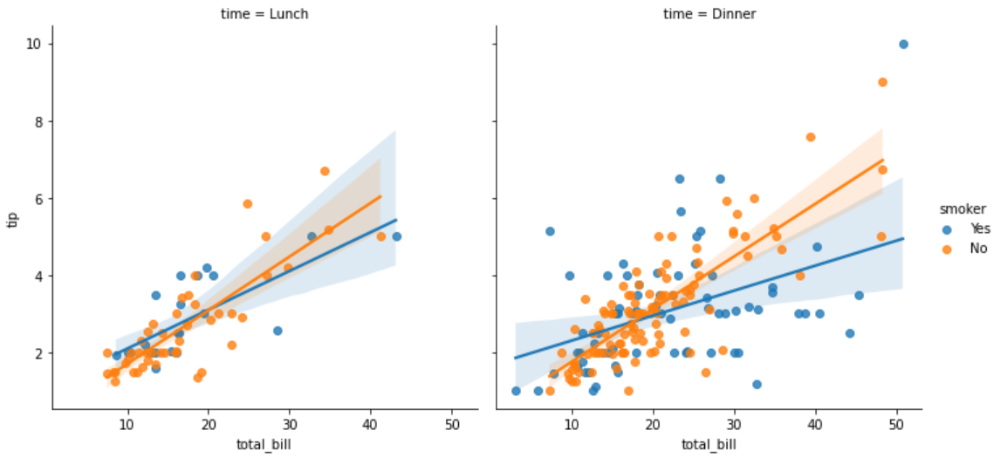
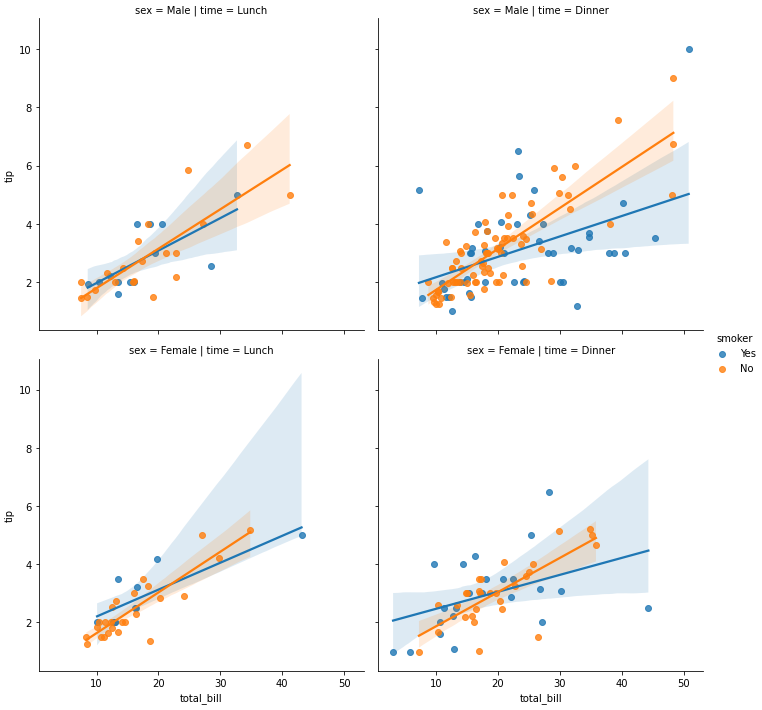
پارامتر های row, col متغیرهایی که زیرمجموعه ها را برای ترسیم در وجوه مختلف تعریف می کنند:
sns.lmplot(x="total_bill", y="tip", hue="smoker", col="time", row="sex", data=tips)
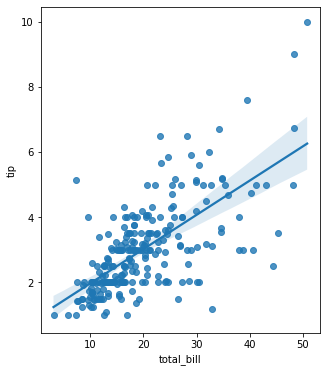
برای تغییر اندازه ی نمودار های regplot() همانند آنچه که در کتابخانه ی matplotlib.pyplot انجام می دادیم، عمل میکنیم:
f, ax = plt.subplots(figsize=(5, 6))
sns.regplot(x="total_bill", y="tip", data=tips, ax=ax)
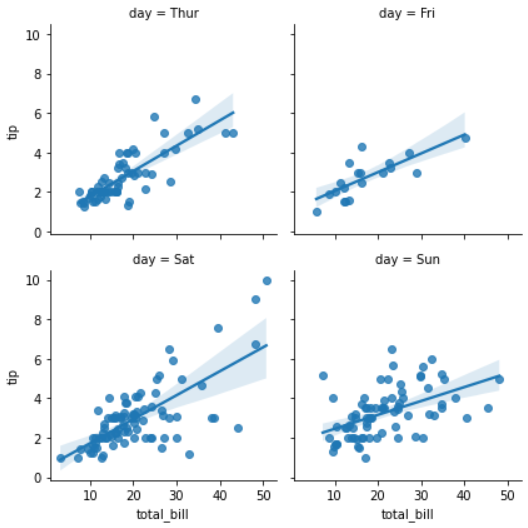
ولی برای تغییر اندازه ی نمودار های lmplot() مسیر متفاوت است و طبق قطعه کد زیر پیش می رویم:
sns.lmplot(x="total_bill", y="tip", col="day", data=tips, col_wrap=2, height=3)
منبع آموزش : وبسایت کتابخانه ی Seaborn
انجمن هوش مصنوعی دانشگاه اصفهان
محمد جعفرپور
مریم سادات صفوی
دانیال توکلی


