
بسم الله الرحمن الرحیم
یکی از چالشهای اساسی در NLP، پاسخ طولانی به پرسشهای دامنهبازه که مثلا مدل باید حداقل اندازهی یک پاراگراف به یک سوال با هر موضوعی پاسخ بده و خب اگر مدل خوب عمل کنه، میتونه باعث بشه مردم با مراجعه به این مدلها و پرسیدن سوالشون کلی چیز جدید یاد بگیرند. اما هنوز مدلهای هوشی ضعیفتر از آدمها عمل میکنند.
مدلهای قبلی در این مسئله عمدتا از دو بخش بازیابی اطلاعات و ترکیب تشکیل شده بودند. حالا شرکت OpenAI در مقالهای به نام WebGPT: Browser-assisted question-answering with human feedback، مدلی به نام WebGPT داده و به این مسئله به شکل جدیدی حمله کرده؛ بخش بازیابی اطلاعات رو با استفاده از API موتور جستجوی بینگ شرکت مایکروسافت ردیف کرده و قسمت ترکیب رو هم با استفاده از مدل هیولایی GPT-3 پیش برده!!! در این پست خلاصهای از نحوهی کار و نتایج این مدل رو بررسی میکنیم.
شرکت OpenAI با یه تیم متشکل از یه نیسان آدم اومده GPT-3 رو فاینتیون کرده تا بتونه سوالهای دامنهباز رو با استفاده از یک مرورگر (browser) پاسخ بده! یعنی واقعا یه مرورگر تکستی درست کردند و دادند دست مدل GPT-3 که با بینگ (موتور جستجوی مایکروسافت) سرچ کنه و جواب رو تولید کنه. مدل رو با استفاده از imitation learning (در خیلی از مسائل یادگیری تقویتی با شرایطی مواجه میشیم که یا تابع پاداش بسیار تنک (sparse) است و در انتهای چند گام به ما داده میشه یا این که تعریف مشخصی از تابع پاداش وجود نداره مثل رانندگی ماشین خودران. در این شرایط یک تکنیک به نام imitation learning وجود داره که در اون به جای این که عامل از روی تابع پاداش تنک سیاست رو یاد بگیره، سناریوهای اجرا شده به وسیله متخصص اون کار رو به عامل نشون میدیم و عامل بایستی سعی کنه به وسیله تقلید کارهای اون متخصص سیاست بهینه رو یاد بگیره) و روی ترکیب دادگان ELI5 و TriviaQA آموزش دادند تا مدل یاد بگیره که چجوری باید سوال رو توی اینترنت سرچ کنه، پارگرافهای مناسب رو انتخاب کنه و به اون پاراگراف هم ارجاع بده! به مدل در هر مرحله، یک سوال و state مرورگر داده میشه و مدل هم بایستی یک سری کامند مثل search و qoute و find in page و …. رو وارد کنه. بعد که اینجوری متن جمع میکنه، باهاش متن جواب رو تولید میکنه (نه اینکه فقط چند تا پاراگراف رو به هم بچسبونه). این مدل برای پاسخهایی که تولید میکنه از انسان بازخورد هم میگیره و تونسته در بعضی جاها از انسان هم بهتر عمل کنه. تاکید میکنیم که واقعا یاد میگیره که خودش بگرده توی سایتها و جواب رو تولید کنه و تحویل بده. نمونهی نحوهی جمعآوری داده و پاسخ به سوال مدل هم در این ویدیوئیه که در ادامه آوردیم. میتونید ببینید مدل برای پاسخ به سوال «شکسپیر چه وقت رمانهای هری پاتر رو نوشت؟» چی سرچ میکنه و در نهایت چه جوابی میده. با این مدل سعی کردند میزان «دقت حقیقتگویی» (factual accuracy) مدل زبانی رو افزایش بدهند. البته از چهار روش برای آموزش مدل استفاده کردند که توضیح مختصری از هر کدوم رو میتونید در خود مقاله در بخش 3.2 بخونید.
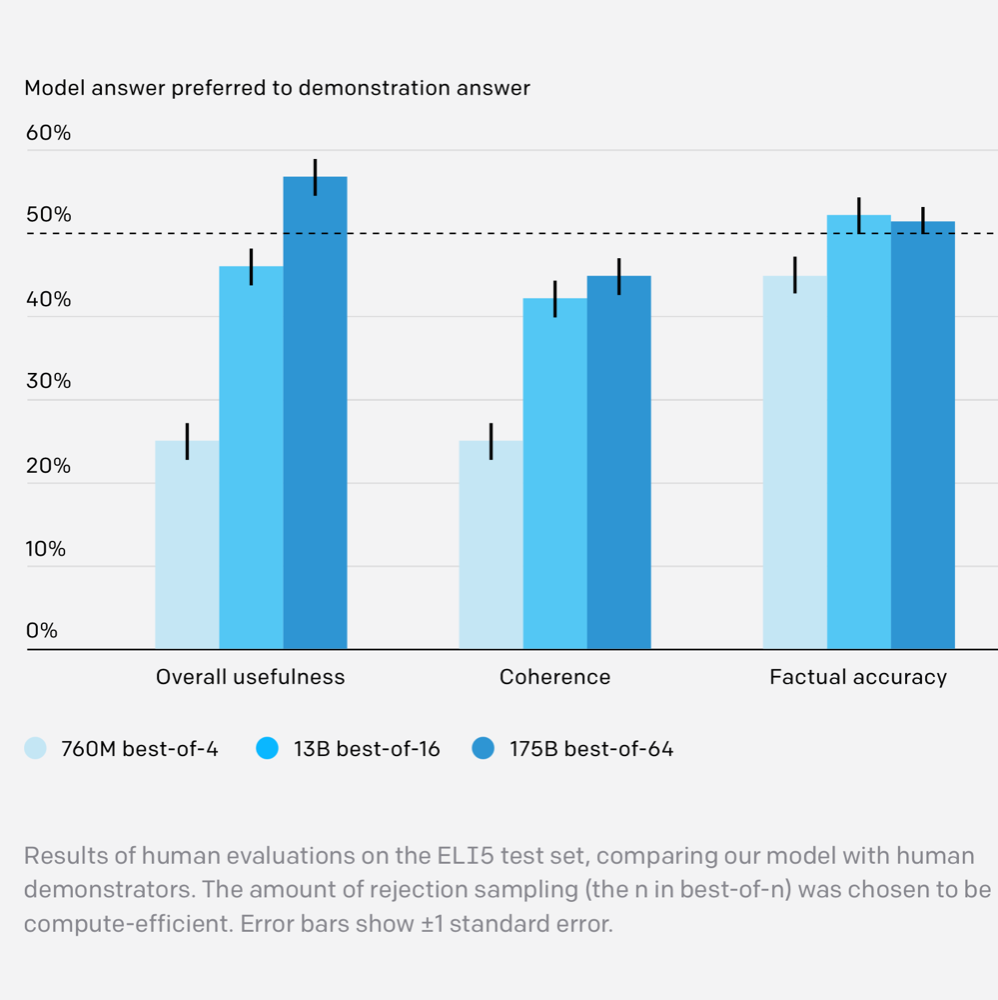
مدل رو اومدند در چند بخش ارزیابی کردند: اول دیتاست ELI5 که سوالاتیه که ملت در subreddit با عنوان Explain Like I’m Five پرسیده بودند. جوابهایی که مدل داده در ۵۶ درصد مواقع بهتر از جواب انسان بوده!!
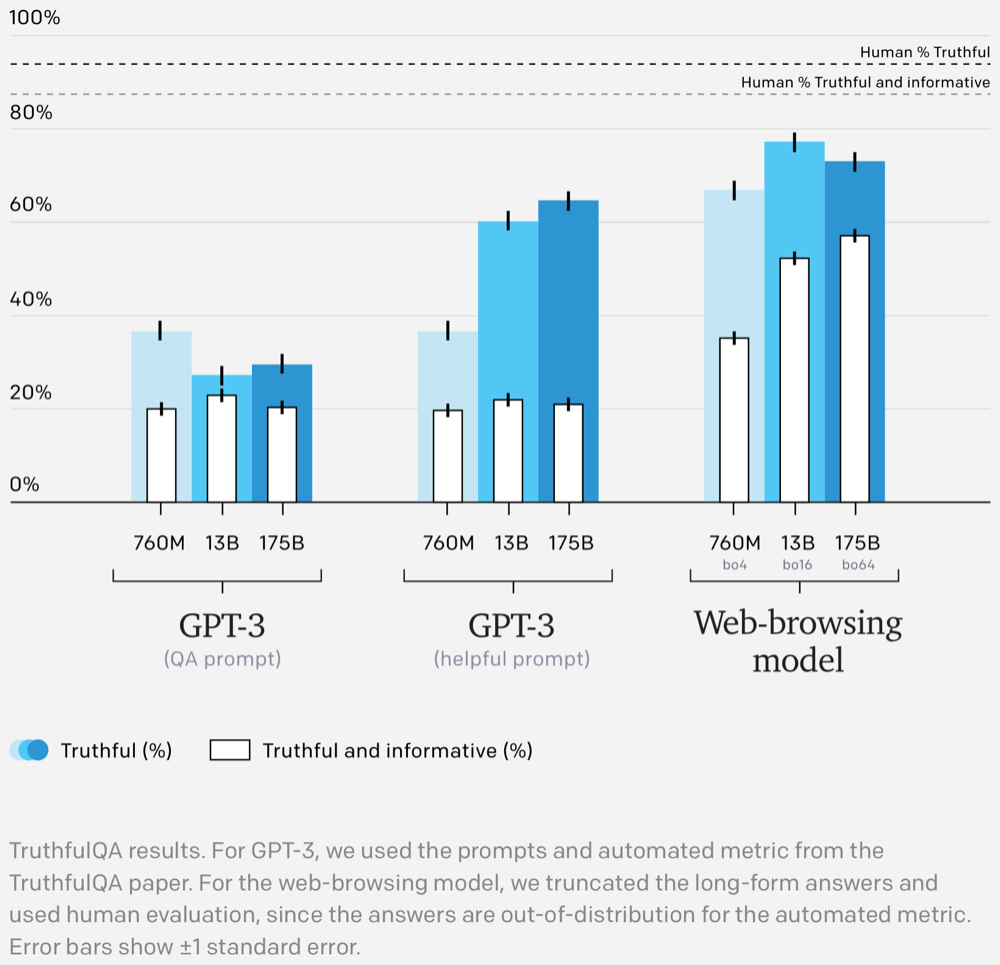
دوم اومدند میزان موثق و مفید بودن مدل رو با استفاده از معیار مقالهی TruthfulQA سنجیدند و در این بخش، مدل از مدلهای برپایهی GPT-3 قبلی بهتر عمل کرده ولی هنوز با مدل انسانی فاصله داره که نویسندگان، دلیلش رو آوردن جواب از بعضی لینکهای غیرعلمی و غیرقابل اعتماد میدونند و مشکل رو پیدا کردند و گفتند سعی میکنیم با تکنیکهای adversarial training این رو حل کنیم!
بعد هم اومدند میزان حقیقت پاسخهای مدل رو ارزیابی کردند. آدمهای ارزیاب، پاسخهای خیلی فنی و مبهم رو هم با استفاده از میزان موثق بودن لینکهای منابع ارزیابی کردند. مدل هنوز در این قسمت مشکلات پایهای داره (در ادامه چندتاشو هم آوردیم) و مشکل بعدی هم اینه که با این روش ارزیابی، مدل بعد از یه مدت یاد میگیره لینکهایی که آدمها (که مدل داره ازشون فیدبک میگیره) دوست دارند رو به عنوان منبع بذاره. برای حل این یکی مشکل هم گفتند از روش Debate که در یک مقاله دیگه مطرحش کردند قراره استفاده کنند (این روش رو هم انشاءالله در پستی دیگر توضیح خواهیم داد).
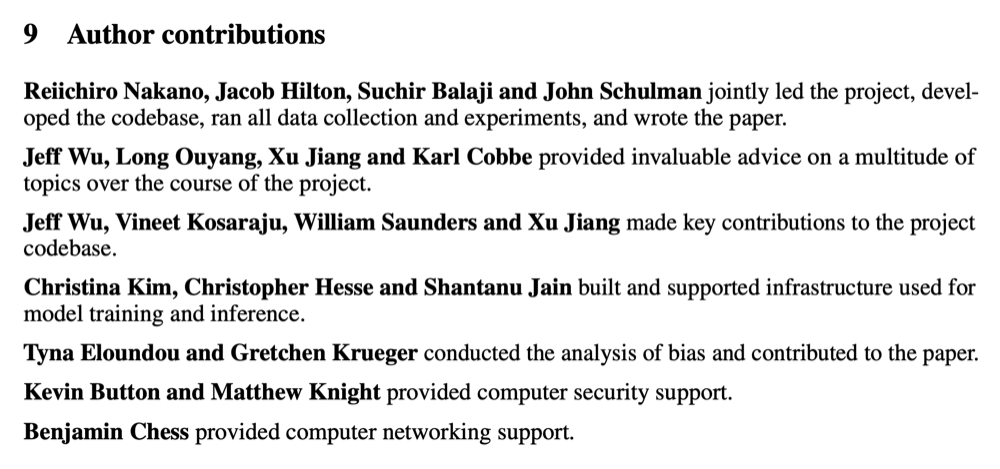
پ.ن. در آخر ترکیب تیم رو در بخش Author contributions مقاله ببینیم تا ببینیم با کار تیمیه که میشه به همچین نتایجی رسید. هوشیها و نرمافزاریهای تیم به کنار؛ سه نفر زیرساخت راه انداختند و دو نفر امنیت شبکه و کامپیوترها رو برعهده داشتند!!
در این پست ما رویکرد جدید مدل WebGPT از شرکت OpenAI و نتایجش رو به صورت خلاصه و مفید بررسی کردیم. اگر میخواهید ته قضیه رو دربیارید این دو لینک رو دریابید:
لینک بلاگ توضیح مقاله:
https://openai.com/blog/improving-factual-accuracy/
لینک خود مقاله:
https://arxiv.org/abs/2112.09332
خوشحال میشیم شما رو هم در کانال تلگرام nlp_stuff ببینیم و اگر پست یا نوشتهی خوبی داشتید ندا بدید تا در کانال و انتشارات بگذاریم.


