
یکی از مسائلی که نیروهای جدید در تیمهای مختلف میاره باهاش مواجه میشدن این بود که بین تعداد زیاد فرمها و ضرایب و کانفیگهای مختلف توی محصول نمیدونستن که باید کدوم رو انتخاب کنن. مثلا:
از کجا میتونم ماموریتها رو آپلود کنم؟
درآمد سفیر اگه توی مجموعه معطل بشه چطور حساب میشه؟
الان یه مشتری مهم داریم که میخوایم خودمون براش اکانت بسازیم و بهش توکن بدیم. چه فرایندی باید طی بشه؟
چه مدارکی برای ثبتنام سفیران نیازه؟ اصلا حداقل سن ثبتنام چقدر هست؟
از طرف دیگه مدیران ارشد نیاز داشتن که برای ارائههایی که در جلسات سطح بالاتر ارائه میدن آخرین ریلیزهای مهم رو داشته باشن یا برای رترو بخوایم مرور کنیم که در ماه/فصل/سال گذشته چه تسکهای شاخصی رو انجام دادیم. ولی خب پیدا کردن مهمترین ریلیزها از بین تعداد زیادی ریلیز کوچیک و بزرگ کاری شدنی اما زمانبر بود. همهی اینها ما رو به این سمت برد که با تب و تاب LLM که چند ماه پیش شروع شده بود دورنمایی رو برای «میترا» متصور بشیم.
نقطهی ایدهآلی که برای میترا متصور هستیم یه دستیار همه کاره توی میاره هست.
هر بخش از دانش میاره یک جایی ذخیره شده. مثلاً تیم پروداکت تمام تغییرات محصول رو در قالب ریلیزنوت داخل Google Doc ثبت میکنه و وقتی فیچر فعال شد اون رو اطلاعرسانی میکنن.
فرایندهای داخلی هم توی Google Doc نگهداری میشن؛ از Welcome Letter تیم فنی و محصول گرفته تا handbook فرایندهای داخلی.
بهجز اینها، کدبیسهامون روی GitLab قرار داره و بردی که توش تسکها رو مدیریت و مستند میکنیم هم در عمل بخشی از همین پایگاه دانش حساب میشه.
نهایتا متصوریم که دسترسی همهی اینها رو به میترا بدیم و میترا هر موقع که ازش درخواست شد، بتونه از هر کدوم از اینا استفاده کنه. مثلا:
میترا به ریلیزنوتها دسترسی داره. پس میتونه خیلی راحت به سوالات مرتبط با محصول جواب بده.
میترا به کدبیس میاره و جزئیات تسکها دسترسی داره. پس میتونه مطمئن باشه که مرجریکوئستها تمام قسمتهای خواسته شده در تسک رو پوشش میدن و مرجریکوئست رو ریویو کنه.
میترا به مرجریکوئستهای مربوط به یک تسک و همچنین توضیحات اون تسک و ریلیزنوتهای قبلی دسترسی داره. پس میتونه ریلیزنوت تسک جدید رو با خودش با همون فرمت قبلی بنویسه و منتشر کنه.
میترا به کدبیس ما و اسکیمای دیتابیس دسترسی داره. پس میتونه کوئریهای SQL رو مطابق با نیاز همکارامون تولید کنه.
چیزایی که گفتیم در فاز اول، اون هم برای تیم فنی ما که در اون زمان هیچ تجربهای روی ساخت یه LLM Agent نداشته خیلی سنگ بزرگی بود. پس رفتیم سراغ سادهترین قسمتش یعنی Q&A Agent
بعدش حتی همین فاز اولیه رو هم سادهتر کردیم. اول باید مطمئن میشدیم که اصلا میترا --هر چقدر هم از نظر فنی جذاب و مطابق trend موجود در اون زمان باشه-- میتونه برای «میاره» آوردهی واقعی داشته باشه یا نه. کمی گشتیم و رفتیم سراغ Open WebUI. این ابزار بهمون کمک میکرد که خیلی سریع بتونیم یه Knowledge Agent بالا بیاریم. توی این trade-off قاعدتا توسعهپذیری آینده رو فدای time-to-delivery کردیم هر چی باشه این یه نسخهی Proof of Concept بود.
Open WebUI بهمون کمک کرد خیلی ساده فایلهای ریلیزنوت رو آپلود کنیم و بتونیم با وصل کردنش به API مربوط به OpenAI همین یک کاربرد پاسخ به سوالات محصول رو داشته باشیم. استقبال از میترا توی شرکت بینظیر بود.
ریلیزنوتها با N8N از روی Google Drive رصد میشدن و اگه تغییری توشون دیده میشد با تاخیر حداکثر ۱۰ دقیقهای مجدد سمت Open WebUI به روز میشد.
توی N8N یه ورکفلو تعریف کردیم که مستندات رو برای بار اول Full Load میکنه.
با پلاگین Mattermost Agents از Open WebUI یه OpenAI-compatible API گرفتیم و تونستیم کاری کنیم که همهی همکارا از طریق خود Mattermost با میترا صحبت کنن.
خود Open WebUI خیلی راحت روی کلاستر Kubernetes بالا اومد.
برای اکانت میترا توی Mattermost یه عکس پروفایل با کمک OpenAI ساختیم.
بعد از ریلیز آزمایشی از ۲ تا مورد مطمئن شدیم. حتما میترا رو میخوایم، Open WebUI پاسخگوی Multi Agent ما نیست.
مدل ریلیز در میاره Rolling Release هست. یعنی هر فیچر برای خودش جداگانه میره روی پروداکشن و در دسترس بودن یا نبودنش با استفاده از فیچرفلگ مدیریت میشه. برای هر ماه هم یک فایل در Google Drive ایجاد میشه که شامل مجموعهی ریلیزهای اون ماه هست. میترا نمیتونست تقدم و تاخیر ریلیزهای مختلف روی یک دامنهی مشترک رو ارزیابی کنه و درک درستی از زمانبندی نداشت. مثلا نمیدونست که یک فیچری اول نیازمند اکشن دستی بوده و بعدا خودکار شده. یا این که مثلا ماه آبان شامل چه مجموعه ریلیزهایی میشه. برای همین رفتیم سراغ LangChain/LangGraph.
گشتیم دنبال کتابخونه یا چهارچوبی که به استک فعلی بکند میاره نزدیک باشه و ابزارهای جانبی و تکمیلی مختلفی براش وجود داشته باشه که بتونیم ازش استفاده کنیم. پلاگین اخیر PyCharm به نام AI Agents Debugger بهمون این سر نخ رو داد که احتمالا از بین ابزارهای موجود LangGraph میتونه گزینهی مناسبی برای ما باشه. در هر صورت قرار بود معماری رو با کمک Coding Agentها شکل بدیم و نهایی کنیم. مرحلهی پیادهسازی هم به خود Agentها سپرده بشه.
در نهایت LangGraph رو انتخاب کردیم و معماری زیر رو پیادهسازی کردیم:
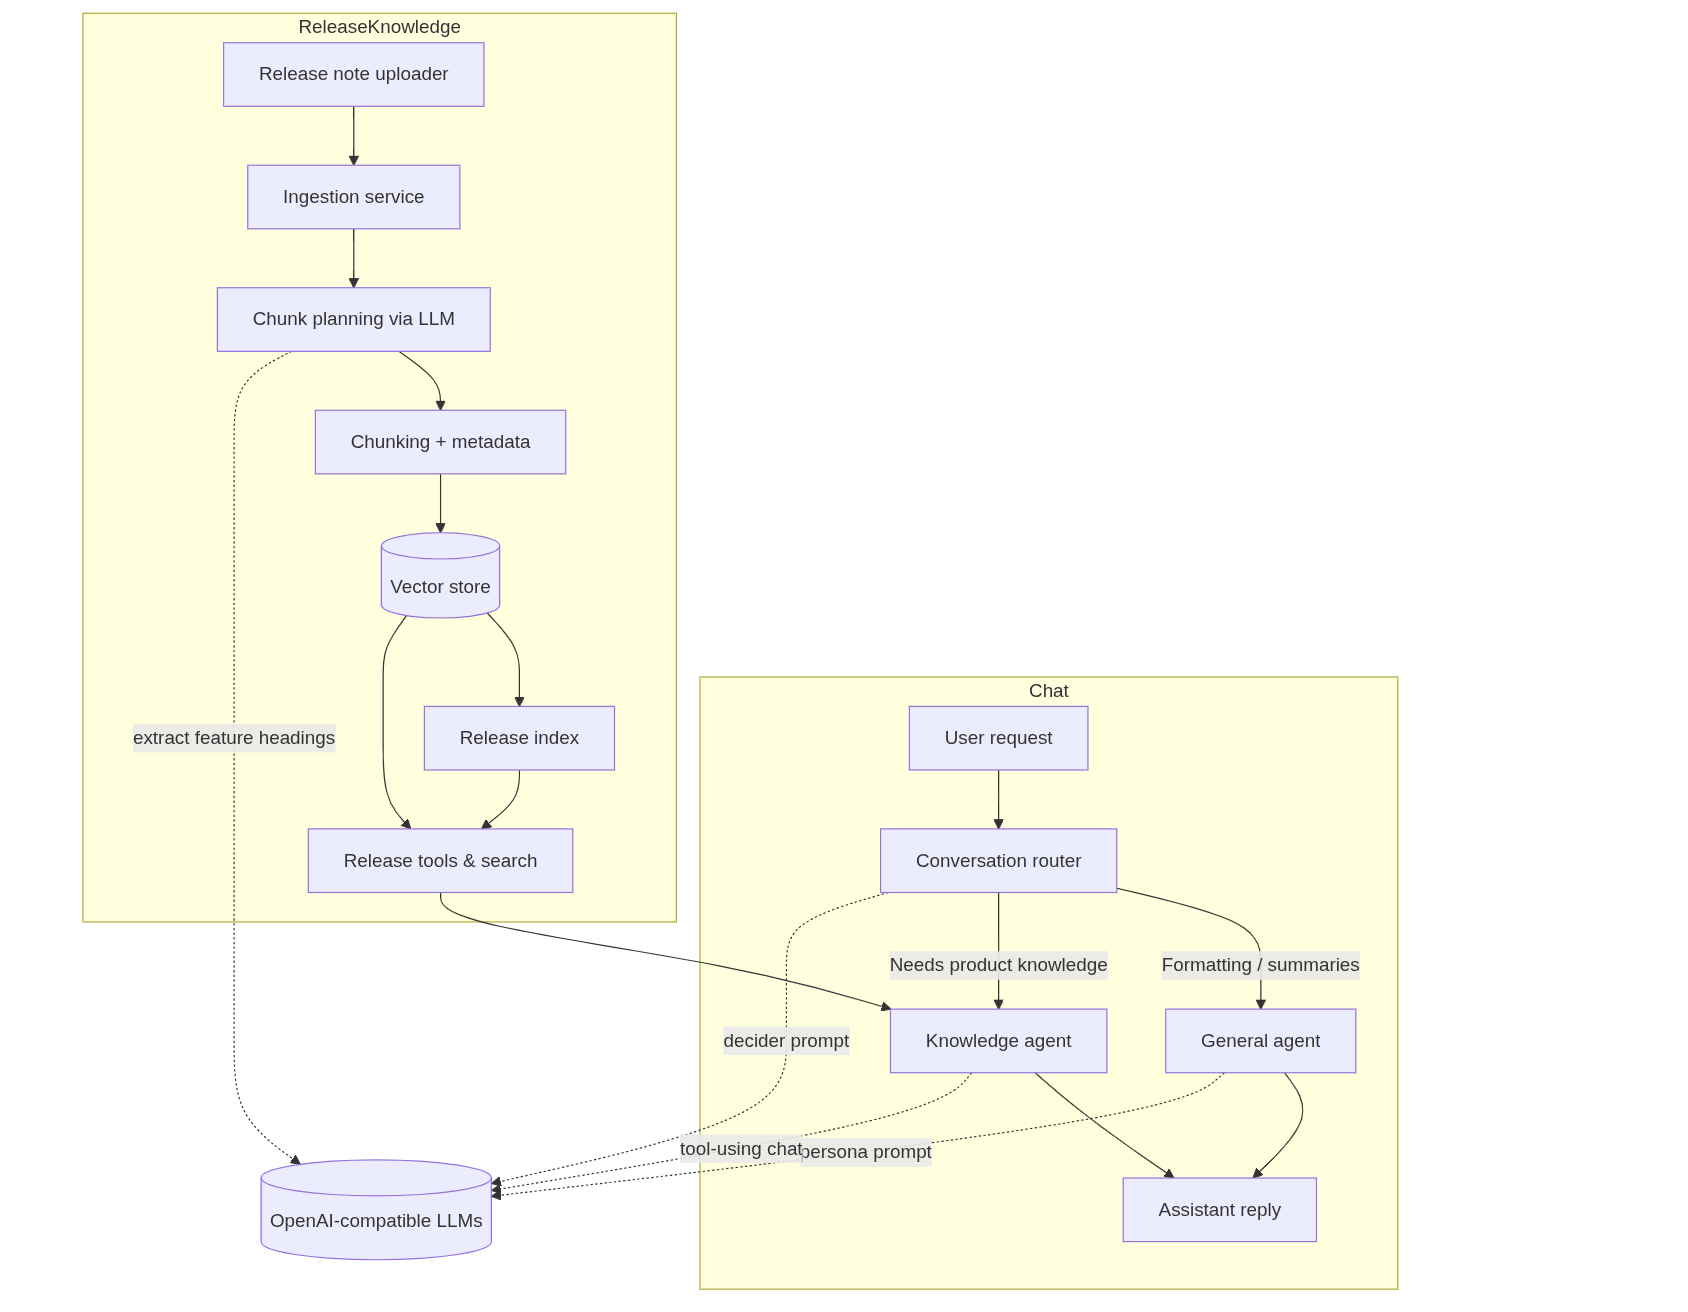
نود router لیستی از Agentها رو میگیره و بر اساس توضیحاتی که هر Agent داره اول تصمیم میگیره که درخواست کاربر باید به کدوم Agent پاس داده بشه. اگر درخواست کاربر به هیچ کدوم از Agentهای تعریف شده مرتبط نشه، به کاربر این مورد رو میگه.
مشابه قبل N8N مسئولیت به روزرسانی ریلیزنوتها رو سمت میترا داره. برای این که دستمون برای توسعهپذیری آتی باز باشه نیاز بود در کنار اندپوینتهای OpenAI-compatible اندپوینتهایی دیگهای مثل به روزکردن Knowledge داشته باشیم. برای همین از FastAPI برای این لایه استفاده کردیم و قابلیت SSE رو هم پوشش دادیم.
نتیجه چی شد؟
چانک کردن مستندات بر اساس هر فیچر با استفاده از خود LLM انجام میشه
میترا میتونه همهی ریلیزهای مربوط به زمانهای خاصی (مثلا آبان) رو داشته باشه و از بینشون مهمترینهاش رو انتخاب کنه
بدونه هر تغییر در چه تایملاینی اجرا شده و تایملاین تغییرات رو گزارش بده.
در سوالات رفت و برگشتی حافظهی مکالمه رو از دست نده و موضوع مکالمه رو برای جواب دادن در نظر بگیره.
برای use-caseهای آتی توسعهپذیری مناسبی داشته باشه.
فعلاً همینجا پروندهی نسخهی اولیهی میترا رو میبندیم. میترا قرار نیست به همین نسخه خلاصه بشه.
انتظار داریم با ابزارها و کانکتورهایی که براش میسازیم، کمکم تبدیل بشه به یه دستیار همهکاره برای تیمهای میاره؛ چیزی که هر تیمی بتونه بهش تکیه کنه و کارش سریعتر جلو بره. قسمتهای مختلفی که در پستهای آینده میبینیم همگی قرار هست برن توی دل میترا.
در پستهای بعدی سراغ بقیهی ابزارهایی میریم که از AI (به طور خاص مدلهای زبانی بزرگ) توی میاره داریم. توضیح خواهیم داد که این ابزارها قراره چه مسئلهای رو حل کنن و ما چجوری تونستیم هزینهی استفاده از LLMها رو با توجه به طرحهای فعلی مدیریت و بهینه کنیم.


