
بــه نـامــ خـدا
یادگیری تحت نظارت یا یادگیری نظارتی(Supervied Learning) الگوریتمی است که از دادههای آموزشی برچسبگذاری شده یاد میگیرد تا به شما در پیشبینی نتایج برای دادههای پیشبینی نشده کمک کند. در یادگیری تحت نظارت، ماشین را با استفاده از دادههایی که به درستی برچسبگذاری شده اند، آموزش میدهید. این به این معنی است که برخی از داده ها قبلاً با پاسخ های صحیح برچسب گذاری شده اند. می توان آن را با یادگیری در حضور سرپرست یا معلم مقایسه کرد.
ساخت، مقیاسبندی، و استقرار مدلهای ماشین لرنینگ با نظارت دقیق، به زمان و تخصص فنی تیمی از دانشمندان داده ماهر نیاز دارد.
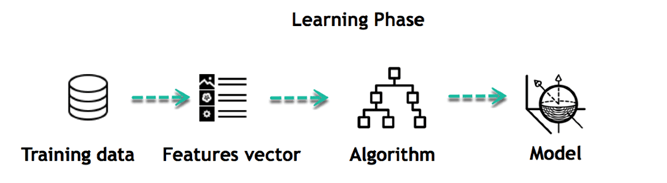
در الگوریتم های یادگیری تحت نظارت، از داده های برچسب گذاری شده برای آموزش سیستم استفاده میشود؛
برای مثال اگر برنامه ی شما برای تشخیص رنگ سفید از بقیه ی رنگ ها نوشته شده، دیتاست دارای رنگ های قرمز، آبی،مشکی،نارنجی و... است. که رنگ ها با لیبل های 0 و 1 برچسب گذاری شده اند(رنگ سفید ۱ و بقیه رنگ ها ۰)
در این حالت سیستم برای خود تابعی میسازد(مدل سازی) و میتواند رنگ سفید را از بقیه رنگ ها تشخیص دهد.
در یادگیری تحت نظارت(Supervised Learning) برای آموزش سیستم از داده ی آموزشی استفاده میشود، و برای تست سیستم از داده ی تست استفاده میشود
رگرسیون(Regression)
تکنیک رگرسیون یک مقدار خروجی واحد را با استفاده از داده های آموزشی پیش بینی می کند.
از روش رگرسیون لجستیک برای تخمین مقادیر گسسته بر اساس مجموعه ای از متغیرهای مستقل استفاده می شود. همانطور که احتمال را پیش بینی می کند، مقدار خروجی آن بین 0 و 1 قرار دارد.
طبقه بندی(Classification)
طبقه بندی به معنای گروه بندی خروجی در یک کلاس است. اگر الگوریتم سعی کند ورودی را به دو کلاس مجزا برچسب گذاری کند، طبقه بندی باینری نامیده می شود. انتخاب بین بیش از دو کلاس طبقه بندی چند کلاسه نامیده می شود.
مدل بیزی ساده(Naive Bayesian Model)
مدل ساده بیزی برای مجموعه داده های بزرگ استفاده میشود. این روش از نمودارهای غیر چرخه ای مستقیم با یک والدین و چند فرزند تشکیل شده است.
مدل جنگل تصادفی(Random Forest Model)
مدل جنگل تصادفی یک روش مجموعه ای است. با ساختن تعداد زیادی درخت تصمیم عمل میکند و طبقهبندی درختان منفرد را خروجی میدهد.
شبکه عصبی(Neural Networks)
می توان شبکه عصبی مصنوعی را یک مدل محاسباتی در نظر گرفت. که عملکرد آن، الهام گرفته از شبکه های عصبی بیولوژیکی موجود در مغز انسان است. که وظیفه پردازش اطلاعات را بر عهده دارند.
تعریف دکتر هچ نیلسن(Robert Hecht-Nielsen) درباره ی شبکه های عصبی:
یک سیستم محاسباتی که از تعدادی المان های پردازشی ساده و بهم متصل ساخته شده است که به وسیله پاسخ وضعیت دینامیکی به ورودی های خارجی، اطلاعات را پردازش می کند.
ماشین های بردار پشتیبانی(Support Vector Machines) یا SVM
الگوریتم یادگیری نظارت شده svm در بین مدل های یادگیری نظارت شده بسیار محبوب است زیرا می توان از آن برای طبقه بندی یا رگرسیون استفاده کرد. پیادهسازی مدل با فضاهای با ابعاد بالا به خوبی کار میکند، اما میتوان آن را به طور موثر با مجموعه دادههای کوچک نیز استفاده کرد.svm همچنین می تواند مشاهدات جدید را زمانی که الگوریتم بر روی یک مجموعه داده آموزش داده می شود، به طور موثر طبقه بندی کند.
در این مثال از الگوریتم رگرسیون(از نوع خطی) و کتابخانه ی scikit-learn استفاده می شود.
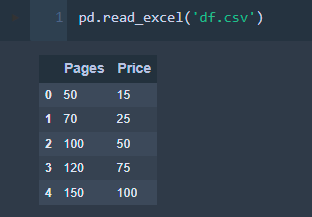
import numpy as np import pandas as pd import matplotlib.pyplot as plt from sklearn.linear_model import LinearRegression df = pd.read_excel('df.csv') x = np.array(df['Pages']).reshape(-1,1) y = np.array(df['Price']).reshape(-1,1) model = LinearRegression() model.fit(x,y) plt.scatter(x,y, c = 'blue') plt.plot(x,model.predict(x), c = 'red') plt.title('Simple Linear Regression') plt.xlabel('Pages') plt.ylabel('Price') plt.grid()
خروجی:
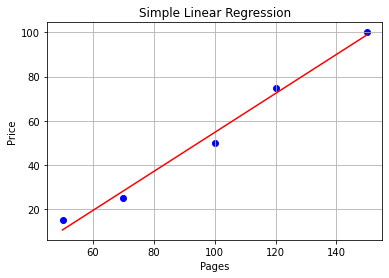
در این عکس نقطه های آبی داده های آموزشی هستند و خط قرمز مدل رگرسیون است.
پس از اینکه آموزش به ماشین به اتمام رسید، نوبت به امتحان گرفتن و تست سیستم است. در این مرحله دانشمندان داده دیتاستی تهیه می کنند که لیبل داده های آن مشخص است. اما تنها داده ها را بدون لیبل هایشان وارد سیستم می کنند تا بفهمند که سیستم تا چه حد قادر به ارائه خروجی صحیح است.
در این مرحله با دادن ورودی(متغیر مستقل(x)) باید متغیر وابسته(y) را دریافت کنیم.
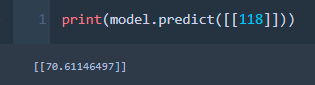
حالا میتونید به جای 118(متغیر مستقل) عدد دیگه ای هم وارد کنید.
در زیر چند تا از مزایای یادگیری نظارتی آمده است


