
در این قسمت به بررسی انواع مختلف data encoding و data flow ها می پردازیم. مهم ترین ویژگی هر نرم افزار میزان انعطاف آن در برابر تغییر است. این میزان انعطاف به «هزینه تغییر» یا همان «cost of change» وابستگی زیادی دارد. هر چقدر که هزینه زمانی و مالی تغییرات نرم افزار بیشتر باشد، هزینه تغییر را زیاد می کند و در نتیجه انعطاف پذیری نرم افزار در برابر تغییر کم می شود.
اگر بخواهیم متوجه شویم که چرا data encoding می تواند تاثیر زیادی در رابطه با software evolution داشته باشد ابتدا باید در مورد «نمایش داده» یا data representation های متفاوتی که وجود دارد صحبت کنیم. معمولا هر برنامه کامپیوتر با دو نمایش متفاوت از داده ها سر و کار دارد:
برنامه های کامپیوتری معمولا داده های موجود در حافظه برنامه را بصورت encode شده در فایل یا دیتابیس ذخیره می کنند. سپس، هر گاه به آن داده نیاز داشته باشند، داده مورد نظر را از فایل خوانده، آن را «کدگشایی» (decode) می کنند و به حالت نمایش اول (نمایش در حافظه) درون برنامه نگه می دارند و از آن استفاده می کنند.
موضوع رایج و چالش برانگیزی که وجود دارد این است که، در اکثر مواقع داده های encode شده توسط یک برنامه، توسط برنامه یا برنامه های دیگری decode می شود. به همین دلیل بسیار مهم است که فرمت encode کردن داده استاندارد باشد. به عنوان مثال، اگر شما به استفاده از encoder مخصوص زبان Go که همان gob هست، داده ها را کدگذاری کنید و این داده را به برنامه کلاینت که مثلا با زبان javascript نوشته شده است بدهید، برنامه کلاینت نمی تواند داده را decode کند (مگر اینکه پیاده سازی gob برای js انجام شود). بنابراین مرسوم است که برای encode کردن داده ها از فرمت های استاندارد مثل json استفاده می شود. زیرا encode/decode کردن فرمت json تقریبا برای همه زبان ها رایج و امکانپذیر است.
می رسیم به بخش جذاب و مهم داستان، جایی که می خواهیم بگوییم چرا نحوه کدگذاری کردن داده ها، ارتباط زیادی با میزان انعطاف پذیری نرم افزار دارد. وقتی که دو نرم افزار جدا از هم، قرار است داده ای را بصورت کدگذاری شده با یکدیگر به اشتراک بگذارند، لازم است که اولا:
برای حفظ سازگاری داده ها و امکانپذیر شدن تغییر در شمای داده (data schema) باید به backward compatibility و forward compatiblity توجه کنیم.
بحث backward compatibility یعنی اینکه تغییر فرمت کدگذاری داده بگونه ای باشد، که برنامه شما هم بتواند داده های کدگذاری شده با فرمت قدیم را بخواند و هم داده های کدگذاری شده با فرمت جدید را بخواند.
و اگر بخواهیم forward compatiblity را رعایت کنیم، باید تغییرات schema بگونه ای باشد که اگر برنامه دوم هنوز نتوانسته است خود را با شمای جدید وفق دهد، همچنان بتواند داده کدگذاری شده با فرمت جدید را بخواند. (این می تواند اینگونه اتفاق بیفتد که در تغییرات شما، فیلدهایی که در شمای قدیمی اجباری (required) هستند را حذف نکنید. زیرا اینگونه برنامه کلاینتی که هنوز به فرمت جدید بروزرسانی نشده است، نمی تواند داده های جدید که دیگر آن فیلد اجباری را ندارند، کدگشایی (decode) کند.
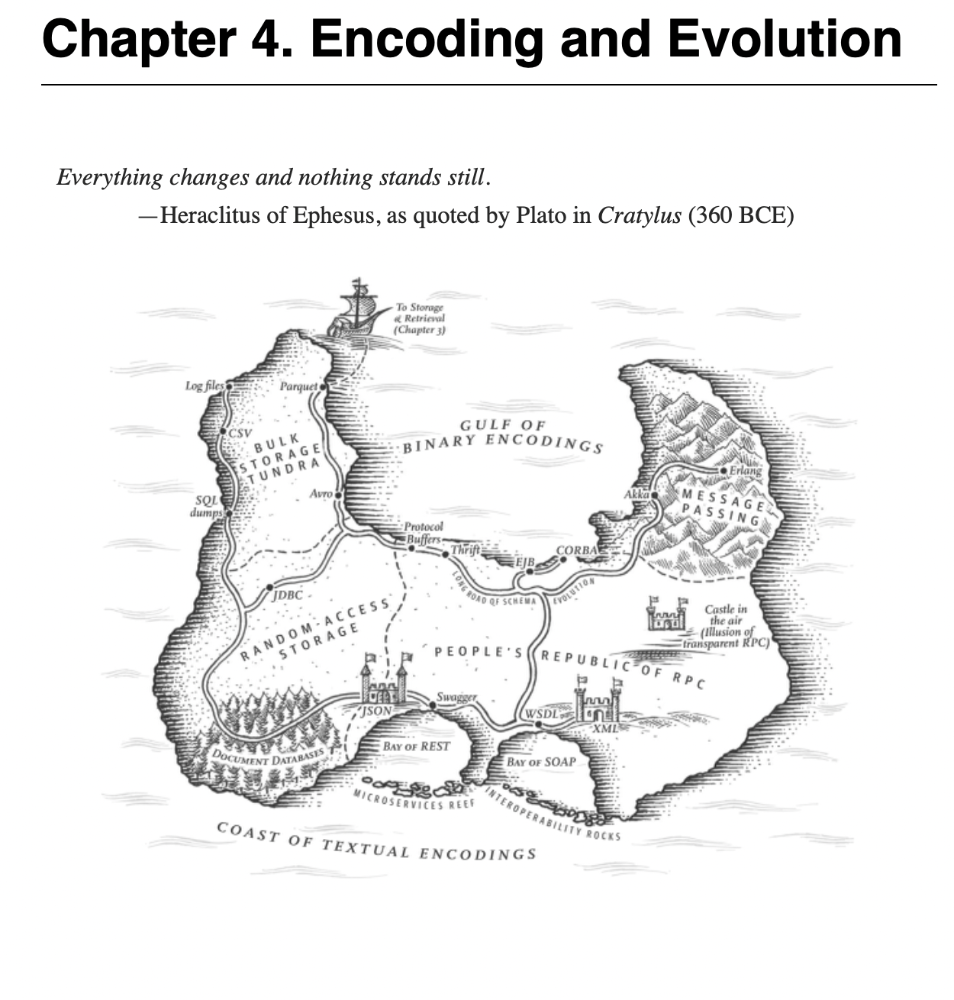
کتاب Designing Data Intensive Applications به صورت مفصل در فصل چهارم خود درباره انواع مختلف کدگذاری داده ها مثل JSON و PROTOBUF و THRIFT و غیره صحبت می کند و پس از آن در مورد انواع جریان داده صحبت می کند و اینکه در چه جریان داده ای، استفاده از چه نوع فرمت کدگذاری، مرسوم است.
پیشنهاد می کنم حتما فصل چهارم از این کتاب را مطالعه کنید، و یا حداقل، ویدیوی ضبط شده در GoCasts در این رابطه را در یوتیوب مشاهده کنید.


