
رقابتهای هوش مصنوعی المپیک فناوری محل گردهمایی برترین استعدادهای این حوزه است. مشارکتکنندگان در این رقابتها دانش، مهارت، خلاقیت و سطح تخصص خود را در یک سری رویدادهای چالشبرانگیز و هیجانانگیز به نمایش میگذارند و با دیگر نفرات به رقابت میپردازند. مخاطبین این رویداد همهی کسانی که در شروع مسیر جذاب هوش مصنوعی هستند، دانشجویان کارشناسی رشتههای کامپیوتر، برق، مکانیک، صنایع، ریاضی و عموم افراد علاقهمند به مباحث هوش مصنوعی و علم داده میباشند.
مراحل
۱. ثبتنام: بتنام در رقابتها با تیمهای ۲ نفره است. اگر فردی را برای تشکیل تیم نمیشناسید، میتوانید در گروه تلگرامی «تیمسازی المپیک فناوری: برنامهنویسی» خودتان را معرفیکنید و همتیمی مناسبتان را پیدا کنید.
◀ عضویت در گروه «تیمسازی المپیک فناوری: هوش مصنوعی»:
https://t.me/+GKkcUxhH9qAyOTBk
۲. رقابت انتخابی: مسابقه آنلاین با هدف شناسایی تیمهای برگزیده برای رقابت نهایی
۳. رقابت نهایی: تیمهایی که با موفقیت رقابت مقدماتی را پشت سر گذاشتهاند، به مسابقه نهایی که بهصورت حضوری در پارک فناوری پردیس برگزار میشود، دعوت میشوند. رقابت فینال با دعوت از حدود ۲۰۰ نفر از برگزیدگان مرحله مقدماتی برگزار میشود و نهایتا، تیمهای برتر در هر مسیر جوایز نقدی، مدال، تندیس و تقدیرنامه دریافت مینمایند.
◀️ برای شرکت در رقابت دلخواه خود، به صفحه ثبتنام مورد نظر بروید و ثبتنام خود را تکمیل کنید.
⚠ این رقابتها در ۳ مسیر جداگانه برگزار میشود و شما میتوانید فقط در یکی از این مسیرها (پردازش تصویر، پردازش داده یا پردازش متن) شرکتکنید.
https://quera.org/events/techolympics-ai-0307
میتوانید از دانش خود در زمینههای هوش مصنوعی، پایتون، و ابزارهایی مانند TensorFlow یا PyTorch برای حل مسائل هوش مصنوعی استفاده کنید.
اگر قصد دارید مسیر پردازش متن یا داده را انتخاب کنید، آشنایی بیشتر با الگوریتمهای یادگیری ماشین و کتابخانههای مرتبط به شما کمک خواهد کرد.
مسیرهای مختلف رقابتها دارای چالشهای متفاوتی هستند. به صورت کلی، پردازش داده و پردازش متن نسبت به پردازش تصویر ممکن است سادهتر باشند، بهویژه اگر تجربهای در زمینه یادگیری ماشین و کار با دادههای متنی و عددی داشته باشید.
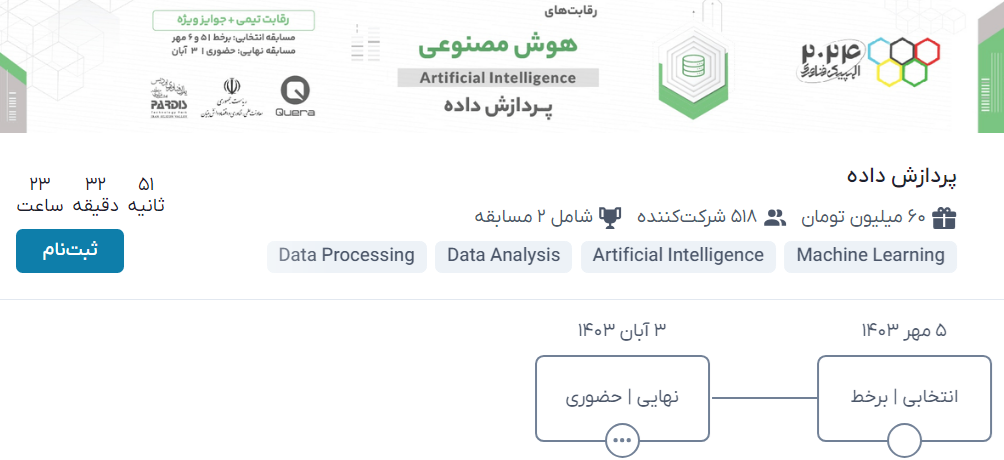
1. پردازش داده (Data Processing):سادهتر برای شروع: اگر با مفاهیم بیگ دیتا و تحلیل دادهها آشنا هستید، این مسیر ممکن است برایتان راحتتر باشد.
الگوریتمهای مورد نیاز:
Pandas, NumPy, Scikit-learn, Matplotlib برای تحلیل داده و مصورسازیSpark برای پردازش دادههای حجیم2. پردازش متن (NLP - Natural Language Processing):چالشهای خاص: پردازش زبان طبیعی نیاز به درک عمیقتر از مدلهای زبان و کار با دادههای متنی دارد.
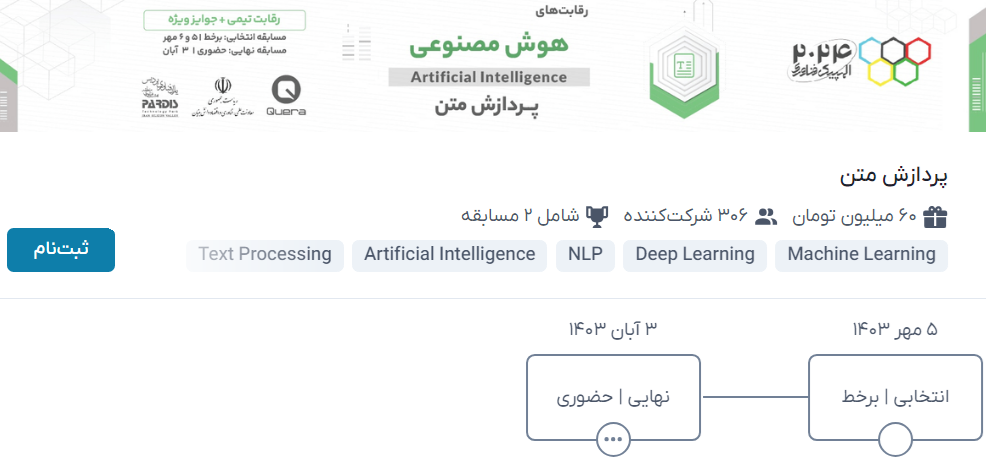
الگوریتمهای مورد نیاز:
کتابخانههای مرتبط:
NLTK, spaCy, Transformers (from Hugging Face)زمان یادگیری: حدود ۳ تا ۴ ماه تمرین، مخصوصاً اگر بخواهید مدلهای پیچیدهتر مانند ترانسفورمرها را درک کنید.
3. پردازش تصویر (Image Processing):چالشهای پیچیدهتر: به دلیل کار با شبکههای عصبی عمیق (Deep Learning) و پردازشهای پیچیده تصویر.
الگوریتمهای مورد نیاز:
OpenCV, TensorFlow, Keras, PyTorch

