
در جریان رویداد Google I/O 2021، توسعه دهندگان و علاقه مندان از سراسر جهان گرد هم آمدند تا جدیدترین مطالب و امکاناتِ موتورِ جستجوی گوگل را از طریق کارگاه ها، ارایه های آنلاین و جلسات AMA بدست آورده و آنها را به اشتراک بگذارند.
جلسه ی معرفی ویژگی های جدید Google Search توسط جان مولر - john mueller - تحلیل گر و عضو تیم ارتباط و پشتیبانی گوگل، در تاریخ: Wednesday, May 19, 2021 - چهارشنبه، ۲۹ اردیبهشت ۱۴۰۰ برگزار شد، که توجه شما را به تماشای پادکست و مطالعه این مقاله جلب می نمایم.
سخن نویسنده : از آنجاییکه سخنان آقای مولر بصورت کاملا فنی و برای توسعه دهندگان ارایه شده است و همچنین ایشان با روشی منحصر بفرد، به بحث می پردازند، تلاش کرده ایم تا ضمن حفظ داده های موجود در جلسه فوق، اصطلاحات، ویژگی های جدید و مبانی که به آن اشاره شده است را با نگارشی روان تر تشریح نماییم.
فهرست محتوا - Table of Content
مقدمه - جان مولر
یکی از وظایف ما، برقراری ارتباط میان مالکین وب سایت ها ( از جمله وب مسترها، توسعه دهندگان، تحلیل گران، بازاریابان و همینطور شما ) با افرادی است که بر روی گوگل کار می کنند و با در اختیار قرار دادن اطلاعات لازم به همه، کمک می کنیم تا بتوانند در نتایج جستجو موفق باشند. در این جلسه بر روی مباحث فنی سئو، بروزرسانی های اخیر گوگل، ابزارهای عیب یابی و کنترل جستجو و داده های ساختار یافته صحبت خواهیم کرد.
بهینه سازی برای موتور جستجو یا به اختصار سئو ( SEO )، آن جادوی سیاهی نیست که بخواهید نگران اش باشید، اما دارای جنبه های مهمی می باشد که می خواهیم با دید فنی به آن بپردازیم. می توانیم صرفا از جانب گوگل با هم صحبت کنیم منتهی، در بیشتر مواقع، این بهینه سازی در سایر موتورهای جستجو، با چالش های مشابهی همراه است.
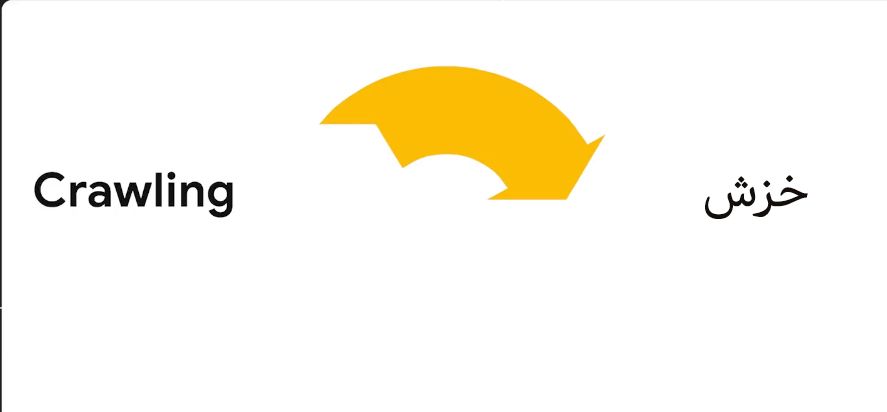
هر زمان که می خواهید داده های یک صفحه را بررسی و تجزیه تحلیل نمایید، این همان کاری است که موتور جستجو انجام می دهد و بخش عمده ای از تکنیک های فنی سئو، به آن این امکان را می دهد تا بتواند صفحات Html را بخواند و محتوای آن را درک کند. برای این منظور، ابتدا باید بتوانیم آدرس ها را بیابیم و از وجود آنها مطلع شویم، که مانند روش های cURL و wGET، برای پردازش صفحه، به آن خزش - Crawling می گویم.
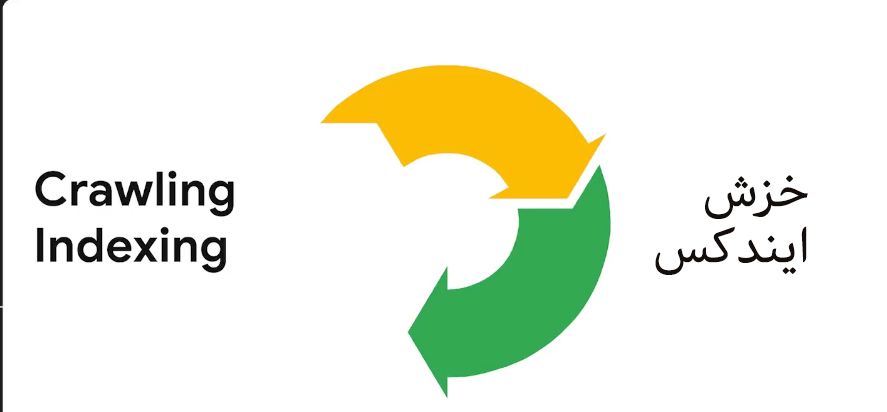
پس از این مرحله، صفحه را مانند آنچه که در مرورگر اتفاق می افتد، بدنبال هر جاوا اسکریپتی گشته و نتیجه را تجزیه می کنیم، که به آن نمایه سازی می گویند. استخراج عناوین و سایر متون از DOM - درختواره اشیاء صفحه، ساده است و مانند توکن ذخیره می گردد تا برای ایندکس آدرس های شما استفاده شود. حال این سوال پیش می آید که موتور جستجو چطور این فرآیندها را تفسیر می کند و می فهمد؟
برای این موضوع، ما عناصر قابل خواندن توسط ماشین - Machine-readable Elements متنوعی را بررسی می کنیم و بر مبنی آن تصمیم می گیریم که چه اطلاعاتی را ایندکس و یا صرف نظر نماییم. اما داستان فراتر از این حرف هاست و این همه ماجرا نیست. آیا صفحه ای که قصد داریم ایدکس کنیم یک رویداد خانوادگی است یا دستور پخت پای سیب که اتفاقا 45 دقیقه زمان می برد؟ اینجاست که با دنیای داده های ساختاریافته روبرو و آشنا می شویم، اما عجله نکنید، کمی جلوتر در باره اش صحبت خواهیم کرد.
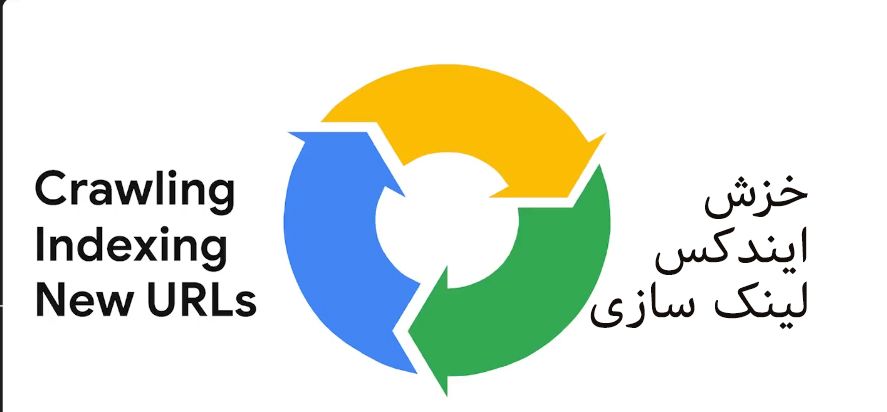
همزمان با پردازش و بررسی یک صفحه، ما بدنبال لینک هایی می گردیم که به سایر صفحات، هم در داخل و هم به خارج از سایت پیوند خورده باشند. در هر صورت لینک ها باید با عناصر HTML استاندارد - Well-formed تولید و مشخص گردند، تا با در دسترس و مستدل بودن، بهتر بتوانیم آنها را بفهمیم. برای تکمیل پروسه، ما به لینک هایی که به صفحه مورد نظر رسیده اند هم می نگریم و برای خزش های بعدی در نظر میگیریم. اطلاعاتی از این قبیل که برای نتایج جستجو استفاده می شود را می توانیم بخشی از سئوی تکنیکال بدانیم.
در دسترس و قابل مشاهده بودن یک وبسایت در نتایج بسیار مهم است و باید حتما با یک کارشناسی سئو در ارتباط بوده و از تجربیات و نکات او بهره ببرید.
یکی از تغیرات اخیر گوگل در واکشیِ داده ها از صفحات، حرکت بسوی معماری HTTP/2 بوده و جزو تغییرات عمده در HTTP ( پروتکل انتقال داده های در اینترنت ) می باشد. در این حالت می توان یک سیگنال TCP را ارسال و بصورت همزمان چندین فایل را دریافت کرد که باعث می شود خزش کارآمدتری داشته، گوگل بات و خزنده ها هم دیگر نیازی ندارند تا وقت زیادی را برای خزش ( در اصطلاحات سئو به آن بودجه خزش می گوییم ) هدر دهند.
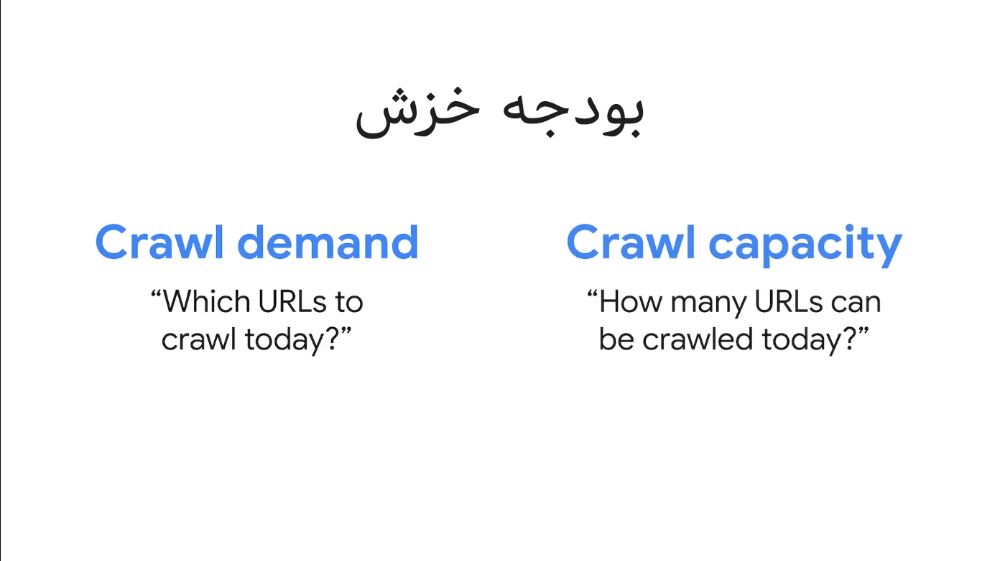
بودجه خزش شامل 2 معیار اساسی می باشد:
1. مشخص کردن خزش - crawl demand: میزان آدرس هایی است که گوگل می خواهد در سایت بخزد.
2. ظرفیت خزش - crawl capacity: کشش سرور شما برای خزش بدون مشکل آدرس ها چقدر است.
حال فکرش را بکنید که با فناوری HTTP/2، سیستم های ما می توانند با همان مقدار بارگیری و بارگزاری بر روی سرور، درخواست های بیشتری داشته و از این فناوری بهره ببرند. ( بستگی به پشتیبانی سرور های شما دارد ). لازم به ذکر است، سرویس های ما می توانند در این خصوص که آیا کیفیت سرور شما در حدی هست تا بتواند باعث افزایش کارایی خزش گردد یا خیر، تصمیم بگیرند. اینجاست که اهمیت فعال بودن HTTPS نیز بیش از پیش پررنگ می شود.
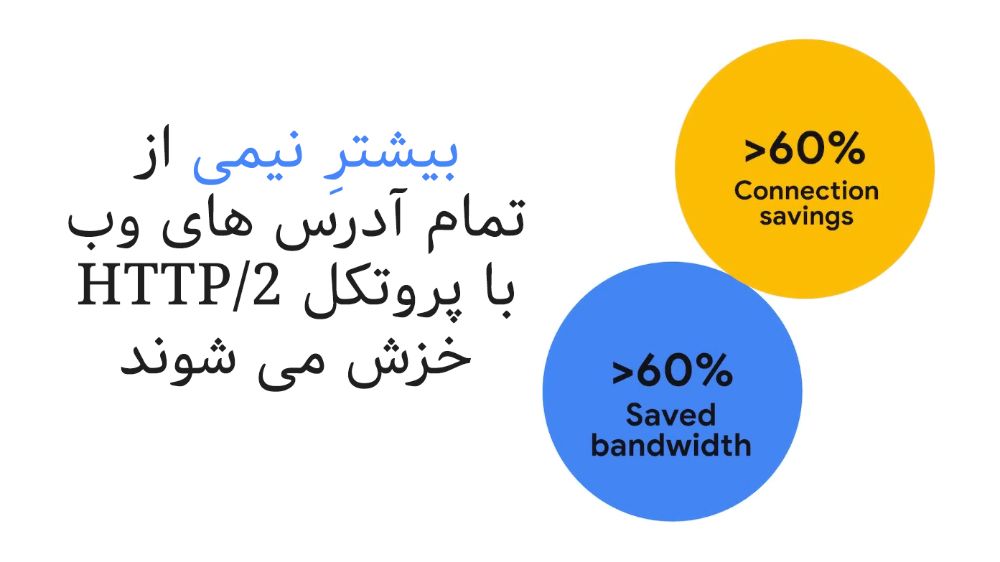
در حال حاضر بیش از یک/دوم آدرس ها بر بستر HTTP/2 خزش می شود که با استفاده از مولتی پلکسینگ و هدر کامپرشن، تعداد اتصالات و پهنای باند مصرفی، به طرز چشم گیری کاهش پیدا کرده است. این پیشرفت ها هم به خزنده های ما کمک می کند، هم به زیر ساخت های سرویس دهنده وب سایت شما. Multiplexing مجموعه تکنیک هایی است که امکان انتقال همزمان چندین سیگنال از طریق یک پیوند داده را فراهم می کند.
بیشترِ نیمی از تمام آدرس های وب با پروتکل خزش می شوند. این فرایند باعث می شود، تعداد اتصالات و پهنای باند مصرفی، به طرز چشم گیری کاهش پیدا کند.
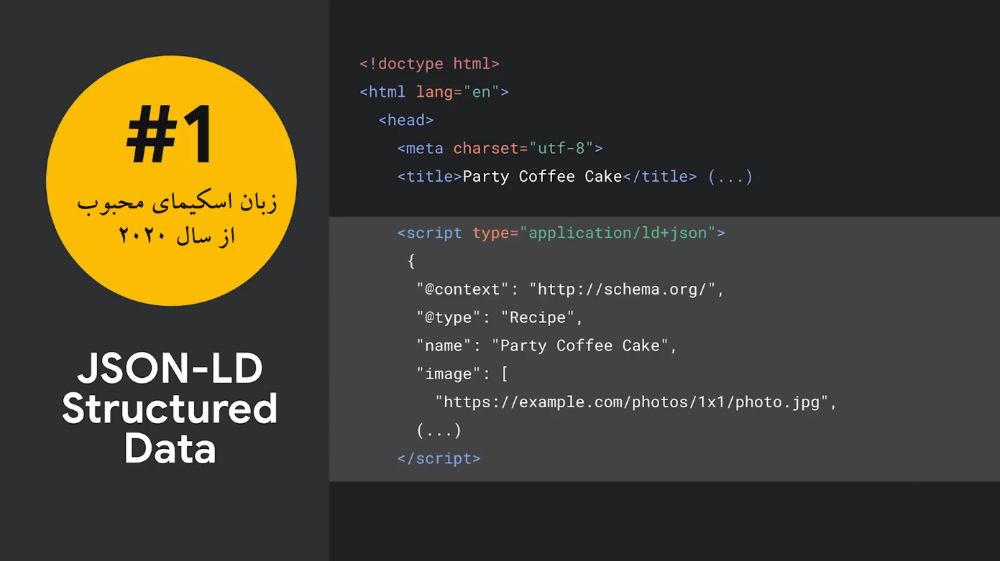
وقتی صحبت از اطلاعات قابل خواندن توسط ماشین - Machine-readable data در یک صفحه می شود ، گوگل در درجه اول متکی بر داده های ساختار یافته ای است که در HTML، جاسازی شده اند. طی یک سال گذشته، جی سان - JSON LD، به عنوان یکی از محبوب ترین زبان هایی بوده که برای ارایه داده های ساختار یافته توسط وب سایت ها استفاده شده است. تمام meta-data های گوگل از طریق جی سان و کتابخانه Schema.org قابل ارایه می باشند.
کتابخانه اسکیما، یک منبع داده ی متن باز و پذیرفته شده با استاندارد جهانی است که به بیان اطلاعات منتهی به نتایج غنی می پردازد. چیزی که از 10 سال پیش شروع شد و هم اکنون جز زیرساخت های بسیار مهم وب بوده و بستر پایداری را برای وب سایت هایی فراهم می کند که می خواهند تا مدت ها حضور داشته باشند. Schema.org دائما در حال توسعه با تکنولوژی و ویژگی های جدید است.
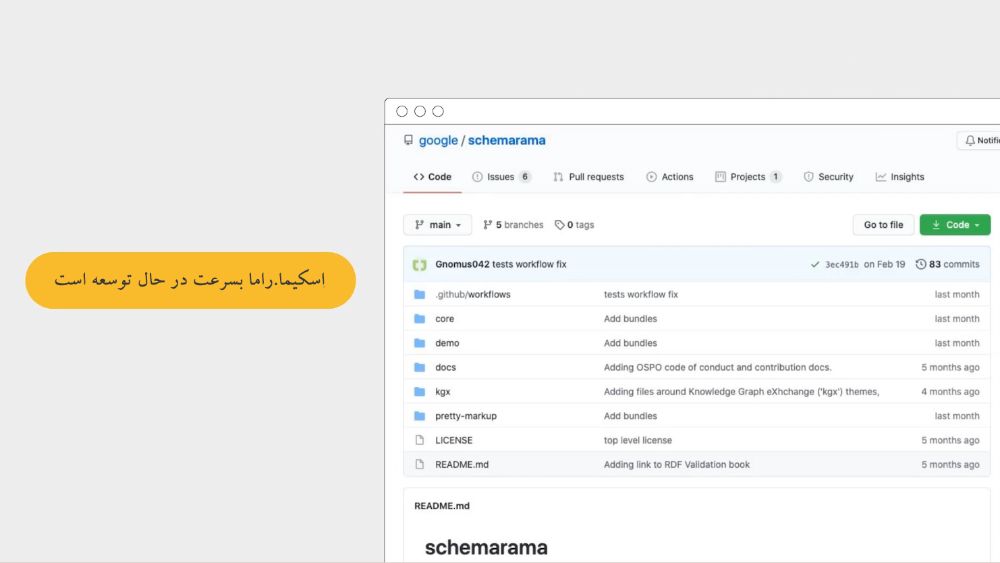
این مجموعه گسترده، با توسعه دهندگان به شکل ویژه ای اشتراک گذاشته شده است تا به آنها در استفاده مناسب از داده ها کمک کند. به عنوان مثال گوگل در حال حاضر، ابزار اسکیما راما - Schema rama را بصورت متن باز ارایه کرده است. اسکیما راما، ابزار تجزیه و تحلیل داده های ساختار یافته و اعتبار سنجی، آنهم بصورت خودکار است.
اگر کنجکاو هستید تا بدانید، داده های ساختار یافته با نتایج جستجو چه می کنند، باید در مورد آن بسیار هوشمندانه مطالعه کنید و صرفا بر مبنی نیازی که هر صفحه یا سایت می تواند داشته باشد، آنها را به کار نگیرید.
می توانید دستور پخت یک کیک خوشمزه، یا رویدادهای آنلاین/ آفلاین و همینطور برنامه هایی که پیش رو دارید را در قالب اسکیما دراورید اما باید بدانید استفاده از داده های اضافه طرحواره ها، ربطی به افزایش رتبه بندی شما در نتایج جستجو ندارد، منتهی صفحه را برای کاربرانی که بدنبال چیزی می گردند، بهتر نمایش می دهد.
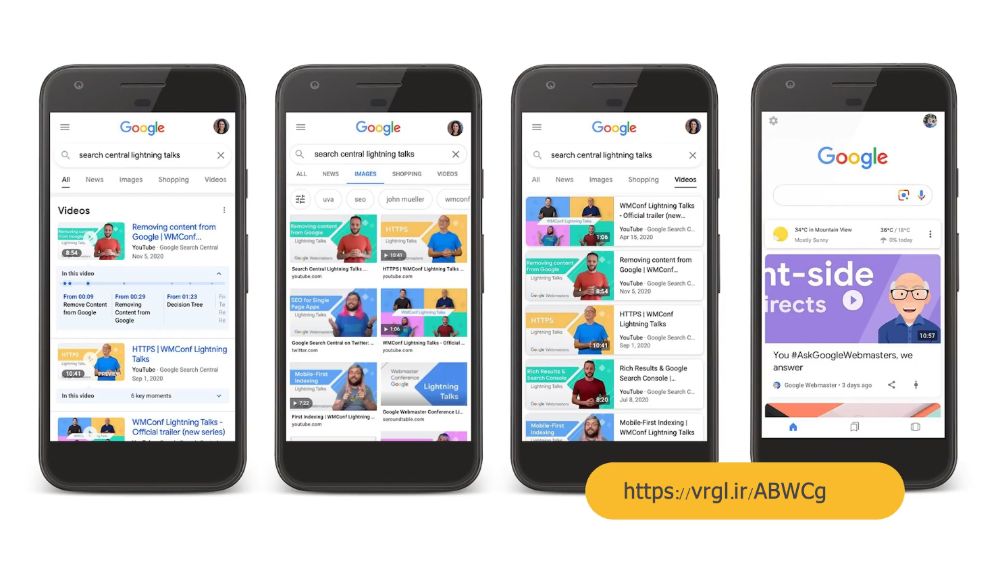
ما همچنین از داده های ساختار یافته، برای نمایش ویدئو ها استفاده می کنیم. یکی از مسایلی که طی سال های گذشته ارتقا داده ایم این است که چطور یک ویدئو را شناسایی و نمایش دهیم. بطور خاص داده های ساختار یافته زیادی هستند که پشتیبانی می شوند، اما قرار دادن ویژگی های ویدئویی که برای وب سایت شما هم مهم است، می تواند بسیار جالب باشد.
ویدئو ها و لندینگ پیج های مالتی مدیا، می توانند در نتایج جستجو به شکل برجسته ای نمایش و توسط کاربران مشاهده شوند که این یک محیط تعاملی بسیار ثمر بخش است. شما می توانید کلیپ های خود را بر روی سایت یا سایر پلتفرم های میزبانی قرار دهید که هردو به راحتی توسط گوگل شناسایی و پشتیبانی می شوند.
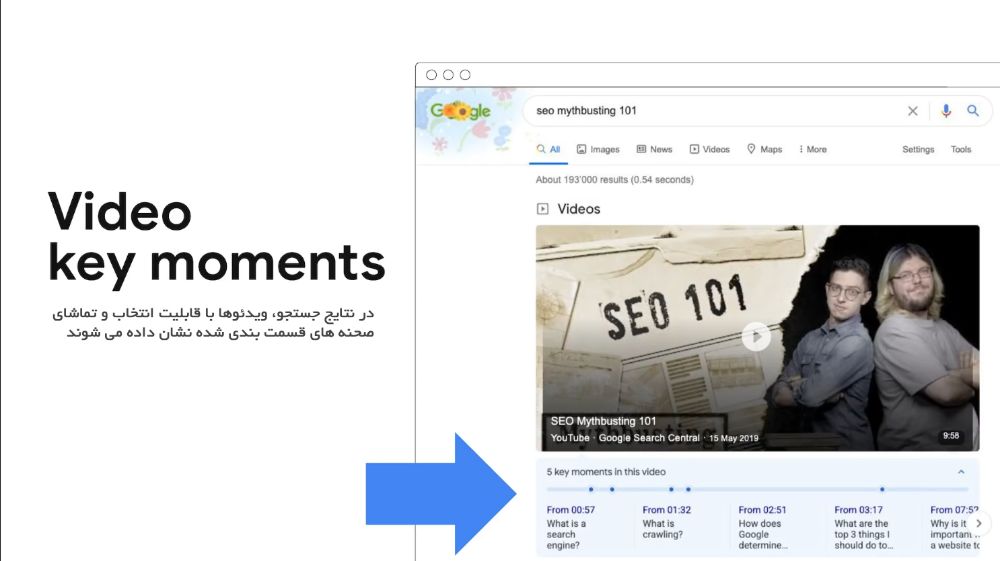
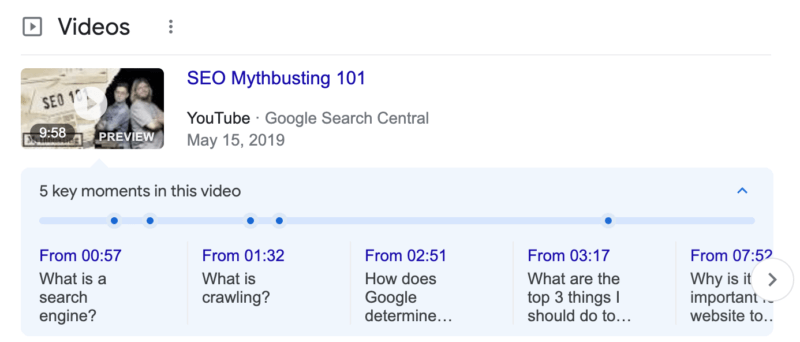
می خواهیم قابلیتی را در خصوص اسکیمای ویدئو معرفی کنیم که قرار است به وجد بیایید. به هنگام نمایش یک کلیپ در نتایج جستجو، این امکان در اختیار شماست تا به راحتی، لحظه ای که مد نظرتان است را مشاهده کنید. این روش به کاربر اجازه می دهد تا سریع تر و راحت تر به محتوای شما دست پیدا کند.
برای این ویژگی ما قصد داریم تا 2 داده غنی را ارایه کنیم:
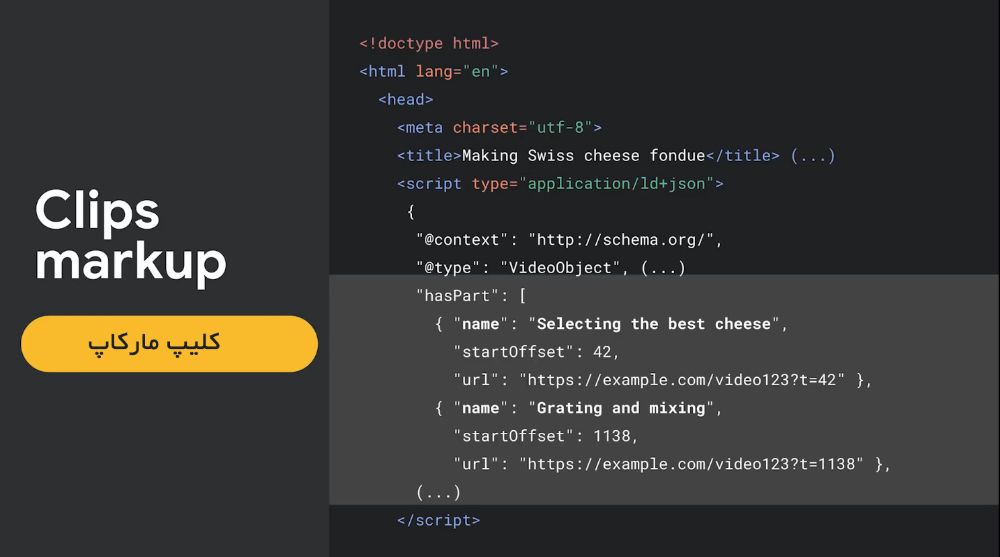
کلیپ مارکاپ - clip-markup: با این داده گذاری، یک وب سایت می تواند اطلاعاتی را بصورت قطعه یا قسمتی از یک کلیپ نمایش دهد که بصورت مستقیم در نتایج جستجو نشان داده می شود و به افراد اجازه می دهد تا مستقیما به همان قسمت از ویدئو بروند.
این کار اصلا سخت نیست و فقط لازم است تا با استفاده از تگ مربوطه، قسمتی که مد نظر تان است را به همراه آدرسی که مستقیما به آن ویدئو می رود، نشانه گذاری کنید.
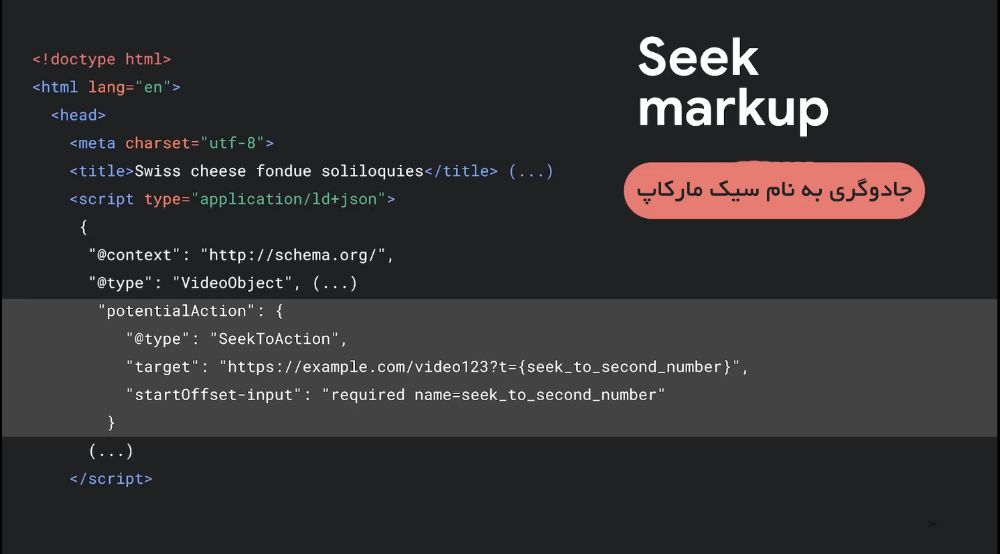
حال ممکن است در سایت، ویدئوهای زیادی داشته باشید و ترافیک سنگینی را میزبانی نمایید. گوگل با استفاده از تکنیک بسیار پیچیده و شگفت انگیز seek markup و با کمک منابع ماشین لرنینگ، می تواند محتوای ویدئویی شما را تحلیل و بخش هایی که در یک کلیپ وجود دارد را با محتوای موجود یا رفتار شناسی کاربران و همینطور فریم های داخلی آن، جدا کند. تمام کاری که باید بکنید این است که آدرس کلیپ و یا ویدئوی خود را در بدنه ی داده های ساختاری صفحه مشخص کنید و به اسکیمای فوق معرفی نمایید. ما خودمان باقی کار را انجام می دهیم. ویژگی های منحصر بفردی که شاهدش بودید در حال تکامل است.
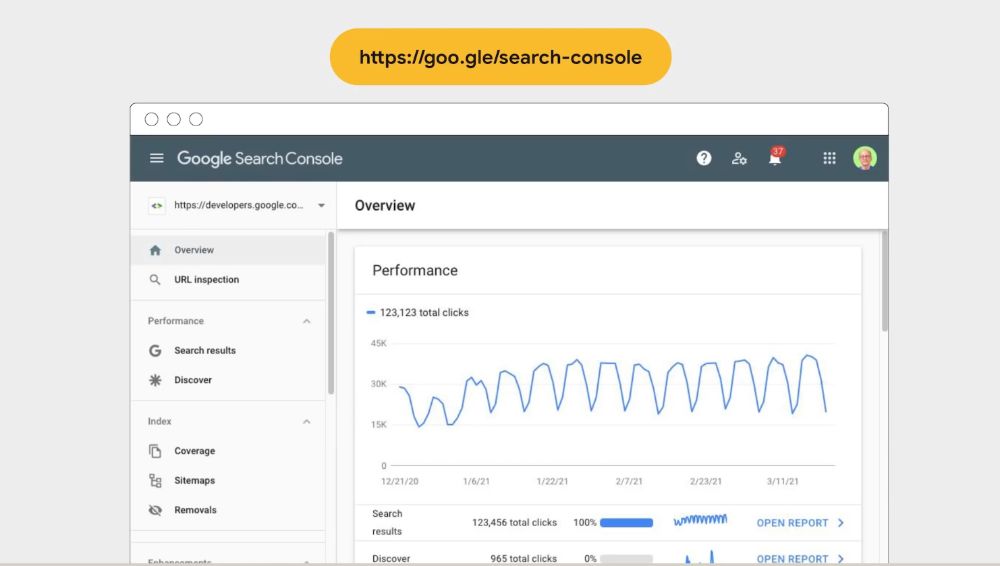
می خواهیم به شما مجموعه ی کاملی از ابزارهای بررسی و عیب یابی را برای نتایج جستجو معرفی کنیم که نام آن کنسول جستجوی گوگل می باشد. برای بهره مندی از امکانات حرفه ای و بی نظیر اش باید مالکیت سایت تان را برای گوگل اثبات کنید و اگر شخص دیگری بر روی آن فعالیت می کند، کافی است تا شما را به تیم اضافه نماید.
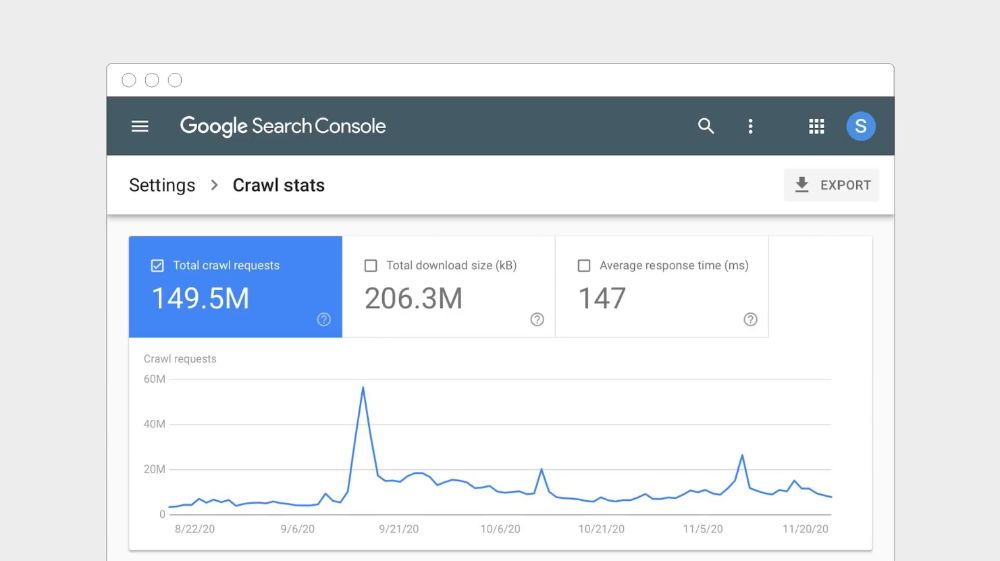
گزارش آمار خزش - Crawl stats Report: ابزاری کارآمد در کنسول گوگل است که به ما اطلاعاتی از قبیل میزان درخواست خزش، وضعیت سرور و پایدار بودن آن را بر اساس فاکتورهای متنوع و همینطور سایر اطلاعاتی که در طول مسیر مورد نیاز است، ارایه می کند.
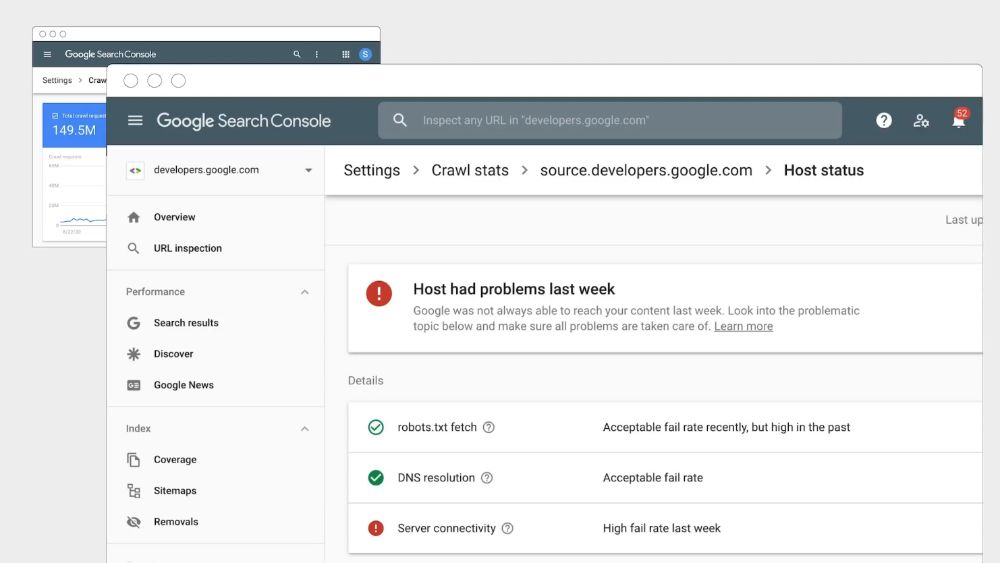
به عنوان توسعه دهنده معمولا برای تجزیه و تحلیل داده ها، سراغ لاگ سرور می روید، اما لازم است بدانید که در گزارش آمار خزش، همه چیز بهتر و آسان تر در اختیارتان است.
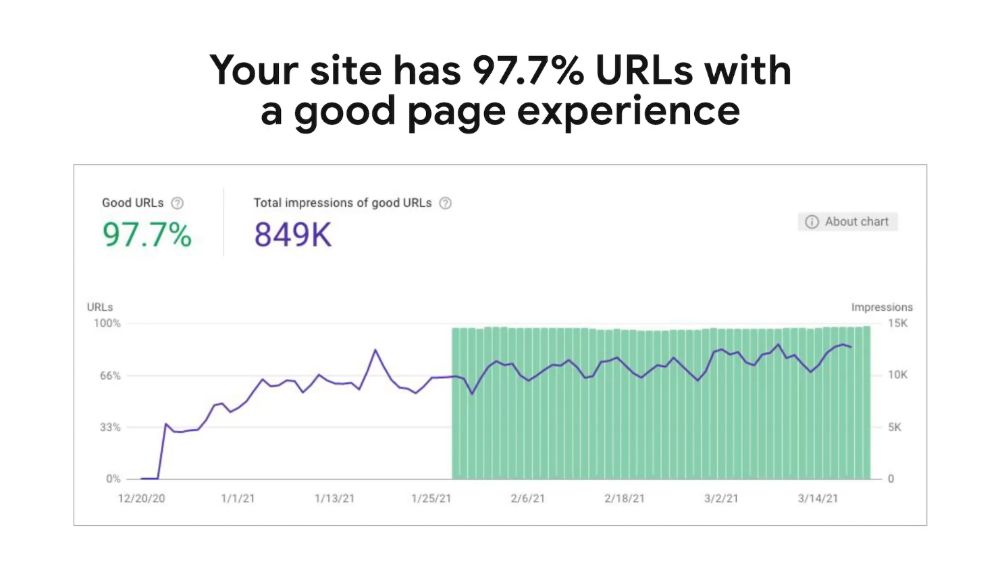
گزارش تجربه صفحه - Page experience: تجربه کاربری که به مهم ترین عامل رتبه بندی صفحات تبدیل شده است، به شما اطلاعات دقیقی از آدرس هایی می دهد که بر اساس فاکتورهای بهینه بودن برای موبایل، مرور ایمن، پروتکل Https و سربلند شدن از core web vitals با شاخص های متکی بر ترافیک کافی طبقه بندی شده و به نمایش در می آید. یک توسعه دهنده می تواند مشکلات را بصورت گسترده شناسایی و رفع نماید.
دنیای آنلاین دائما در حال تغییر است و گوگل در مسیر تکامل قدم بر می دارد.
از من هر چیزی بپرس، AMA:
رویداد گوگل آی/او - Google I/O:
واژه های cURL و wGET:
قابل خواندن توسط ماشین - Machine-readable data:
قابل خواندن توسط انسان - Human-readable data:
نکته: فایل های xml، یکی از فرمت های رایج دو وجهی است که هم توسط ماشین و هم توسط انسان قابل خواندن بحساب می آید. البته پایه این موضوع بر مبنی داده هایی است که انسان حتما می تواند درک کند و ماشین هم یک فرایند قابل فهم و خواندن را طی می کند.
سخن نویسنده: آیا بدنبال این هستید تا بفهمید گوگل چگونه محتوایی را قابل ایندکس یا بدرد نخور می داند؟ حتما این سوال برای شما هم پیش آمده که؛ مگر ممکن است که ربات های گوگل صفحه یا مطلبی را برای برای ایندکس کردن غیر مفید و بی ارزش بدانند؟ آن هم یک سایت فارسی زبان و در کسر کمتر از چند دقیقه! پاسخ شما با سرنخی به نام Machine-readable data و Human-readable data و همینطور دانش داده های ساختار یافته وارد مرحله موشکافی می گردد.
ترجمه، تولید محتوا و نویسنده: علیرضا ناجی
لیست بروز رسانی های این مقاله :
CopyRight:
This content is a translation of an original video that has been posted on YouTube. The source clip language has been converted to Persian for better understanding and educational purposes.
Resources used and copyright of works:
The official channel of Google Search Centeral
https://www.youtube.com/channel/UCWf2ZlNsCGDS89VBF_awNvA
What's new in Search | Session ,Resource
https://www.youtube.com/watch?v=VRmDxNBhzow
Podcast background OSD
song: Take Me To Paradise
by: Valentina Gribanova
publisher: storyblock
vocal: alireza naji
برای ترجمه و تالیف مقالات و محتوی غنی به زبان پارسی نیازمند | حمایت شما | هستم . از مهرتان سپاسگزارم .
حمایت از من در ریمیت ( https://reymit.ir/alirezanaji )
حمایت از من در زرین پال ( https://zarinp.al/alirezanaji.ir )
اینستاگرام من : instagram
ایمیل من : [email protected]


