
یک شبکه عصبی مصنوعی از چهار قسمت تشکیل شده است.
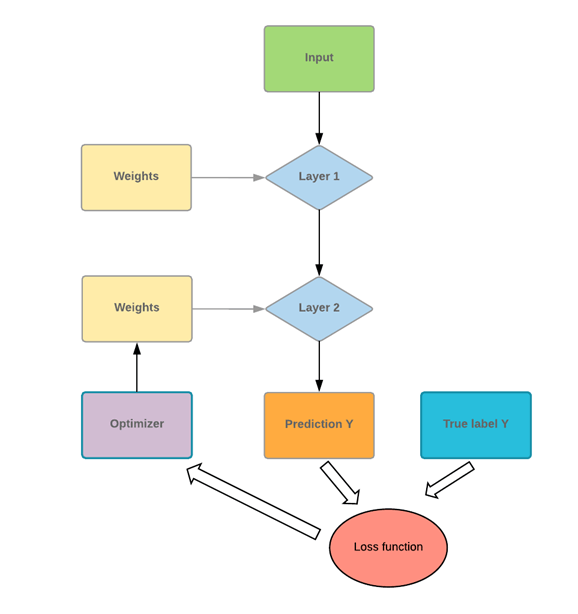
با توجه به تصویر بالا برنامه با گرفتن ورودی ها آن ها رو به دو لایه کاملا متصل وارد می کنه.مثلا فرض کنید یک مشکل ریاضی دارید اولین کاری که می کنید صورت سوال رو می خونید. دانش های خودتون رو برای حل سوال به کار می برید و احتمالا حل نمیشه :دی برای شبکه هم همینطوره سپس مثلا با مطالعه بیشتر سعی می کنید دانشتون رو بهبود بدید. برنامه هم همین کار رو می کنه تا وقتی که خطاش به کمترین حد ممکن برسه. و مثلا اگه به جایی برسه که نتونه بهبود بده مثل اینه که یک کتاب رو هزار بار خوندید فایده نداشته مثلا می تونید یک کتاب دیگه رو تست کنید. - چه مثالی شد!
لایه ها
یک لایه جایی هست که تمام یادگیری شکل می گیره. داخل یک لایه تعدادی نورون وجود داره. یک نوع از شبکه های عصبی شبکه های عصبی هست که تمام نورون های دو لایه همسایه بهم دیگه متصل میشند.
یک شبکه عصبی معمولی یک آرایه از ورودی ها میگیره و یک مقدار عددی به عنوان خروجی یا برچسب.
یک نمونه راحت دسته بندی دوگانه با شبکه عصبی هست. شبکه ورودی ها رو دریافت می کنه به تمام ند ها می فرسته و سیگنال خروجی رو به وسیله یک تابع فعال سازی محاسبه می کنه
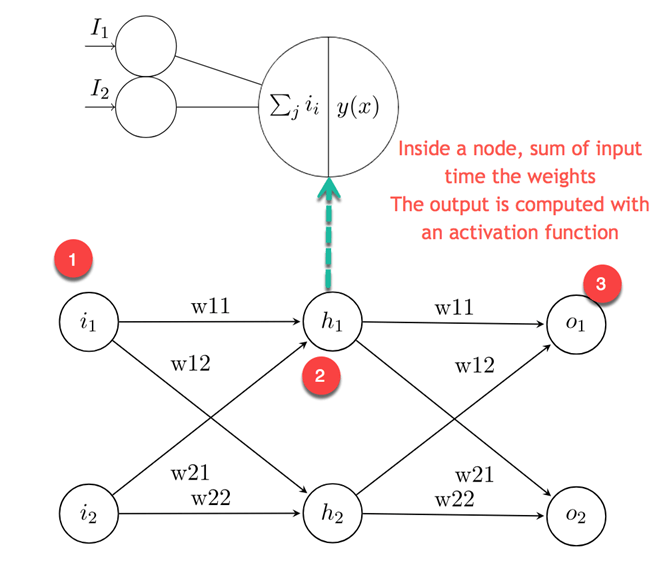
تصویر بالا نشون میده که لایه اول ورودی داده هاست و لایه دوم لایه مخفی هست که ورودی های وزن دار رو از لایه قبلی دریافت کرد.
تابع فعالسازی
تابع فعالسازی یک ند خروجی آن ند رو مشخص می کنه. شما برای یادگیری الگو های غیر خطی به تابع فعالسازی نیاز دارید. یک فعال ساز معرو Relu هست یا Rectified linear unit که برای اعداد منفی مقدار صفر رو بر می گردونه.
توابع فعال سازی دیگه مثل:
تصمیات حساس در زمان ساخت شبکه عصبی این هست که
البته هرچی لایه ها و ند ها بیشتر باشه می تونه پترن های پیچیده ای یاد بگیره ولی هزینه یادگیری زیاد میشه و در نتیجه زمان بیشتری باید سپری بشه.
برای دسته بندی دوگانه می تونید از تابع کاهش زیر استفاده کنید
cross entropy loss function
و برای رگرسیون خطی از:
mean square error
تابع کاهش معیار مناسبی برای تخمین میزان کارآیی بهبود دهنده هست و در طول یادگیری کاهش پیدا می کنه و باید به دقت بر اساس نوع مسئله انتخاب بشه.
تابع کاهش یک اندازه گیری برای کارایی مدل هست. بهبود دهنده کمک می کنه با بهبود وزن ها هزینه مدل رو کاهش بده.
برخی از بهبود دهنده ها در زیر می تونید ببینید:
بیش برازش (Overfitting)
یک مشکل رایج در شبکه های عصبی پیچیده مشکل تعمیم مدل به داده های مشاهده نشده هست. یک شبکه عصبی با وزن های زیاد می تونه به خوبی داده های داخل مجموعه یادگیری رو به خوبی تشخیص بده ولی داده های دیگه رو به سمت over fitting میره.مخصوصا وقتی که داده ها به طور مساوی بین دسته های مختلف تقسیم نشده باشند.
اینجا یک کم و زیاد کردنی بین بهبود و تعمیم مدل وجود داره که بهبود برای کاهش تابع هزینه مدل و تعمیم برای چگونگی برخورد مدل با داده های مشاهده نشده هست.
برای اینکه مدل یک سری از الگو های ناخواسته رو داخل داده ها کشف نکنه و دچار مشکل overfit نشه یک سری راهکار تحت عنوان regularization وجود داره
یک راه برای کاهش هزینه تعلیم و بیش برازش کاهش اندازه مدل هست در واقع قانونی برای اندازه و تعداد لایه ها وجود نداره ولی شما می تونید با مدل های کوچک شروع کنید تا وقتی که به over fit نخوردید.
یک راه استاندارد برای مقابله با overfitting افزودن یک سری ثابت به وزن های شبکه هست. مثلا
L1: Lasso: متناسب با قدر مطلق وزن ها
L2: Ridge: متناسب با مربع وزن ها
اگه یک لایه drop put داشته باشه ینی به صورت رندم با یه احتمال که بهش میدیم بعضی از وزن ها ۰ میشه.
خب می خواییم به وسیله DNNClassifier یک شبکه عصبی بر روی مجموعه داده MNIST بسازیم. خیلی ساده:
البته این رو با کراس می زنیم
import tensorflow as tf mnist = tf.keras.datasets.mnist (x_train, y_train),(x_test, y_test) = mnist.load_data() x_train, x_test = x_train / 255.0, x_test / 255.0 model = tf.keras.models.Sequential([ tf.keras.layers.Flatten(input_shape=(28, 28)), tf.keras.layers.Dense(512, activation=tf.nn.relu), tf.keras.layers.Dropout(0.2), tf.keras.layers.Dense(10, activation=tf.nn.softmax) ]) model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy']) model.fit(x_train, y_train, epochs=5) model.evaluate(x_test, y_test)
یک شبکه عصبی شامل موارد زیر هست:


