
آپدیتها:
تقریبا ۴ هفته قبل از انتشار همین نوشته، پست معرفی «هزار» رو روی لینکدین منتشر کردیم و با استقبال غافلگیرکننده کاربران مواجه شدیم. قبلش تصمیم گرفته بودیم که وقتی مخزن «هزار» روی گیت هاب به ۲۰۰ تا استار رسید یه پست معرفی درست درمون روی ویرگول منتشر کنیم و خیال میکردیم چند ماهی طول میکشه احتمالا؛ ولی به لطف حمایتهای جانانه کامیونیتی متنباز فارسی، تو همون سه روز اول این عدد رو رد کردیم که شاید در تاریخ اوپن سورس ایران بی سابقه بوده و حقیقتا به تمام کسانی که بیدریغ حمایت کردن مدیونیم و با تمام قوا رو به جلو پیش میریم تا بتونیم این حمایتها رو جبران کنیم ??
سرتونو درد نیاریم؛ چون این معرفی به اندازه کافی طولانی هست (ولی قول میدیم جذاب باشه!).
اول بیاین با جواب دادن به چند تا سوال شروع کنیم.
«هزار» دقیقا چیه؟
«هزار» یک کتابخونه و فریموورک برای به کارگیری مدلها و الگوریتمهای مبتنی بر هوش مصنوعی برای زبان فارسیه و برای کاربردهای مختلفی از جمله پردازش متن، تصویر و صوت مدلهای مختلفی داره.
از جمله مدلهایی که در هزار برای کاربردهای مختلف وجود داره میشه به موارد زیر اشاره کرد:
البته هزار فقط محدود به مدلها نیست بلکه انواع روشهای پیش پردازش داده مثل توکنایزر، استخراج ویژگی، نرمالایزر و … و همچنین تکنیکهای مختلف آموزش مدل و پیادهسازیهای آماده اجزای مختلف یک خط لوله آموزش مدل و … رو هم شامل میشه.
آدرس گیتهاب هزار: https://github.com/hezarai/hezar (استار⭐ یادتون نره?)
آدرس مستندات هزار: https://hezarai.github.io/hezar
کانال تلگرام هزار: https://t.me/hezarai
اصلا چرا «هزار» ساخته شد؟
اگر تو حوزه هوش مصنوعی فعال باشید و تجربه کار با دیتای فارسی رو داشته باشید حتما حس کردید که متاسفانه این حوزه تو ایران کویره (حداقل از نظر منابع متنباز و آزاد). منکر این نیستیم که کارهای خیلی خفنی در همین چند سال اخیر در این حوزه انجام شده و در دسترس عموم قرار گرفته اما باز هم میشه گفت که منابع پراکنده هستند و دسترسی و پیدا کردن بعضیاشون خیلی سخته. بعضی از این منابع هم قدیمی هستند و دیگه پشتیبانی نمیشن! از طرفی هم هر منبعی با یک دست خطی نوشته شده و اگر به فرض یه روزی بخواید مدلهای آماده فلان تسک رو از جاهای مختلف پیدا کنید و همه رو دونه دونه تست کنید کلی دردسر دارید!
هزار با این ایده شروع شد که خیلی خوب میشه اگه یه بستری ایجاد بشه که به کمک اون تمام کارهای خفن هوش مصنوعی که برای فارسیزبانها انجام شده (یا در آینده انجام میشه) رو به راحتی استفاده کرد یا توسعه داد. این کار از چند جهت مفیده:
چرا اسمش شد «هزار»؟
اولین اسمی که تو ذهنمون بود «myriad» بود (صرفا چون اسم باحالی بود) که واحد شمارش ده هزارتاییه. بعدا تغییر داده شد به «chiliad» («کیلیاد») که واحد شمارش هزارتاییه و بعدتر بخاطر اینکه اساس این کتابخونه برای زبان فارسی هست، یه اسم فارسی نیاز داشت که نهایتا به «هزار» ختم شد. از طرفی این اسم، یک کمیت و اندازه نسبتا بزرگی رو نشون میده و تقریبا نمایانگر هدف اصلی این پروژه یعنی گسترش دانش هوش مصنوعی با توسعه و انتشار مدلهای متعدد هست.
خب دیگه وقتشه که بریم سراغ یه دموی کلی از قابلیتهای هزار.
برای یک آموزش جامع از نحوه استفاده از همه جوانب مختلف هزار، به صفحه داکیومنتها مراجعه کنید.
https://hezarai.github.io/hezar/tutorial/index.html
هزار یک پکیج پایتون روی PyPi داره و میتونید مثل هر پکیج دیگهای رو پایتون به این شکل نصبش کنید.
pip install hezar
اگرم احیانا خواستین آخرین نسخهای که داریم توسعه میدیم رو از روی سورس نصب کنید میتونید این شکلی انجامش بدید.
pip install git+https://github.com/hezarai/hezar.git
اولین و مهمترین کاربرد هزار، توی استفاده از مدلهای از پیش آماده هست. تنها کاری که نیازه اینه که برید داخل مدل هاب هزار روی Hugging Face و مدل مدنظرتون رو انتخاب کنید. نام مدلها بر اساس معماری یا نام مدل اصلی و تسک اون مدل قابل شناسایی هست. یعنی مثلا مدل hezarai/vit-roberta-fa-image-captioning-flickr30k یک مدل برای image captioning هست که با معماری ترکیبی ViT + RoBERTa و روی دیتاست flickr30k آموزش داده شده. حالا چطور میشه مدلها رو استفاده کرد؟ هر مدلی که روی هاب میبینید رو با کد زیر میتونید لود کنید:
from hezar.models import Model
model = Model.load('hezarai/<MODEL PATH>')
این دستور در پس زمینه، وزنهای مدل و تمام محتویات موردنیاز مثل کانفیگ و فایلهای پیشپردازش و توکنایزر و ... رو لود میکنه و مدل رو برای inference آماده میکنه و از اینجا میشه با استفاده از دستور `()predict.` خروجی مدل روی ورودی مدنظر رو گرفت.
from hezar.models import Model example = ['هزار، کتابخانهای کامل برای به کارگیری آسان هوش مصنوعی'] model = Model.load('hezarai/bert-fa-sentiment-dksf') outputs = model.predict(example) print(outputs)
خروجی هر مدل نسبت به تسک اون مدل متفاوته. مثلا خروجی مثال بالا که یک مدل دسته بندی هست به این شکله:
[[{'label': 'positive', 'score': 0.812910258769989}]]
چند نمونه دیگه برای مثال ببینید:
from hezar.models import Model

ner_model = Model.load('hezarai/bert-fa-ner-arman')  # Named entity recognition
inputs = ['شرکت هوش مصنوعی هزار']
ner_outputs = ner_model.predict(inputs)
print(f'NER: {ner_outputs}')
NER: [[{'token': 'شرکت', 'label': 'B-org'}, {'token': 'هوش', 'label': 'I-org'}, {'token': 'مصنوعی', 'label': 'I-org'}, {'token': 'هزار', 'label': 'I-org'}]]
from hezar.models import Model

pos_model = Model.load('hezarai/bert-fa-pos-lscp-500k')  # Part-of-speech
inputs = ['شرکت هوش مصنوعی هزار']
pos_outputs = pos_model.predict(inputs)
print(f'POS: {pos_outputs}')
POS: [[{'token': 'شرکت', 'label': 'Ne'}, {'token': 'هوش', 'label': 'Ne'}, {'token': 'مصنوعی', 'label': 'AJe'}, {'token': 'هزار', 'label': 'NUM'}]]
from hezar.models import Model

roberta_mlm = Model.load('hezarai/roberta-fa-mlm')
inputs = ['سلام بچه ها حالتون <mask>']
outputs = roberta_mlm.predict(inputs)
print(outputs)
[[{'token': 'چطوره', 'sequence': 'سلام بچه ها حالتون چطوره', 'token_id': 34505, 'score': 0.2230483442544937}]]
from hezar.models import Model

whisper = Model.load('hezarai/whisper-small-fa')
transcripts = whisper.predict('examples/assets/speech_example.mp3')
print(transcripts)
[{'text': 'و این تنها محدود به محیط کار نیست'}]
from hezar.models import Model

model = Model.load('hezarai/crnn-base-fa-64x256')
texts = model.predict('examples/assets/ocr_example.jpg')
print(f'CRNN Output: {texts}')
CRNN Output: [{'text': 'چه میشه کرد، باید صبر کنیم'}]
from hezar.models import Model

model = Model.load('hezarai/crnn-fa-64x256-license-plate-recognition')
plate_text = model.predict('assets/license_plate_ocr_example.jpg')
print(plate_text)  # Persian text of mixed numbers and characters might not show correctly in the console
[{'text': '۵۷س۷۷۹۷۷'}]
from hezar.models import Model

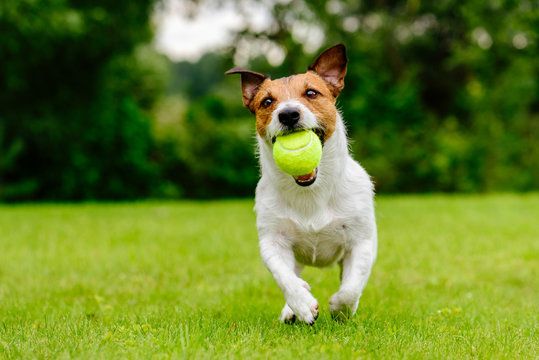
model = Model.load('hezarai/vit-roberta-fa-image-captioning-flickr30k')
texts = model.predict('examples/assets/image_captioning_example.jpg')
print(texts)
[{'text': 'سگی با توپ تنیس در دهانش می دود.'}]
from hezar.embeddings import Embedding

fasttext = Embedding.load('hezarai/fasttext-fa-300')
most_similar = fasttext.most_similar('هزار')
print(most_similar)
[{'score': 0.7579, 'word': 'میلیون'},
{'score': 0.6943, 'word': '21هزار'},
{'score': 0.6861, 'word': 'میلیارد'},
{'score': 0.6825, 'word': '26هزار'},
{'score': 0.6803, 'word': '٣هزار'}]
شاید بشه گفت مهمترین عاملی که باعث میشه برای یک زبان، مدلهای خوبی تولید بشه، تعداد و تنوع دیتاستها برای اون زبان هست. هزار بستری برای فراهمسازی و به کارگیری ساده دیتاستها هم در خودش داره. دیتاست های هزار هم داخل هاگینگ فیس هستن و هر دیتاستی رو میتونید هم به فرمت هاگینگ فیس (که دیتاست خام هست) و هم به فرمت هزار (که یک کلاس شسته رفته پایتورچی و آماده استفاده برای آموزش بهتون میده) لود کنید.
from hezar.data import Dataset  # For Hezar dataset format
from datasets import load_dataset  # For Hugging Face dataset

# Hugging Face
dataset = load_dataset('hezarai/xlsum-fa')
# Hezar
dataset = Dataset.load('hezarai/xlsum-fa')  # Returns a `TextSummarizationDataset` instance
برای مشاهده همه دیتاستها اینجا کلیک کنید.
آموزش مدلهای هزار با استفاده از دیتاستهای هزار بسیار ساده و سر راسته! در حال حاضر به این شکل میتونید یک مدل رو روی یک دیتاست از داخل هاب آموزش بدید.
مدلی که میخوایم آموزش بدیم (در واقع فاین تون کنیم) مدل DistilBERT برای تسک دستهبندی متن (تشخیص احساسات در این مثال) روی دیتاست ترکیبی کامنتهای دیجیکالا و اسنپفود هست. اول، همه چیزایی که نیازه رو ایمپورت میکنیم:
from hezar.models import DistilBertTextClassification, DistilBertTextClassificationConfig
from hezar.trainer import Trainer, TrainerConfig
from hezar.data import Dataset
from hezar.preprocessors import Preprocessor
حالا آدرس دیتاست روی هاب و همینطور مدل پایهای که میخوایم فاین-تیونش کنیم رو تعریف میکنیم.
DATASET_PATH = 'hezarai/sentiment-dksf'  # dataset path on the Hub
BASE_MODEL_PATH = 'hezarai/distilbert-base-fa'  # used as model backbone weights and tokenizer
حالا کلاس دیتاستهای آموزش و ارزیابی رو لود میکنیم که خروجیش از جنس PyTorch Dataset هست.
train_dataset = Dataset.load(DATASET_PATH, split='train', tokenizer_path=BASE_MODEL_PATH)
eval_dataset = Dataset.load(DATASET_PATH, split='test', tokenizer_path=BASE_MODEL_PATH)
حالا بریم مدل و پیشپردازشگر مناسب مدل رو لود کنیم.
model = DistilBertTextClassification(
 BertTextClassificationConfig(id2label=train_dataset.config.id2label)
)
preprocessor = Preprocessor.load(BASE_MODEL_PATH)
مدلمون از کلاس DistilBertTextClassification هست و داخل کانفیگ هم نیازه که id2label رو تعیین کنیم تا لایه آخر به درستی ساخته بشه که مقدارش رو از دیتاست برمیداریم. پیش پردازشگر این مدل هم فقط یک توکنایزر هست که درواقع با مدل پایه که دیستیلبرت هست یکیه.
دیتاست و مدل و پیشپردازشگر آمادهست. الان باید یک کانفیگ برای آموزش تعیین کنیم که تنظیمات آموزش مدل رو مشخص میکنه.
train_config = TrainerConfig(
    task='text_classification',
    device='cuda',
    init_weights_from=base_model_path,
    batch_size=8,
    num_epochs=5,
    checkpoints_dir='checkpoints/',
    metrics=['f1'],
)
پارامترهایی که تعیین کردیم به این شرح هستن:
در مرحل نهایی آبجکت Trainer رو میسازیم و آموزش رو انجام میدیم. (پارامترهای اجباری Trainer مواردی هستند که در این قطعه کد میبینید.)
trainer = Trainer(
    config=train_config,
    model=model,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    data_collator=train_dataset.data_collator,
    preprocessor=preprocessor,
)
trainer.train()
Epoch: 1/5      100%|####################################| 3576/3576 [07:07<00:00,  8.37batch/s, f1=0.732, loss=0.619]
Evaluating...   100%|####################################| 290/290 [00:07<00:00, 38.64batch/s, f1=0.8, loss=0.473]
Epoch: 2/5      100%|####################################| 3576/3576 [07:00<00:00,  8.50batch/s, f1=0.807, loss=0.47]
Evaluating...   100%|####################################| 290/290 [00:07<00:00, 39.87batch/s, f1=0.838, loss=0.419]
Epoch: 3/5      100%|####################################| 3576/3576 [07:01<00:00,  8.48batch/s, f1=0.864, loss=0.348]
Evaluating...   100%|####################################| 290/290 [00:07<00:00, 39.97batch/s, f1=0.875, loss=0.346]
Epoch: 4/5      100%|####################################| 3576/3576 [06:57<00:00,  8.56batch/s, f1=0.919, loss=0.227]
Evaluating...   100%|####################################| 290/290 [00:07<00:00, 38.84batch/s, f1=0.875, loss=0.381]
Epoch: 5/5      100%|####################################| 3576/3576 [07:02<00:00,  8.46batch/s, f1=0.943, loss=0.156]
Evaluating...   100%|####################################| 290/290 [00:07<00:00, 39.71batch/s, f1=0.887, loss=0.446]
بعد از هر ایپاک لاگ معیارها هم در Tensorboard و هم در یک فایل csv ذخیره میشه.
اگر دوست داشتید میتونید همه محتویات آموزش شامل کانفیگها و مدل و پیشپردازشگر و لاگها رو به هاب اپلود کنید.
trainer.push_to_hub('<your-hf-username>/distilbert-fa-sentiment-dksf')
«هزار» حقیقتا پروژه بزرگیه و به دلیل اینکه ابعاد بسیار زیادی داره، خیلی خیلی وسواسانه نوشته شده و علاوه بر رعایت اصل سادگی استفاده برای کاربر، برای توسعه دهندگان این فریموورک هم خیلی راحت و سرراسته. معماری «هزار» طوریه که همواره سعی شده روی بهترین ابزارهای موجود سوار باشه تا هم چرخ اضافیای اختراع نشه و هم استفاده از هر جزئی برای عموم راحت و آشنا باشه. تمام مدلهای هزار با فریموورک PyTorch ساخته شدن و هر مدلی که تو هزار هست کاملا رفتار یک مدل عادی پایتورچ رو داره. بقیه موارد از جمله دیتاستها، پیش پردازشگرها و ... هم بر پایه ابزارهایی هستند که اکثریت باهاش آشنایی دارن. از طرفی سعی شده تا حد امکان از کامپوزیشن توی معماری استفاده نشه تا به راحتی هر کس بتونه یه تیکه از کد رو کپی کنه و هر جور خواست استفاده کنه! برای اطلاعات بیشتر راجع به معماری هزار در لایههای پایینتر به قسمت Developer Guides مراجعه کنید.
مهمترین هدف هزار دموکراتیزه کردن هوش مصنوعی برای فارسیزبانان هست. به شکل جزئیتر اهداف هزار عبارتند از:
تا به اینجای کار، قسمت اعظم توسعه این پروژه متمرکز بر مباحث زیرساختی و معماری این فریموورک بوده و مدلهایی که منتشر شده ظرف بازه بسیار کوتاهی آموزش داده شدن. این مدلها بسیار جای پیشرفت دارن و تیم هزار همواره در این جهت تلاش میکنه. بعد از استیبل شدن کلی «هزار»، برنامههای زیادی برای توسعه مدلهای بسیار بزرگتر و پیچیدهتر داریم و در این راه قطعا از هر کمک، حمایت و مشارکتی استقبال ویژه میکنیم.
بزرگترین انگیزه تیم هزار برای ادامه، حمایت و مشارکت جامعه توسعه دهندگان فارسیه. مشارکت برای همه افراد آزاد هست و شامل موارد زیر میشه:
اگر پیام یا درخواست تکنیکال دارید راه ارتباطی پیشنهادی ما issue یا discussion زدن روی گیتهابه اما اگر دوست دارید شخصا در تماس باشید میتونید از طریق ایمیل یا لینکدین هم پیام بدین ?


