
از این سری: یک دور با Druid از صفر تا صد
این پست حاصل تلاش من برای فهم کافکاست و بیان روش من برای فهم یک موضوع: رفتن قدم به قدم در یک دور کامل از صفر تا صد. برای نوشتن این پست از نتایج سرچهایم، کتاب Kafka: The definitive guide، این لینک، سورس کافکا و Jocko و درایور ساراما از Shopify استفاده کردهام اما به هر حال ممکن است فهم من در موردی غلط باشد که این لطف شماست اگر آنرا اصلاح کنید.
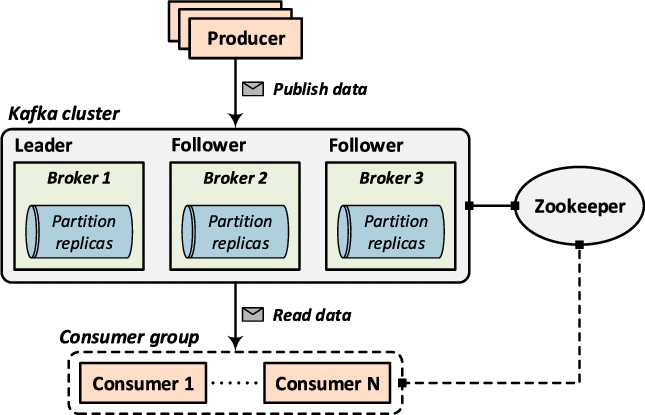
اگه بخوایم پوستپیازی بریم جلو، اول کار یه کلاستر کافکا داریم که از هاستهای مختلفی (حداقل یکی) که یه نسخه از کافکا رو اجرا کردن و با هم مرتبط شدن تشکیل شده. به هر کدوم از اون instanceهای داخل کلاستر میگیم بروکر. هر بروکر هم از تعدادی تاپیک تشکیل شده. تاپیک چیزیه مثل سطلهای اسمدار ارتباط با مسئولین که هر کی هر چی بخواد به یه مسئول خاص بگه رو میاد میندازه داخلش. هر تاپیک از یک یا چند پارتیشن تشکیل شده که به صورت فیزیکی پیامها در اونا ذخیره میشه. پارتیشنها داخل یه کلاستر توزیع میشن و برای هر پارتیشن یکی از بروکرها به عنوان رهبر انتخاب میشه. در نهایت هم پیام (که هر چیزی به صورت آرایهای از بایتها میتونه باشه) رو داریم که توسط یه تولیدکننده (Producer) به کلاستر تحویل داده میشه و لیدر پس از دریافت کردن اون داخل یکی از پارتیشنهای تاپیکی که خواسته شده مینویسه و به یه تعداد مشخص از بروکرها هم میگه که اون پیام رو ذخیره کنن. در نهایت هم هر وقت که نیاز شد مصرفکنندهها (Consumer) میتونن بیان و از پیام استفاده کنن. کلاینت نیازی نیست بدونه یه پارتیشن از یه تاپیک در کجای کلاستر وجود داره یا رهبر برای فلان پارتیشن کیه و هر زمان میتونه از هر یک بروکرها اطلاعاتی از این قبیل رو دریافت کنه.
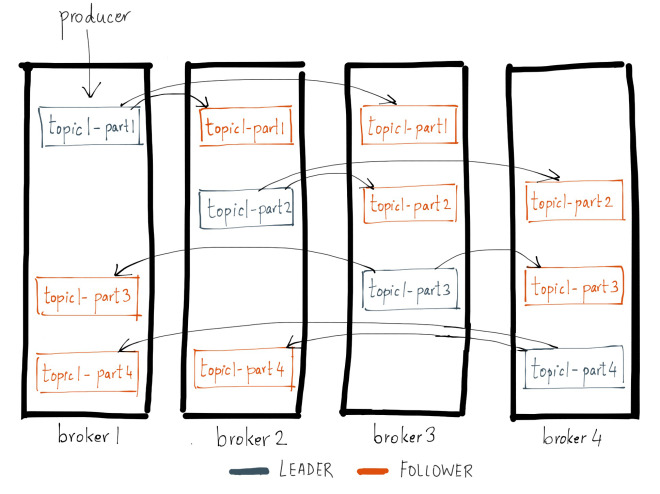
گفتیم که هر تاپیک میتونه به یک یا چند پارتیشن تقسیم شه و هر کدوم از پارتیشنها هم میتونن داخل بروکرهای مختلفی ذخیره شن. در واقع برای اینکه پیامها به هر دلیلی از بین نرن، به یه تعداد مشخص (که بهش replication factor میگیم) که موقع ساختن تاپیک مشخص میشه (و بعدا میشه افزایشش داد) روی بروکرهای مختلف از پیام کپی تهیه میشه. در نهایت برای هر پارتیشن یکی از بروکرهایی که اون پارتیشن رو داره به عنوان رهبر انتخاب میشه و مسئولیت دریافت/پسدادن پیامها رو به عهده میگیره. رهبر بعد از دریافت پیام اون پیام رو ذخیره میکنه و از رهروان خودش هم میخواد که اون پیام رو ذخیره کنن.
هر چند نادر ولی به هر حال اتفاقیه که میتونه بیفته و یک رهبر بمیره. اگه این اتفاق بیفته از بین لیست بروکرهایی که با رهبر قبلی کامل هماهنگ بودن (ISR: in-sync replicas) یک بروکر به عنوان رهبر انتخاب میشه و باقی ماجرا همونه که بود. این کار به وسیلهی ZooKeeper انجام میشه. در واقع با بالا اومدن کلاستر یک بروکر نقش کنترلر رو به عهده میگیره و در زمان از بین رفتن رهبر زوکیپر بهش اطلاع میده که فلان رهبر مرد. کنترلر از بین ISR یه بروکر رو به عنوان رهبر انتخاب میکنه و ماجرا ختم به خیر میشه. البته حالتی هم هست که میشه برای کل کلاستر یا یک تاپیک مشخص، اجازه داد رهبر از یکی از بروکرهایی که داخل ISR نیستن انتخاب شه که انتخاب بین این دو استراتژی به مورد استفاده بر میگرده.
یه نکتهای در انتخاب رهبر هست اینه که اگه بعد از انتخاب رهبر جدید، رهبر قبلی خودش رو باز در لیست ISR وارد کنه، باز به عنوان رهبر پارتیشن انتخاب میشه (به اون بروکر رهبر ترجیحی Preferred Leader گفته میشه و همیشه اولین بروکریه که موقع گرفتن اطلاعات یک تاپیک برای یک پارتیشن در لیست میاد). برای تغییر رهبر ترجیحی باید به صورت صریح از داخل کد یا خط فرمان عمل کرد.
در نهایت اگه لیست ISR خالی شه کافکا اکسپشن میده و برای از بین نرفتن پیامها و محاسبات، این وظیفهی تولیدکنندهها/مصرفکنندههاست که مدام برای تولید/مصرف تلاش کنن تا وضعیت به حالت عادی برگرده.
گفتیم که رهبر توسط کنترلر انتخاب میشه، اما اگه خود کنترلر بترکه چی؟ برای فهمیدن جواب این سوال ببینیم کنترلر چطور انتخاب میشه. برای بالا آوردن یه کلاستر کافکا، گفتیم که از ابزاری به اسم ZooKeeper استفاده میکنیم. در واقع اول این ابزار بالا میاد (و کارهایی مثل انتخاب رهبر و اینا اونجا هم انجام میشه :دی) و بعد ما شروع به استارت کردن بروکرها و ثبتشون در کلاستر میکنیم. اولین بروکری که بتونه خودش رو به زوکیپر بشناسونه و اسمش رو در یک مسیر مشخص ثبت کنه، کنترلر خواهد شد. این اتفاق در صورت مرگ کنترلر هم اتفاق خواهد افتاد، یعنی با مرگ کنترلر زوکیپر اعلام میکنه که به کنترلر نیاز داریم و باز هر کی اول نشست، اون برندهست :)).
این احتمال هم ممکنه که یکی از رهروان برای مدت مشخصی (که داخل تنظیمات کافکا میاد) خودش رو با لیدر هماهنگ نگه نداره و یا تعداد مسیجهایی که با رهبر فاصله داره خیلی زیاد شه. در این حالت رهبر اون فالور رو از لیست ISR خارج میکنه. با زنده شدن دوباره، فالور خودش رو در حالت بازیابی قرار میده و تلاش میکنه خودش رو با لیدر سینک کنه (مسیجها رو از لیدر Pull میکنه) و در نهایت زمانی که خودش رو سینک کرد به این لیست بر میگرده.
پیام رو اگه آدم در نظر بگیریم، وقتی به بروکر میرسه (در واقع Push میشه) یه سری اطلاعات بهش اضافه میشه که میشه اون رو پاسپورت طرف دونست. در ادبیات کافکا به اون رکورد میگیم. پس رکورد شد اون چیزی که داخل خودش پیام و ملحقاتش (مثل کلید یا اطلاعات تاپیک و پارتیشن) رو داره و یه سری اطلاعات مربوط به اون (مثلا زمان دریافت) رو هم ذخیره کرده و روند اینطور شد که تولیدکننده به ترتیب از لیستی که داره (bootstrap servers) میپرسه که من این پیام رو میخوام تو اون پارتیشن فلان تاپیک ذخیره کنم. کجا بفرستم؟ جوابی که میگیره آدرس رهبره و تولیدکننده پیام رو به رهبر اون پارتیشن تحویل میده. این وسط اگه برنامهنویس پارتیشن رو به صورت مشخص در داخل کد مشخص نکرده باشه، شمارهی پارتیشن اینطور انتخاب میشه:
پیام وقتی به لیدر رسید، لیدر چک میکنه تا ببینه تولیدکنندهی این پیام در صورت نیاز دسترسیهای مورد نیاز برای اون تاپیک رو داره و اگه مشکلی نبود، پیام رو روی پارتیشنی که مسئولشه ذخیره میکنه. در واقع پارتیشن یه WALه که پیامها با یک شمارهی اکیدا افزایشی (Offset) روش ذخیره میشن (در واقع ترتیب فقط داخل پارتیشن وجود داره). بعد از اینکه لیدر پیام رو برای خودش ذخیره کرد، به همهی رهروان خودش میگه که بیاین پیام جدید رو ذخیره کنین و منتظر تائید ذخیره (ack) از طرف اونا میمونه. پیام بنابر سیاست تولیدکننده تا زمانی که اتفاق مشخصی در مورد ack از طرف رهروان دریافت نشه کامیت نمیشه و پیامی که کامیت نشده باشه هم کانسیوم نمیشه. سیاست تولیدکننده میتونه یکی از این سه مورد باشه:
برای مصرف پیام، به مصرفکننده میگیم که شروع به گرفتن پیامهای یک یا چند پارتیشن از یک یا چند تاپیک کنه. این کار در یک حلقهی بینهایت انجام میشه و به این صورته که کانسیومر لیدر هر پارتیشن رو انتخاب میکنه (و اطلاعاتش رو کش میکنه) و هر بار در حلقه آخرین اطلاعات مصرفنشدهی پارتیشنها رو بر میگردونه (اطلاعات رو از کافکا Pull میکنیم) و این کار تا زمانی که اکسپشنی رخ بده یا خودمون بخوایم ادامه پیدا میکنه. اطلاعات برگشتی در واقع آرایهای از رکوردهایی که ذخیره شده (شامل مسیج، کلید، اطلاعات تاپیک، زمان و ... که در بالا در مورد صحبت کردیم) هستن. معمولا استفاده از یک مصرفکننده خیلی کاربردی نداره و چند مصرفکننده داخل یک گروه این مسئولیت رو به عهده میگیرن.
گفتیم که مسیجها داخل پارتیشنهای یک تاپیک به ترتیب میشینن و اینجاست که پای کانسیومر گروپها به ماجرا باز میشه. یک گروه مجموعهای از کانسیومرهاست که دارای آیدی مشترکن (مثل تیم فوتبال که مثلا بازیکنهای استقلالی که سرور پرسیپولیسه، بهشون میگن تیم استقلال). اطلاعات مصرف از تاپیکها برای گروهها اینطور ثبت میشه که برای هر پارتیشن از یک تاپیک از یک گروه، تا کجا مسیجها پردازش شدن.
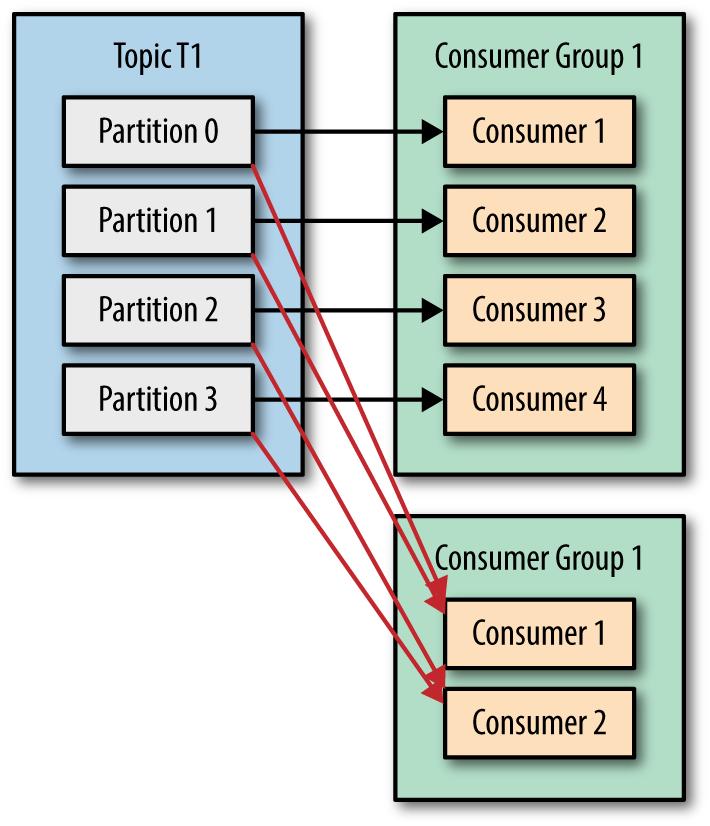
اما شیوهی مصرف در یک گروه اینطوره که هر پارتیشن باید یکی از کانسیومرها رو به عنوان مصرفکننده داشته باشه و از یک گروه، دوتا کانسیومر نمیتونن به یک پارتیشن بچسبن. این یعنی اگه گروه یک کانسیومر داشته باشه و تاپیک پنجتا پارتیشن، اون یک کانسیومر مشترک هر پنجتا پارتیشن میشه و اگه دوتا کانسیومر باشه، مثلا یکی دوتا پارتیشن بر میداره و یکی سهتا. برای وقتی که گروه پنجتا کانسیومر داشته باشه، هر کانسیومر دقیقا یک پارتیشن رو بر میداره و در نهایت اگه هفتتا کانسیومر داخل اون گروه باشن، دوتا کانسیومر بیکار خواهند بود و بیمصرف و انگل جامعه. این نشون میده بهترین حالت اینه که تعداد کانسیومرهای یک گروه با تعداد پارتیشنهای یک تاپیک برابر باشه. چون اگه کمتر باشه یک کانسیومر مجبوره حداقل دوتا پارتیشن رو برداره و اگه محاسبات طول بکشه، طول میکشه تا پیامهای بعدی اون پارتیشن پردازش شن و اگه بیشتر هم باشه که الکی منابع سیستم هدر رفته. طریقهی مصرف هر یک از کانسیومرها هم که مثل بخش قبله. در نهایت وقتی محاسبه تموم شد آفست اون مسیج پارتیشن برای اون گروه کامیت میشه و شمارهی آخرین افست بروز میشه.
از این به بعد هر وقت که یک عضو به گروه اضافه شه (مثلا برای ۵ پارتیشن، ۲ مصرفکننده داخل گروه بوده)، به راحتی میشه ازش برای مصرف پیامها استفاده کرد. در واقع در گروه برای مصرف یک rebalance انجام میشه و با رعایت شرحی که اومد به عوض جدید هم یک یا چند پارتیشن اساین میشه. اگه هم که مشکلی پیش بیاد و سرویس ریست بشه، اینطور مشخصه که برای این گروه از کجا باید ادامهی پردازش رو برای هر پارتیشن ادامه داد.
به هر دلیل ممکنه هر جایی از سیستم بترکه و باید فکری برای پیامهایی که در ماجرا درگیر بودن برداشت. برای هر پیام سهتا حالت رو میتونیم در نظر بگیریم:
برای پیادهسازی Exactly Once Semantic کافکا راه رو به دو شقه تبدیل کرده. یکی وقتی که پیام داره تولید میشه و دیگری وقتی که پیام مصرف میشه. برای وقت تولید یه کلید منحصربفرد توسط کلاینت به پیام اضافه میشه و پیام به بروکر ارسال میشه. هر اتفاقی که این وسط بیفته و پیام داخل بروکر بشینه اما کلاینت متوجه نشه، دفعهی بعد که پیام ارسال میشه اون آیدی داخل سیستم وجود داره و کافکا دیگه اون رو ذخیره نمیکنه (داخل WAL نشسته و کافکا میگه من اینو دارم!). برای وقت مصرف هم همونطور که بالاتر اومد متوجه شدیم که هر پارتیشن رو فقط یه کانسیومر از یک گروه میتونه بخونه و این وسط یه ترنزاکشن شکل میگیره. به هر دلیل اگه افست پیام در نهایت مصرفش کامیت نشه، افست مربوط به پارتیشن برای اون گروه بروز نمیشه و در دور بعدی اون پیام مصرف خواهد شد و چیزی از دست نمیره.
حالا نه اونطور هم. حتی با فرض EOS بودن ماجرا، چندجا هست که ممکنه باعث شه تا پیام یا محاسبهای از دست بره و باید مواظبشون بود.
تا حالا در مورد دو نوع کامیت کردن حرف زدیم. اولی وقتی بود که رهبر میخواست مطمئن شه که یه مسیج بعد از اضافه شدن به WAL ذخیره شده و دومی وقتی بود که گروه مصرفکنندگان پیامی رو پردازش کردن. در مورد اول در واقع اتفاقی که میافتاد این بود که آفست اساسا اونجا خودکار تولید میشد و دیگه هم هیچ وقت تغییر نمیکرد. اما در مورد دوم کامیت کردن (در واقع کامیت کردن یه آفست و نه یه رکورد) هم میشه به صورت اتوماتیک این کار رو انجام داد و هم به صورت دستی.
برای اتوماتیک شدن ماجرا کافیه داخل تنظیمات گروه مقدار enable.auto.commit صحیح باشه. با انتخاب این روش و مشخص کردن مقدار برای auto.commit.interval.ms، عمل کامیت کردن در بازههای منظم x میلیثانیه یکبار انجام میشه. این روش دنگ و فنگ کامیت کردن رو از سر بر میداره ولی میتونه باعث دو شکل مشکل شه. اولی اینه که ممکنه رکوردی پردازش شده باشه ولی قبل از رسیدن زمان کامیت، گروه ترکیده باشه و آفست کامیت نشده باشه. اینجا دوباره اون پردازش انجام میشه. مشکل دوم وقتی به وجود میاد که از همروندی استفاده شه. محاسبات به عهدهی یه ترد دیگه گذاشته میشه اما طول زمان محاسبات از زمان بازه بیشتره. آفست کامیت میشه اما پردازش با شکست روبرو میشه. اینطور بدون پردازش کردن اون رکورد، به عنوان مصرفشده ثبت میشه.
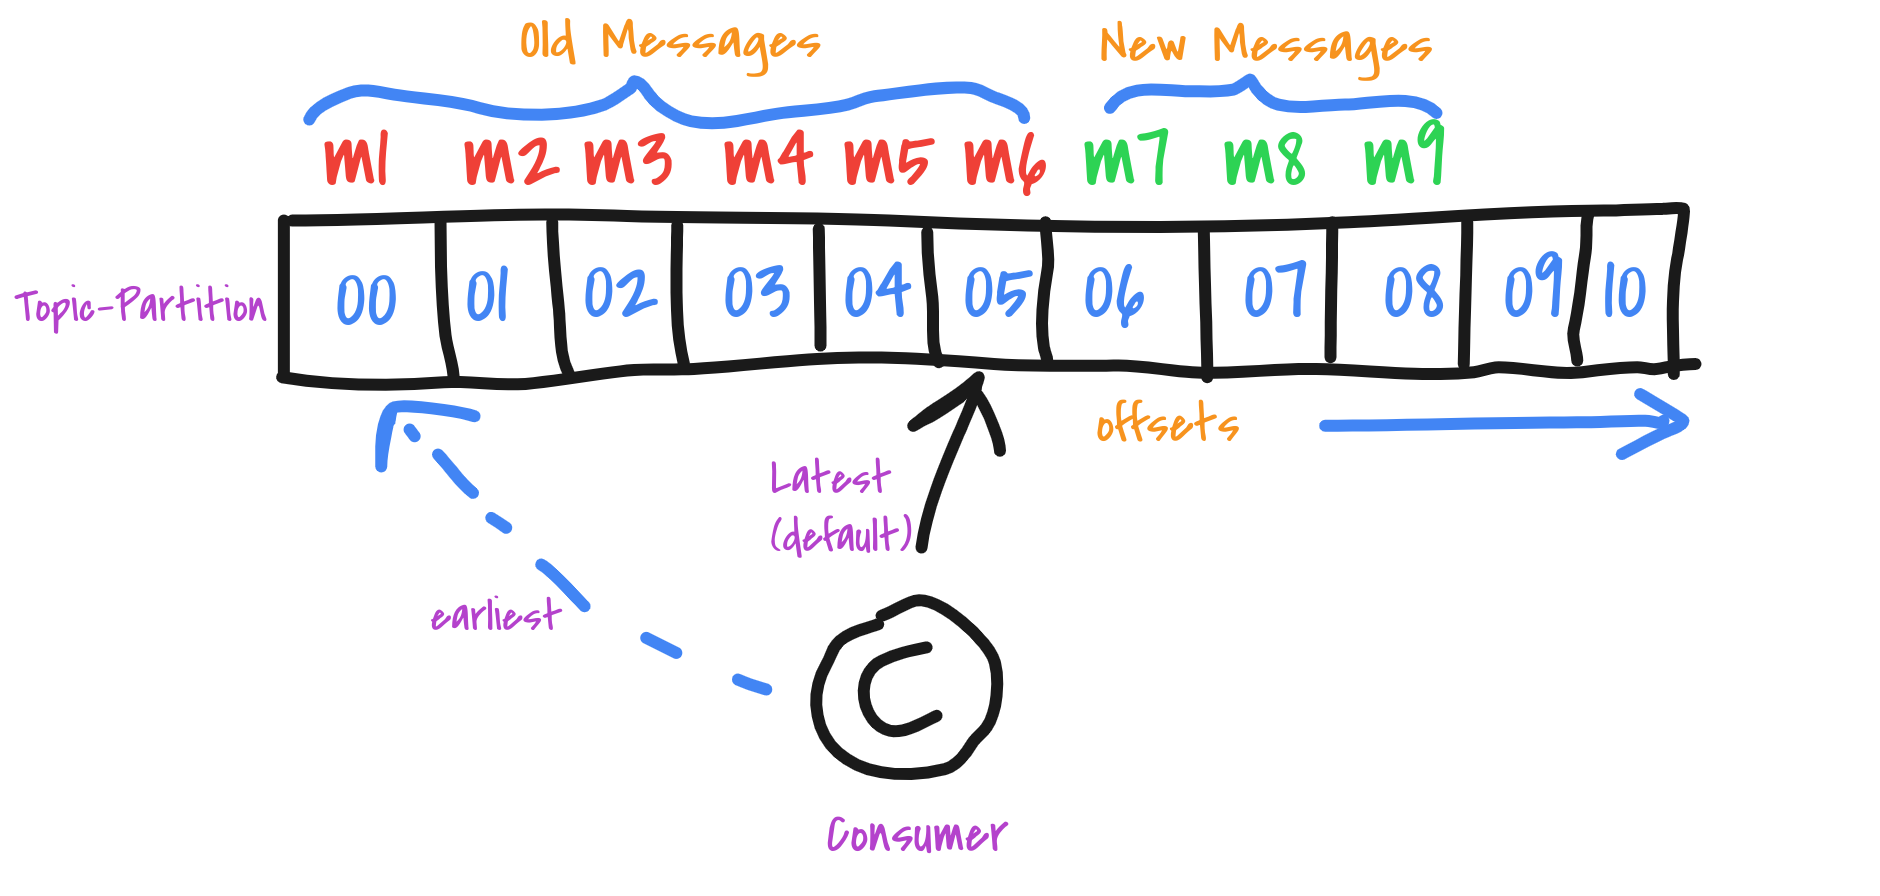
راه دیگه اما کامیت کردن دستی آفست رکوردهاست. این کار به سه شیوه قابل انجامه. اولین روش کامیت کردن متقارن مصرفکنندهست (commitSync). در این حالت بعد از اینکه پردازش تموم شد منتظر میمونیم تا افست کامیت شه و بریم سراغ بعدی و یا در صورت شکست برای کامیت دوباره تلاش کنیم (یکی از مثالهای حالت شکست وقتیه که آفستی با شمارهی بزرگتر قبلا کامیت شده باشه که در این صورت میشه بیخیال کامیت شد). حالت بعدی حالت نامتقارنه (commitAsync). در این حالت منتظر نمیمونیم و به کانسیومر میگیم در پشت پرده این کار رو انجام بده و طبعا تلاشی هم برای شکست نمیتونیم انجام بدیم. حالت سوم کامیت کردن یه آفست خاصه. در این حالت اطلاعات تاپیک و پارتیشن و آفستی که میخوایم کامیت شه رو برای کامیت کردن اعلام میکنیم.
برای فهم بهتر ماجرا میشه از این مخزن استفاده کرد که کافکا رو با گو بازنویسی کردن. سورس خود کافکا رو هم میشه از اینجا یافت که با اسکالا نوشته شده. کد درایور ساراما رو هم میشه از اینجا دید.
در این پست دیدم که یک کلاستر کافکا چطور ساخته شده و پیامها چطور ذخیره میشن. همینطور دیدیم که چطور میشه با استفاده از پیامها محاسبات انجام داد و راههای جلوگیری از دست دادن پیام یا محاسبات چیه.


