
سلام. توی این مقاله می خوام کتابخانه نامپای (Numpy) رو معرفی کنم. توی مقاله قبلی بهتون راجع به اینکه زبان برنامه نویسی پایتون و کتابخانه هاش برای ما مهندس ها مثل یک هدیه می مونه توضیح دادم. لب کلام اون مقاله این بود که ما با کمک پایتون می تونیم با سرعت و بهره وری بیشتری با داده های حجیم (big data) کار کنیم. برای رسیدن به این نتیجه، کتابخانه نامپای پای ثابت کار ماست.
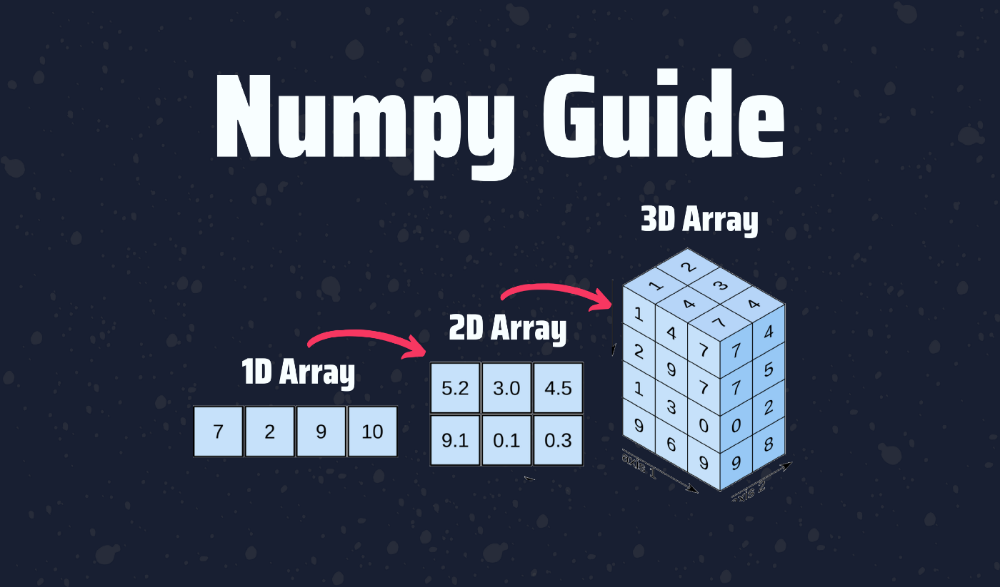
اولین شگفتی نامپای اشیایی هستند به اسم ndarray؛ یا همون آرایه های نامپای که ممکنه قبلا شنیده باشید. به کمک نامپای می تونیم اشیایی بسازیم که در واقع آرایه هایی چندبعدی از داده ها هستند. یه چیزی شبیه ماتریس ها یا تانسورها. (یادش بخیر مقاومت مصالح و تانسور تنش ) البته شاید پیش خودتون بگید اینکه چیز مهمی نیست. ما خودمون لیست و تاپل مذگان داریم که کلی هم باهاش آرایه های چند بعدی و تو در تو ساختیم! من این حرف شما رو رد نمی کنم. در حالت عادی و برای ذخیره کردن تعداد کمی داده و اعمال عملیات های جزئی روی اون، خودم هم از لیست و مشابه اون (iterable objects) استفاده می کنم. اما اگر حجم داده ها بالا بره چی؟ اگر سرعت محاسبات مهم باشه چی؟
کتابخانه نامپای علاوه بر فراهم کردن آرایه ها، یک سری عملگرها و متدهایی برای عملیات ها و محاسبات سریع روی آرایه ها در اختیار میذاره. عملیات هایی نظیر: محاسبات ریاضی، منطقی، تغییر توزیع وشکل داده ها، مرتب سازی داده، کار با تبدیل فوریه، جبر خطی، آمار و احتمال، ساخت توزیع داده ها و ایجاد انواع داده های رندم و نمایش اون ها.
در واقع ndarray یه کلاس داخل کتابخانه نامپای هست که شامل خواص و متدهای مشخصیه و اشیای آرایه ای از همین کلاس الگو می گیرند و ساخته می شوند.
حالا که یه معرفی اجمالی از نامپای داشتیم (که امیدوارم شما رو تا اینجای متن شارژ نگه داشته باشه) بریم ریزتر تفاوت آرایه های نامپای رو با آرایه های استاندارد پایتون بررسی کنیم:
البته با ذکر مثال درک این موارد بالا راحت تره برامون. این مثال رو از سایت خود نامپای کش رفتم:
اگر دوتا لیست از اعداد داشته باشیم و بخوایم درایه های متناظر رو با هم ضرب کنیم و داخل یه لیست جدید بریزیم، با روش های استاندارد پایتون احتمالا یه کدی داریم مثل این:
c = [] for i in range(len(a)): c.append(a[i]*b[i])
که اگر این دوتا لیست یه میلیون درایه داشته باشند، لوپ زدن خیلی از ما هزینه محاسباتی میگیره. خوب تو دلتون می گید:"چه کاریه؟ میرم با C می نویسم که سریع تره!" هر جو راحتی. اینم از کد همین مساله با سینتکس C(که البته خلاصش کردم):
for (i = 0; i < rows; i++): {
       c[i] = a[i]*b[i];
}
البته ما با C شاید هزینه های محاسباتی رو کاهش دادیم، اما خودمون رو از مزایای کدنویسی با پایتون محروم کردیم. بگذریم؛ اگر آرایه های ورودی ما 2 بعدی بودن چی؟ باید کدمون رو اینطوری گسترش بدیم:
for (i = 0; i < rows; i++): {
        for (j = 0; j < columns; j++): {
               c[i][j] = a[i][j]*b[i][j];
         }
}
خب هر چی مثال جانبی زدم بسه دیگه، بریم سر اصل مطلب؛ خانم ها و آقایان، این شما و اینم کد معادل این مسأله به کمک نامپای:
c = a * b
الان توضیحی می مونه؟ نه انصافا میخوای دیگه چی از جیب من درآد؟ با این عملگر ما فارغ از shape آرایه ها، درایه های متناظر رو ضرب می کنیم و ازش یه آرایه جدید می سازیم.
همه این توضیحات یعنی الهه نامپای هم سرعت C رو داره و هم جذابیت پایتون.
حالا اصلا چرا اینقدر نامپای سریعه؟ چون:
یه بردار با درایه هاش توصیف میشه. وقتی بردار رو با زوایای فضایی و طول بردار توصیف می کنیم، کارمون خیلی سخت تر از وقتیه که اون رو با بردارهای یکه معرفی می کنیم. در واقع دلیل اینکه ما خیلی صریح هیچ حلقه تکرار یا ایندکس گذاری و امثالهم رو توی محاسبات نامپای نمی بینیم دلیلش همین برداری کردن داده هاست. (البته ضمن اجرای کد، لوپ و اینا هست که ما درگیرش نیستیم و اصن به ما چه!) خلاصه که مزایای برداری سازی از این قراره:
منظورم از قابلیت توزیعی (ترجمه بهتری داشتید پیشنهاد بدید لطفا) اینه که عملگرها به صورت ضمنی رفتار درایه به درایه دارن. مثلا توی مساله بالا، کد ما کار نداشت که ابعاد a و b چقدره! اون ها رو یه سری درایه می دید که قرار دو به دو ضرب بشن.
راستی شما ترغیب شدید نامپای رو پایتون یاد بگیرید؟ خیلی خوب میشه برای بهتر شدن کارم نظر شما رو داشته باشم.


