
سلام مجدد خدمت همه همراهان نگاره. امیدوارم حالتون خیلی خیلی خوب باشه.
طبق برنامه ریزی که کردیم قرار هست جزییات فنی اکثر کارایی که تو نگاره انجام میدیم رو توی چند تا پست آموزشی منتشر کنیم.
بدون مقدمه میرم سر اصل مطلب. همه میدونیم که یه روش بدیهی برای جستجو بین اسناد، نگاه کردن به تک تک اون اسناد هست تا زمانی که سند مورد نظرمون رو پیدا کنیم. این روش به ظاهر روش خوبیه ولی اصلا بهینه نیست و با افزایش تعداد اسناد، زمان صرف شده برای پیدا کردن سند مورد نظر هم افزایش پیدا میکنه.
یه بحثی توی علوم کامپیوتر وجود داره به اسم پیچیدگی زمانی که میگه:
چه مقدار زمان نیاز هست تا یه الگوریتمی برای ورودی به اندازه n اجرا شود.
یعنی اگر بخوایم یه الگوریتمی رو روی یه مجموعه به طول n اجرا کنیم، چقدر طول میکشه تا به جواب برسیم. این زمان واحد خاصی نداره و تابعی بر حسب n (ورودی) است.
مثلا برای پیدا کردن یک عدد در لیستی از اعداد به تعداد n، نیاز هست که عدد مورد نظر با تک تک اعداد موجود در لیست مقایسه بشه. حالا ۳ تا حالت پیش میاد:
حالت اول به عنوان بهترین حالت، حالت دوم به عنوان بدترین حالت، و میانگین تمام حالتهای سوم به عنوان حالت میانگین در نظر گرفته میشه. معمولا بدترین حالت به عنوان معیار برای مقایسه الگوریتمها استفاده میشه و با حرف انگلیسی O بزرگ نشون داده میشه. مثلا الگوریم جستجوی بالا از مرتبه (O(n است یعنی اگر اندازه ورودی n باشه، در بدترین حالت، باید n تا کار انجام بدیم تا عدد مورد نظر رو پیدا کنیم.
حالا چرا این بحثو مطرح کردیم؟ به خاطر اینکه دقیقا همین مشکل بالا رو توی مباحث جستجو داریم. یعنی اگه بخوایم عبارتی خاصی رو توی اسناد جستجو کنیم باید همه اسناد رو دونه دونه بررسی کنیم که کار بسیار هزینهبری هست (از نظر زمان و منابع سیستمی). پس باید دنبال یه راه حل بهتر باشیم یعنی باید اسناد رو به شکلی ذخیره کنیم که فرایند جستجو توی آونها خیلی خیلی آسونتر و سریعتر باشه.
قبل از اینکه خیلی جزیی تر وارد قضیه بشیم اینو بگم که هدف اصلی نمایه سازی، ذخیره اطلاعات بصورتیه که برای جستجو بهینه باشه. بدون نمایه سازی برای پیدا کردن عبارت مورد نظرمون احتمالا مجبوریم همه اسناد رو بگردیم که اصلا بهینه نیست، منابع زیادی مصرف میکنه و زمان خیلی زیادی طول میکشه. همه اینها نهایتا روی تجربه کاربری تاثیر بسیار بدی میذاره و نارضایتیه کاربرا رو بالا میبره. پس نمایه سازی درست یکی از اصلیترین مباحث تو موتورهای جستجو هست.
اصلیترین قسمت نمایه سازی ایجاد یک ساختار داده ای است که هر کلمه را به لیستی از اسناد شامل آن کلمه نگاشت میکنه (یعنی یه کلمه به عنوان ورودی میگیره و یه لیستی از اسنادی که شامل اون کلمه هست رو برمیگردونه). اصطلاحا به این کار نمایه معکوس (Inverted Index) میگن. یعنی بجای اینکه اسنادی داشته باشیم که شامل کلمات هستن، کلماتی داریم که شامل اسناد هستن.
حالا میخوایم. این اسناد رو نمایه سازی کنیم. برای نمایه سازی باید یه مرحله پیشپردازش روی اسناد انجام بدیم تا آماده نمایهسازی بشن. این مراحل عبارتند از:
بعد از اینکه پیشپردازش انجام شد، اسناد آماده نمایهسازی هستن. مراحلی که برای نمایهسازی باید طی بشه بصورت زیر هست:
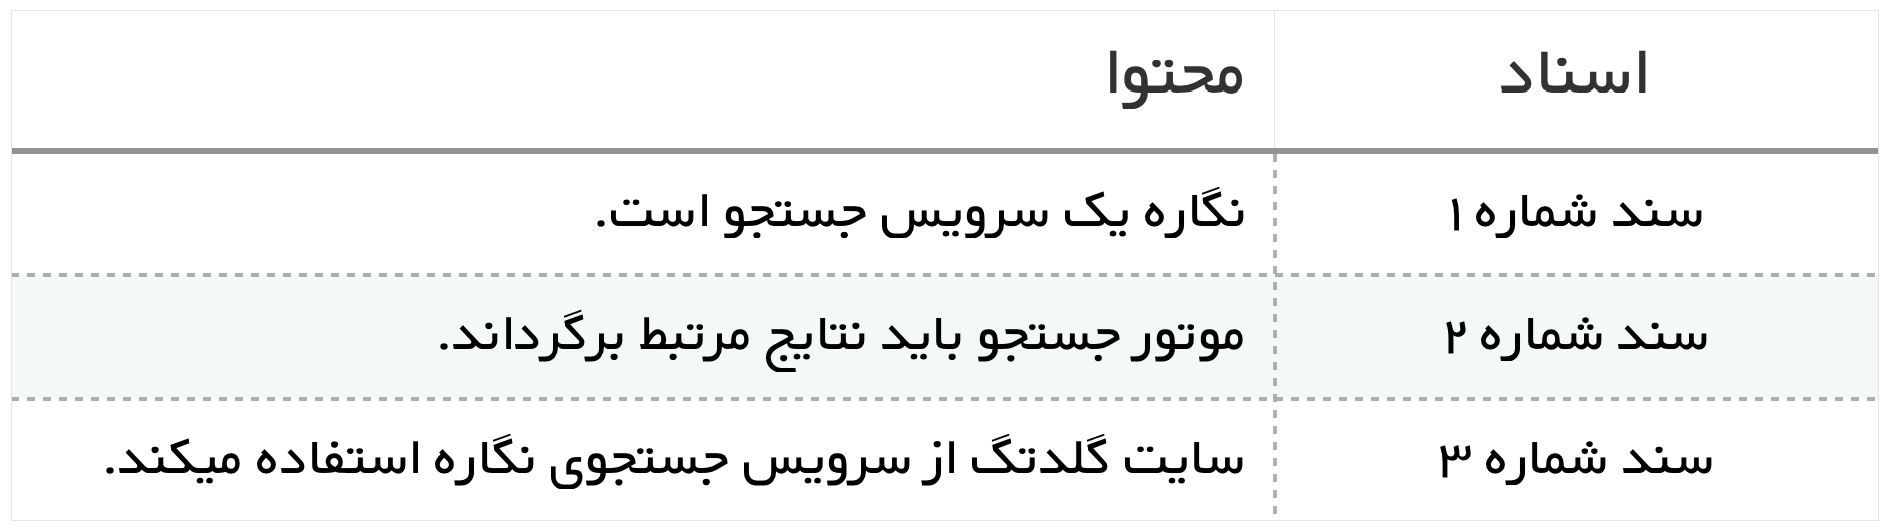
مثلا فرض کنید ۳ تا سند داریم که محتوای هرکدوم بصورت زیر هست:
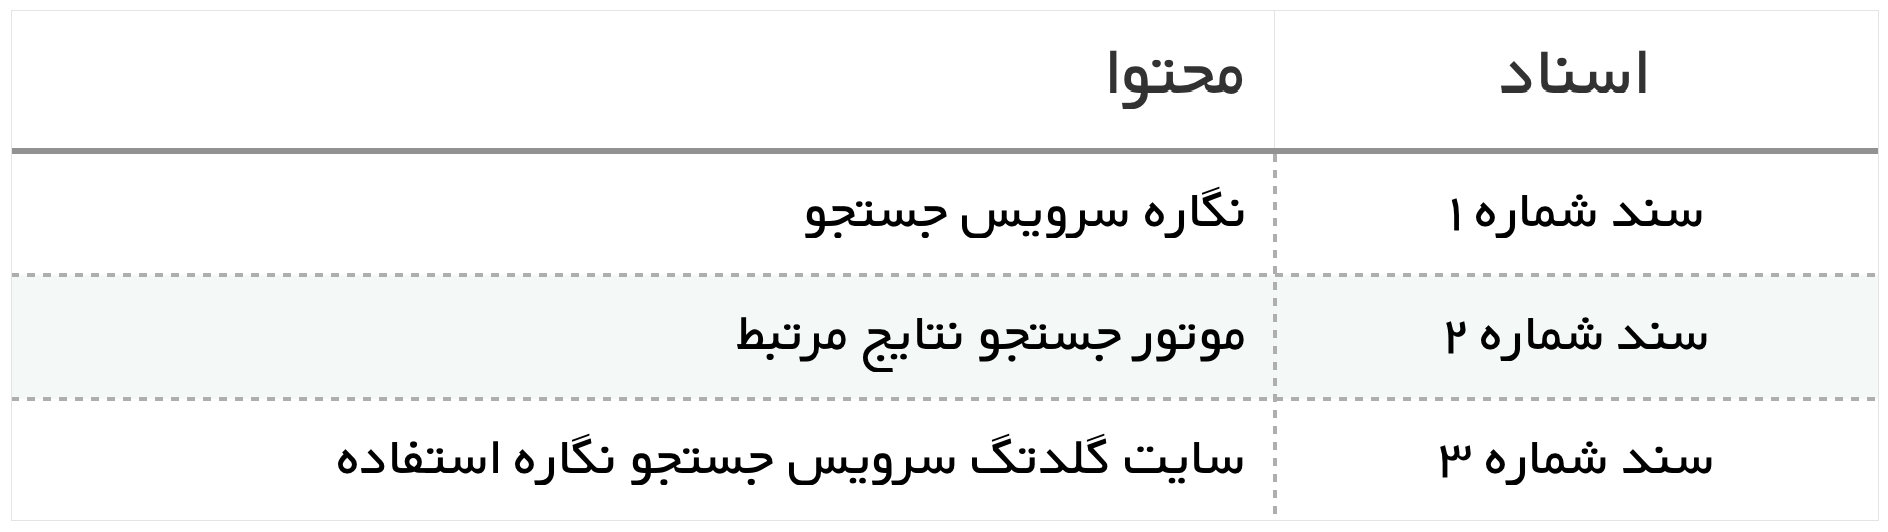
بعد از اعمال مراحل پیشپردازش بر روی این اسناد خروجی بصورت زیر خواهد بود:
و پس از نمایهسازی یه جدول بصورت زیر خواهیم داشت که نشون میده هر کلمه توچه سندی وجود داره:
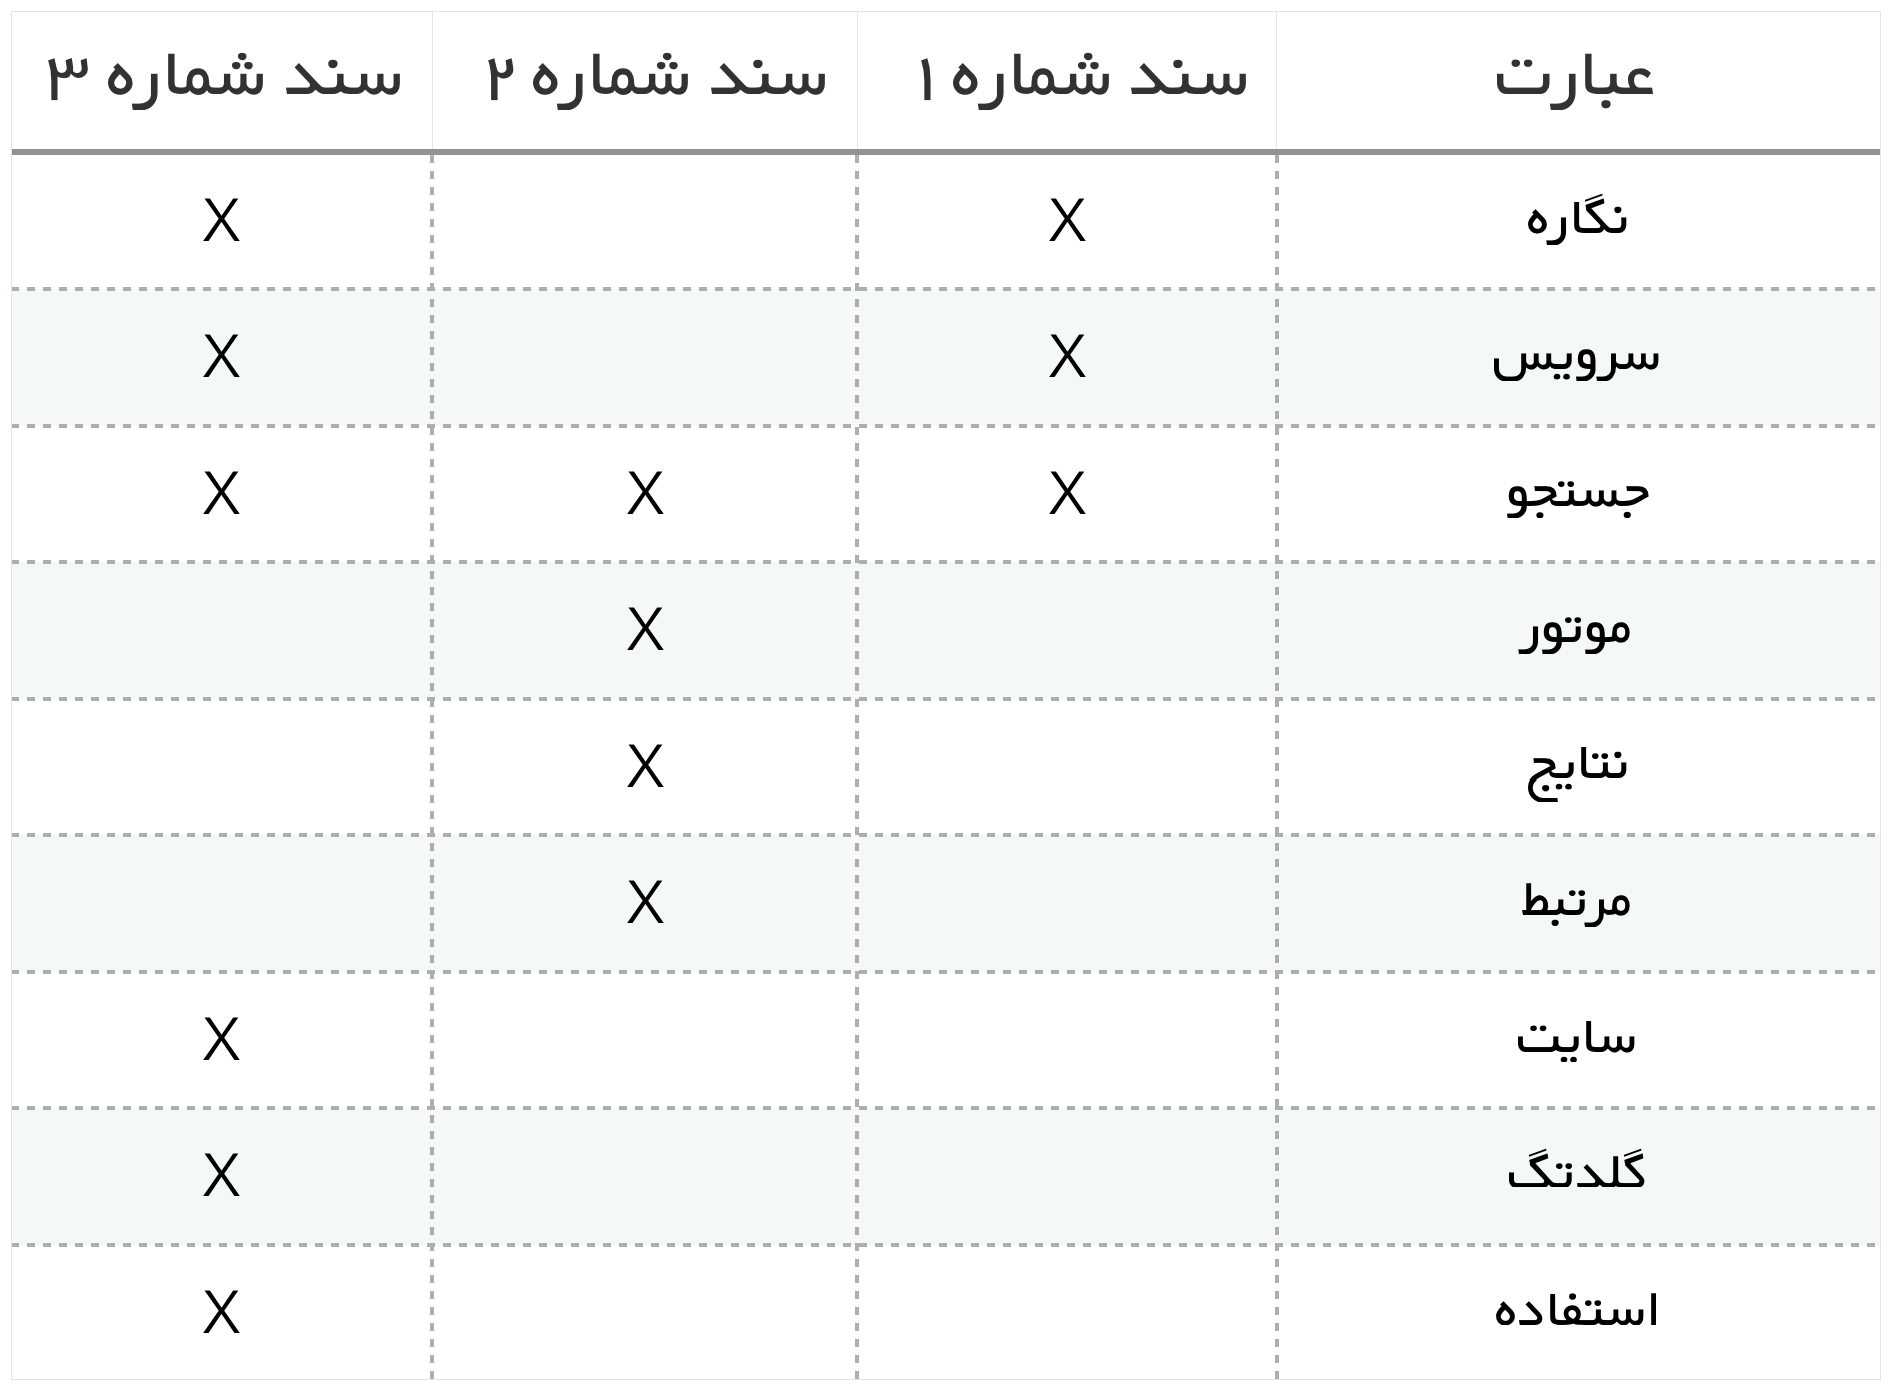
برای مثال کلمه نگاره تو اسند شماره ۱ و ۳ وجود داره. نکته مهم و قابل توجه اینه که برای پیدا کردن عبارت موردنظر کافیه تعداد خیلی کمی از اسناد رو مورد بررسی قرار بدم مثلا برای پیدا کردن کلمه نگاره فقط کافیه ۲ تا سند رو بررسی کنم (الان اختلاف. زیادی نداره ولی در عمل واقعا باعث میشه اسناد خیلی کمی رو بررسی کنم?). با این کار پیچیدگی زمانی به مقدار خیلی زیادی کاهش پیدا میکنه و مستقل از تعداد اسناد میشه. این. باعث میشه مصرف منابع به مقدار چشمگیری کاهش پیدا کنه و مقیاس پذیری سیستم هم افزایش چیمگیری داشته باشه.
الگوریتمهای زیادی برای ذخیره این نوع نمایه های معکوس بصورت بهینه وجود دارد. اکثر این روشها بصورت کامل در کتاب Managing Gigabytes توضیح داده شده.
معمولا از جدول درهمسازیشده (Hash Table) برای ذخیره این نمایههای معکوس استفاده میشود.
تا اینجا با روش ساخت و ذخیرهسازی نمایه معکوس آشنا شدیم. در ادامه با نحوه پیاده سازی چند روش نمایهسازی آشنا میشیم.
این روش یکی از پرکاربردترین روشها برای نمایهسازی است که با استفاده از Tire (نوعی درخت که در آن نود هایی که پدر یکسان دارن قسمتی از متن آندو نیز مشترک است) پیاده سازی میشن.
مزیتهای این روش:
عیبهای این روش:
این روش اگرچه سرعت و مقیاس پذیری بالایی داره، به دلیل محدودیتهاش تاثیر بسیار بدی توی تجربه کاربری خواهد داشت.
این روش برای ساخت نمایه معکوس علاوه بر کلمات، از ساختار پیشرو کلمات نیز استفاده میکنه (مثلا علاوه بر کلمه "کتاب" از عبارات "ک"، "کت"، "کتا" نیز استفاده میکنه). معمولا از دو نمایه معکوس یکی برای کلمات و دیگری برای پیشرو کلمات استفاده میشود که اولویت با نمایه معکوس کلمات است.
مزیتهای این روش:
عیبهای این روش:
این روش هم با توجه به اینکه سرعت پاسخگویی بالایی داره، فضای ذخیره سازی زیادی نیاز داره که مقیاس پذیری سیستم رو بشدت تحت تاثیر قرار میده.
بصورت مشابه نمایه سازی پسرو هم به همین شکل کار میکنه ولی از آخر عبارات رو میسازه.
این روش خیلی شبیه به روش نمایه سازی پیشرو است با این تفاوت که طول کلمات پیشرو نمیتواند از یه حداقل و حداکثری تجاوز کنه. بزرگترین مزیت این روش کاهش هزینه زمانی و حافظه مصرفی است. مثلا کلمه "پیراهن" بصورت عبارات "پیر"، "یرا"، "راه"، "اهن"، نمایهسازی میشود (که در آن حداقل و حداکثر طول عبارات ۳ است).
مزایا و معایب این روش نیز همانند نمایهسازی پیشرو است و تنها یک بهبود جزئی در هزینه زمانی و فضای مصرفی داره.
این روش فرایند نمایهسازی را تنها با ذخیره لیست درهمسازی شده برای کلمات و اسناد بسیار ساده میکنه. محاسبه عبارات پیشرو به زمان درخواست جستجو موکول میشه. یعنی هروقت جستجویی انجام شد، عبارات پیشرو محاسبه میشه و جستجو بر اساس اونها انجام میشه.
مزیتهای این روش:
عیبهای این روش:
امیدوارم تا اینجای مطلب مفید بوده باشه براتون. در قسمت های بعد درمورد جزییات بیشتر اتفاقاتی که توی نگاره میوفته صحبت میکنیم.
شاد و پیروز باشید...


