
نرم افزار Fluentd یک ابزار مبتنی بر فضای ابری open-source و کاملا رایگان برای جمع آوری لاگ است که کاربر را قادر می سازد معماری سازگار Log All Everything را با سیستم های خیلی زیادی را داشته باشد. این ابزار به زبان C نوشته شده است و روی تمام سیستم عامل ها از جمله ویندوز و لینوکس اجرا می شود و تحت لیسانس Apache 2.0 است. همچنین می توان از قالب JSON برای ساختار دادن به داده استفاده می کند. از جمله مزایای آن می توان به کم حجم بودن آن و انعطاف پذیر بودن آن در تعداد کاربران استفاده کننده از آن اشاره کرد.
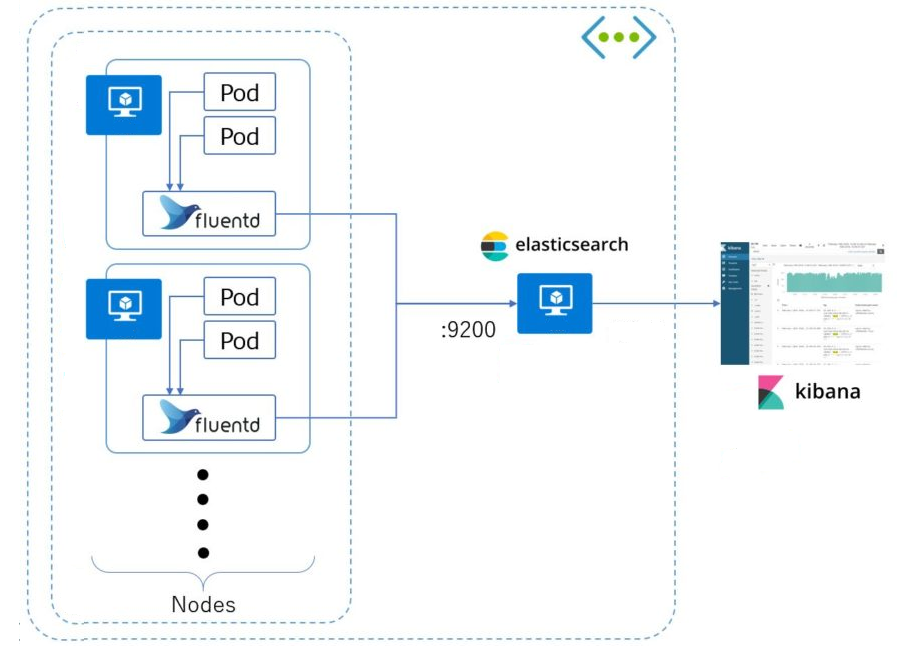
در کلاستر کوبرنتیز لاگ های stdout و stderr پادها در نودهای کلاستر در مسیر .../var/log/containers/ جمع آوری می شوند و می توان با کانفیگ کردن fluentd برای جمع آوری و ارسال آن ها, لاگ های پادها را در الستیک داشت. معماری fluentd به گونه می باشد که در هر node یک fluentd به صورت daemon set با اسم forwarder لاگ ها را از پوشه لاگ جمع آوری می کند و به سمت یک fluentd به اسم aggregator می فرستد که این aggregator لاگ ها را به سمت elasticsearch می فرستد.
برای نصب و کانفیگ fluentd از helm chart آن استفاده می کنیم که می توان از آدرس github.com/bitnami/charts/tree/master/bitnami/fluentd دانلود کرد.
برای ارسال لاگ باید قسمت configMapFiles در forwarder و aggregator کانفیگ شوند که در زیر اورده شده است:
configMapFiles: fluentd.conf: | # Ignore fluentd own events <match fluent.**> @type null </match> @include fluentd-inputs.conf @include fluentd-output.conf {{- if .Values.metrics.enabled }} @include metrics.conf {{- end }} fluentd-inputs.conf: | # HTTP input for the liveness and readiness probes <source> @type http port 9880 </source> # Get the logs from the containers running in the node <source> @type tail path /var/log/containers/*.log pos_file /opt/bitnami/fluentd/logs/buffers/fluentd-docker.pos exclude_path /var/log/containers/*fluentd*.log tag kubernetes.* time_key @timestamp time_format %Y-%m-%dT%T.%L%Z read_from_head true <parse> @type json </parse> </source> <filter kubernetes.**> @type parser key_name "$.log" hash_value_field "log" reserve_data true <parse> @type json </parse> emit_invalid_record_to_error </filter> # enrich with kubernetes metadata <filter kubernetes.**> @type kubernetes_metadata </filter> <match kubernetes.**> @type rewrite_tag_filter <rule> key $.kubernetes.labels.app_kubernetes_io/name pattern ^(.+)$ tag $1 </rule> </match> fluentd-output.conf: | # Throw the healthcheck to the standard output instead of forwarding it <match fluentd.healthcheck> @type stdout </match> # Forward all logs to the aggregators <match **> @type forward <server> host fluentd-0.fluentd-headless.logs.svc.cluster.local port 24224 </server> <buffer tag,time> @type file timekey 30s flush_mode interval total_limit_size 20GB path /opt/bitnami/fluentd/logs/buffers/logs.buffer_${tag}_${chunk_id} retry_forever true retry_type exponential_backoff retry_exponential_backoff_base 2 retry_max_interval 1h flush_thread_count 2 flush_interval 5s </buffer> </match> metrics.conf: | # Prometheus Exporter Plugin # input plugin that exports metrics <source> @type prometheus port {{ .Values.metrics.service.port }} </source> # input plugin that collects metrics from MonitorAgent <source> @type prometheus_monitor <labels> host ${hostname} </labels> </source> # input plugin that collects metrics for output plugin <source> @type prometheus_output_monitor <labels> host ${hostname} </labels> </source> # input plugin that collects metrics for in_tail plugin <source> @type prometheus_tail_monitor <labels> host ${hostname} </labels> </source> <filter **> @type prometheus <metric> name fluentd_input_status_num_records_total type counter desc The total number of incoming records <labels> tag ${tag} hostname ${hostname} </labels> </metric> </filter>
حال در زیر به تعیین جز به جز کانفیگ فوق می پردازیم:
      <source>
        @type tail
        path /var/log/containers/*.log
        pos_file /opt/bitnami/fluentd/logs/buffers/fluentd-docker.pos
        exclude_path /var/log/containers/*fluentd*.log
        tag kubernetes.*
        time_key @timestamp
        time_format %Y-%m-%dT%T.%L%Z
        read_from_head true
        <parse>
          @type json
        </parse>
      </source>
مشخص می کند نوع منبع لاگ به چه صورتی باشد که tail یعنی به از یک فایل لاگ ها را بخواند.
مسیر فایل لاگ را به fluentd می دهد.
مسیری را مشخص می کند که در آن تعیین می شود لاگ فایل تا چه سطری فرستاده شده است و از کجا باید ارسال لاگ ادامه پیدا کند.
مسیر فایل هایی که نباید ارسال شوند را معین می کند.
به لاگ های ارسالی یک tag اضافه می کند که از آن برای تفکیک لاگ ها در ارسال به جاهای مختلف استفاده می شود (به صورت پیش فرض اسم فایل به عنوان tag انتخاب می شود و در این کانفیگ .kubernetes به اول tag اضافه می شود)
اسم فیلد زمان را در لاگ ها را مشخص می کند.
فرمت مقدار فیلد زمان را مشخص می کند.
در زمان tail کردن فقط لاگ های جدیدی که اضافه شده اند ارسال می شوند ولی در با true کردن این مقدار شروع به tail کردن از اول فایل می کند.
این قسمت که در pars قرار داد نوع لاگ های موجود در فایل لاگ را تعیین می کند.
      <filter kubernetes.**>
        @type parser
        key_name "$.log"
        hash_value_field "log"
        reserve_data true
        <parse>
          @type json
        </parse>
         emit_invalid_record_to_error
      </filter>
تنظیمات فوق برای تعیین نوع لاگ یک فیلد خاص می باشد. در parser پیشین ما فرمت کلی لاگ ارسال شده را مشخص کردیم ولی در اینجا فرمت یک فیلد خاص را مشخص می کنیم فیلد log فیلدی می باشد که اطلاع نوشته شده در فایل لاگ را در بردارد که در بالا مشخص شده است که این فیلد به صورت json هستند و لاگ های غیر josn دور ریخته می شوند.(پارامتر emit_invalid_record_to_error این لاگ ها به صورت error در ارسال می کند)
      <match kubernetes.**>
        @type rewrite_tag_filter
        <rule>
          key $.kubernetes.labels.app_kubernetes_io/name
          pattern ^(.+)$
          tag $1
        </rule>
      </match>
حال در این قسمت با استفاده از افزونه rewrite_tag_filter تگ لاگ ها را عوض کرده و بر اساس اسم برنامه قرار می دهیم ( می توان به جای kubernetes.labels.app_kubernetes_io/name.$ که یک فیلد از لاگ های ارسالی هست از متغییر های دیگری نیز استفاده کرد)
<match **>
        @type forward
        <server>
          host fluentd-0.fluentd-headless.logs.svc.cluster.local
          port 24224
        </server>
        <buffer tag,time>
          @type file
          timekey 30s
          flush_mode interval
          total_limit_size 20GB
          path /opt/bitnami/fluentd/logs/buffers/logs.buffer_${tag}_${chunk_id}
          retry_forever true
          retry_type exponential_backoff
          retry_exponential_backoff_base 2
          retry_max_interval 1h
          flush_thread_count 2
          flush_interval 5s
        </buffer>
      </match>
در تنظیمات این قسمت لاگ ها از forwarder به سمت aggregator ارسال می کنیم.
آدرس سرویس aggregator می باشد.
شماره port سرویس aggregator می باشد.
قسمت buffer برای جلوگیری از حذف شدن لاگ ها و هم افزایش performance با کاهش دفعات اتصال به aggregator می باشد. برای بافر کردن fluentd شروع به جمع کردن لاگ ها درون chunk file می کند که در این تنظیمات مشخص شده فایل ها بر اساس زمان و tag لاگ ها ایجاد شوند.
نوع chunk ها مشخص می کند.
این قسمت تعیین می کند که فایل های جدید chunk با چه interval ایجاد شوند
فلاش یعنی زمانی که این chunk ها به سمت aggregator فرستاده می شوند و در این کانفیگ بر اساس interval عملیات فلاش صورت می گیرد.
حداکثر حجم بافر را تعیین می کند.
محل ذخیره سازی chunk ها می باشد.
برای ارسال chunk مشخص می کند که بعد از به خطا خوردن تا ابد تلاش کند یا خیر.
نوع افزایش زمان انتظار بعد از هر تلاش ناموفق را مشخص می کند که در این قسمت به صورت نمایی انتخاب شده است.
عدد پایه نمودار نمایی برای افزایش زمان انتظار می باشد در این تنظیمات ۲ قرار داده شده است.
حداکثر زمان انتظار را معیین می کند که در اینجا بیشتر از ۱ ساعت نمی شود.
تعداد فلاش های موازی را معین می کند.
مدت زمان بین هر فلاش را تعیین می کند.
      <source>
        @type prometheus
        port {{ .Values.metrics.service.port }}
      </source>
      # input plugin that collects metrics from MonitorAgent
      <source>
        @type prometheus_monitor
        <labels>
          host ${hostname}
        </labels>
      </source>
      # input plugin that collects metrics for output plugin
      <source>
        @type prometheus_output_monitor
        <labels>
          host ${hostname}
        </labels>
      </source>
      # input plugin that collects metrics for in_tail plugin
      <source>
        @type prometheus_tail_monitor
        <labels>
          host ${hostname}
        </labels>
      </source>
      <filter **>
        @type prometheus
        <metric>
          name fluentd_input_status_num_records_total
          type counter
          desc The total number of incoming records
          <labels>
            tag ${tag}
            hostname ${hostname}
          </labels>
        </metric>
      </filter>
در تنظیمات این بخش متریک های مورد نیاز برای مانیتورینگ مقدار ورودی خروجی و بافر و ... fluentd استفاده می شود
این مقدار برای تعیین برچسب های متریک ها برای جدا سازی آن ها می باشد. (به عنوان مثال با تعیین tag به عنوان برچسب می توان فهمید هر برنامه چه تعداد لاگ ورودی دارد)
در بخش دوم کانفیگ aggregator مورد بررسی قرار می گیرد.


