
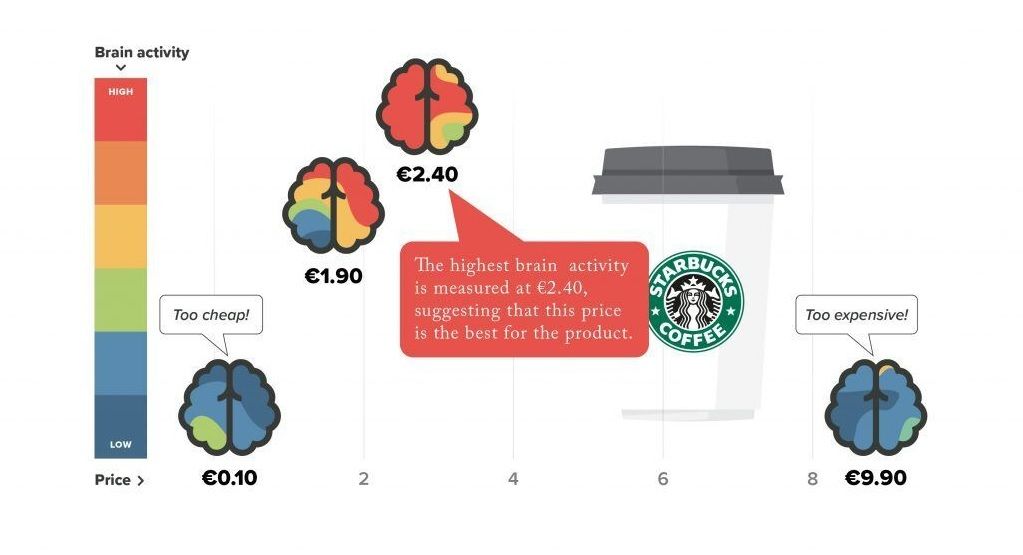
هوشمصنوعی امروزه در بیشتر صنایع و حوزهها واردشده و پیشرفتی عظیم و قابلتوجه را در ارتقای آنها سبب شدهاست. از جمله حوزههای موردتوجه سرمایهداران و فروشندگان بزرگ، بازاریابی است. هوشمصنوعی به بازاریابی در جستجوی کالا و ارزیابی محبوبیت کالا به فروشنده و مشتری خدمت میکند.
در این مقاله ابتدا به تعریف مفاهیمی مانند نورومارکتینگ،تئوری ناقرینگی پیشانی، ماشینلرنینگ و روشهای آن پرداخته و سپس ارتباط هوشمصنوعی با نورومارکتینگ و بازاریابی را بررسی میکنیم:
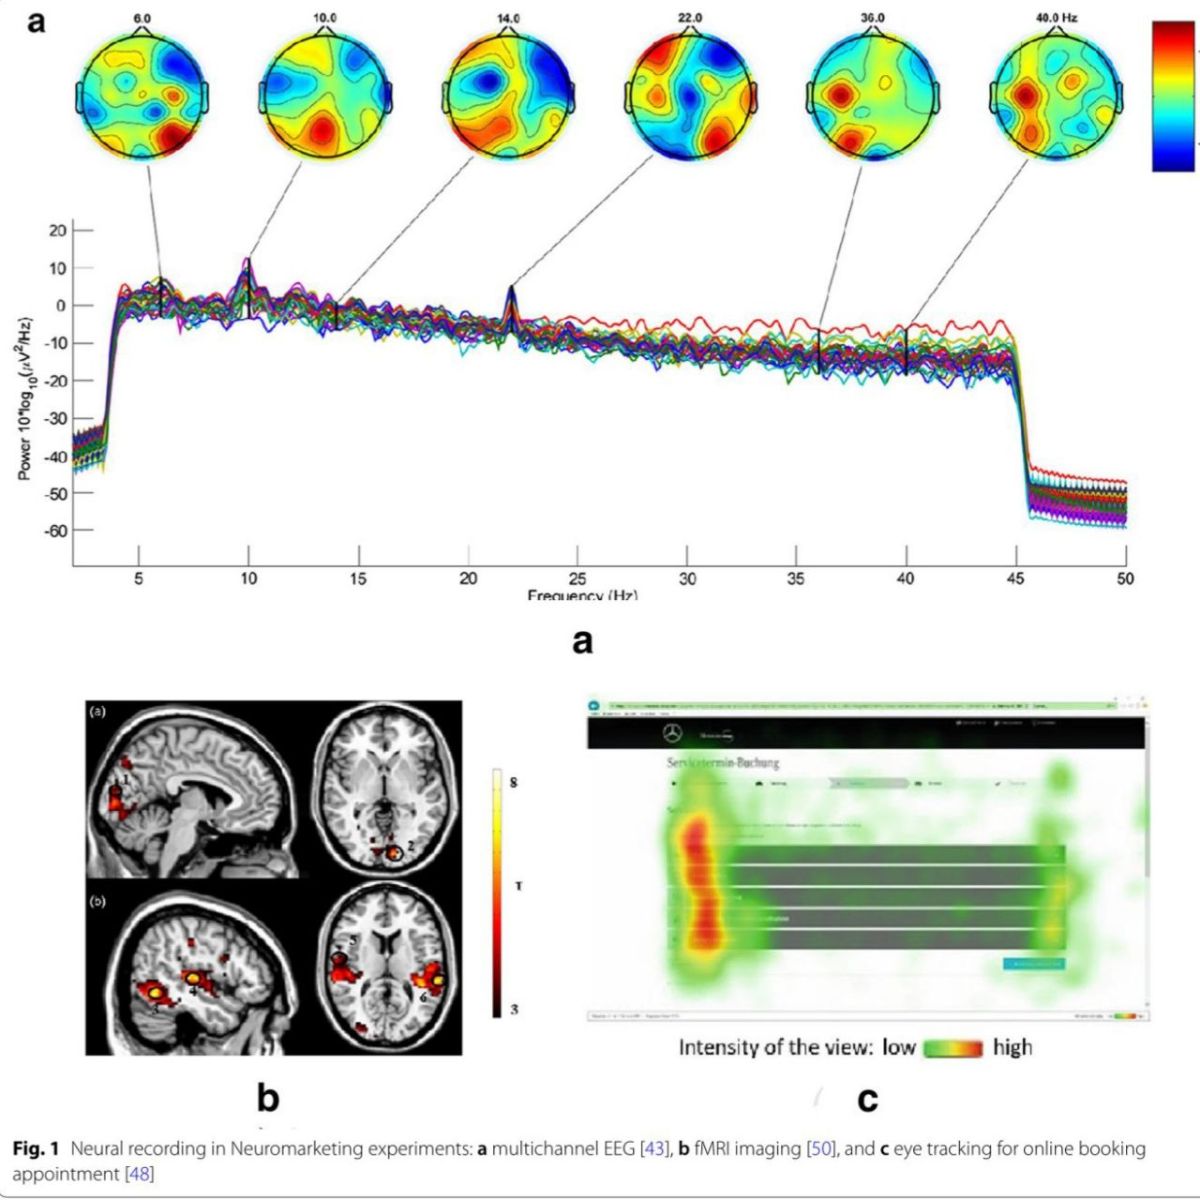
از روشهای رایج در نورومارکتینگ میتوان به اسکن مغز و ردیابی حرکات چشمان اشاره کرد که به ترتیب به
فعالیت عصبی و فیزیولوژیکی انسان مربوط میشوند.
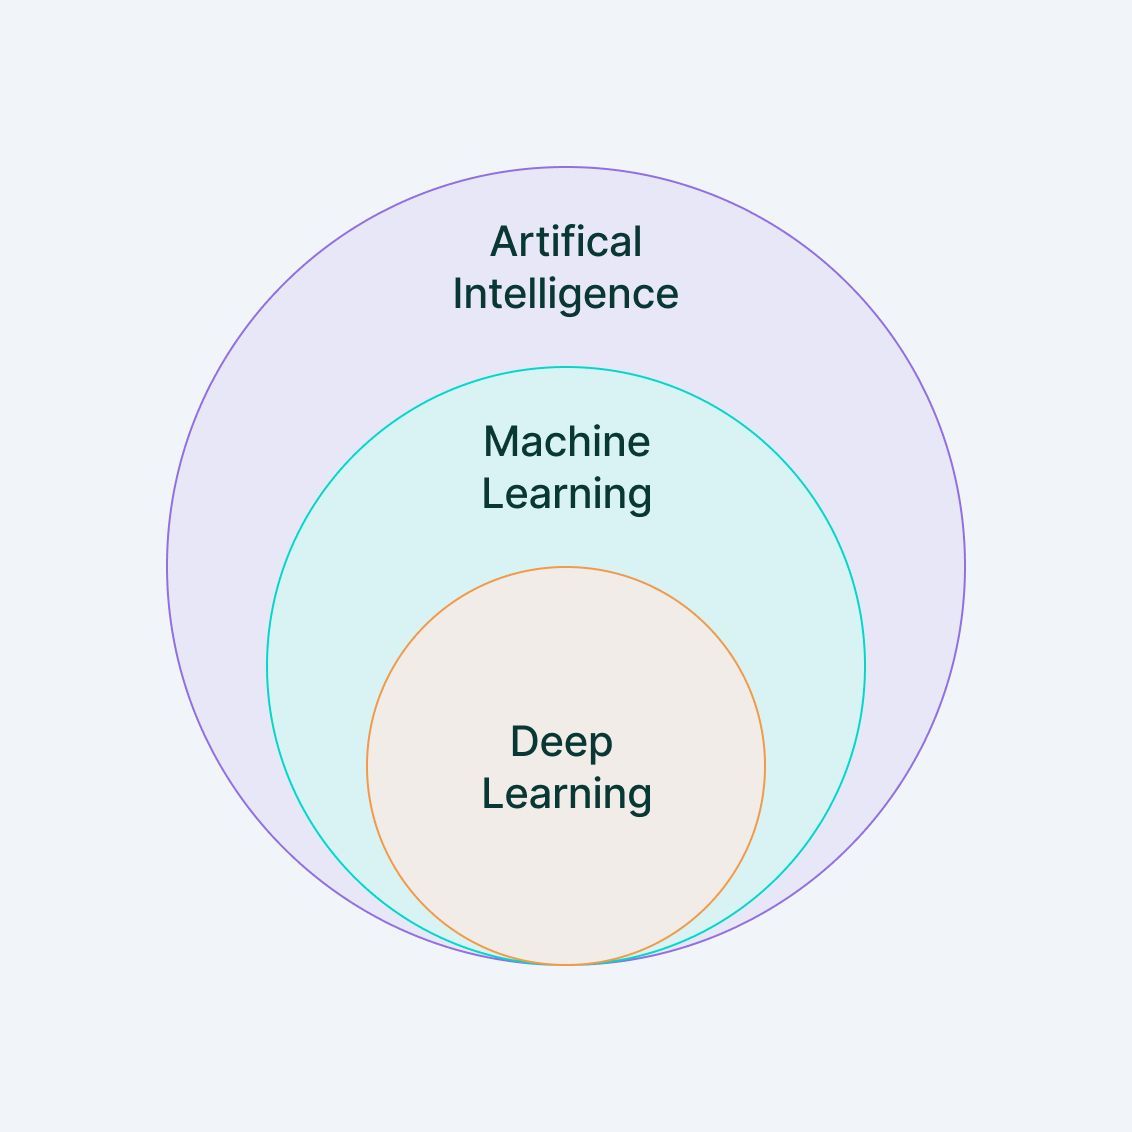
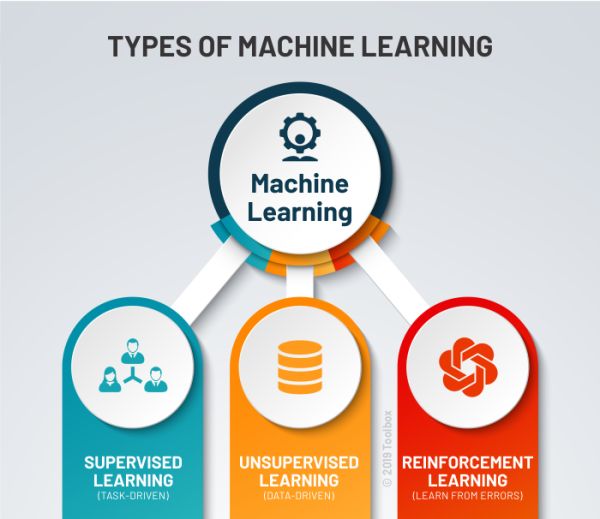
روشهای ماشینلرنینگ به سه روش 《یادگیری تحت نظارت》، 《یادگیری بدون نظارت》 و 《یادگیری
تقویتشده》 تقسیم میشوند که از این میان، دو روش اول رایجتر اند:
? یادگیری تحتنظارت: در اینروش دادهای برچسبگذاری شده به عنوان دادهی تمرینی به ماشین داده
میشود تا با استفاده از یک الگوی مشخص بتواند برچسب مناسب دادههای بعدی را با توجه به داده تمرینی
پیشبینی کند.
? یادگیری بدوننظارت: در این روش دادههای موردنظر، بدون برچسب به ماشین وارد میشود و ماشین با
آنالیز کردن آنها و استفاده از یک الگوی مشخص، آن دادهها را دستهبندی میکند. اساس دستهبندی میتواند
بر مبنای شباهتها، تفاوتها یا الگوهای دیگر باشد. همچنین در اینروش برخلاف روش یادگیری
تحتنظارت، نیازی به فاز تمرینی و داده تمرینی برای ماشین نمیباشد.
در روش یادگیری تحت نظارت از پاسخهای «پسندیدن» و «نپسندیدن»، به عنوان برچسب استفاده میشود سپس
این برچسبها در شناسایی سیگنالهای مغزی مربوط به آنها به کار میروند.
بعد از فاز تمرین، در فاز تست از دادههای بدونبرچسب برای بررسی میزان دقت الگوریتم استفاده میشود.
اما از طرفی دیگر در یادگیری بدون نظارت نیازی به این برچسبها نیست. در این روش سیگنالهای مغزی به
منظور شناسایی دستهبندیهای متفاوت، آنالیز میشوند.
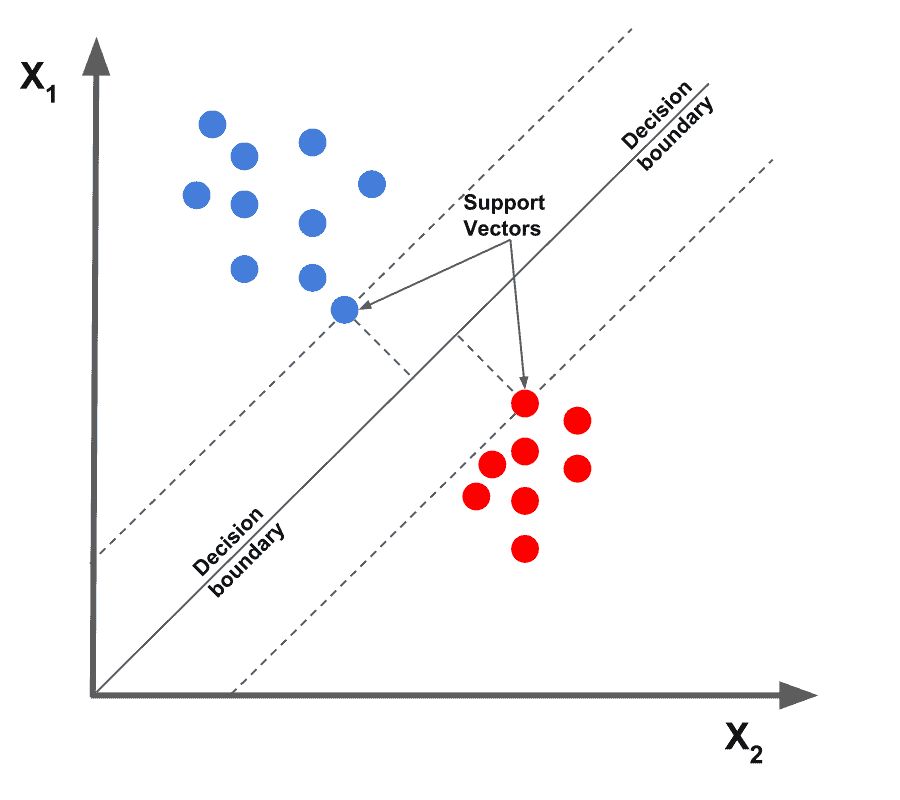
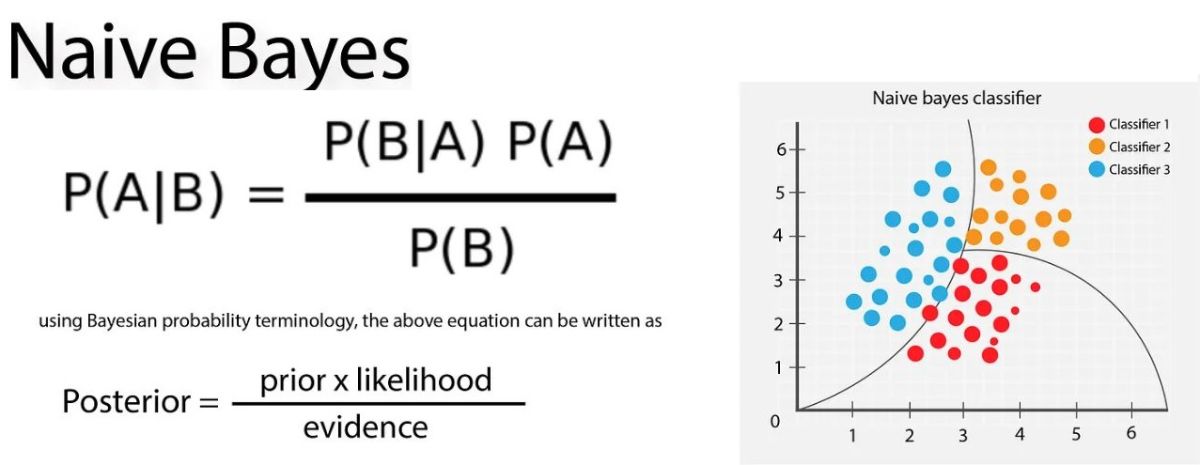
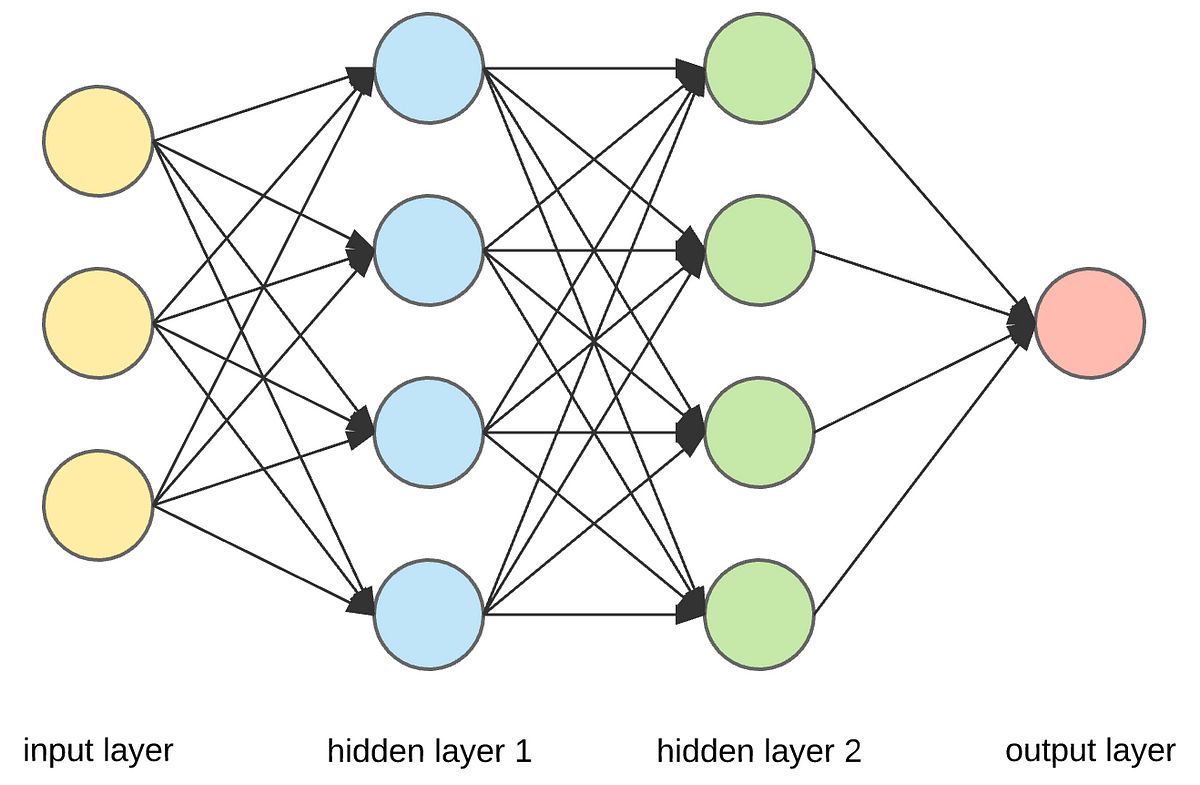
Support vector machine(SVM), Naive Bayes, Artificial Neural Networks(ANN), Random Forests(RF)
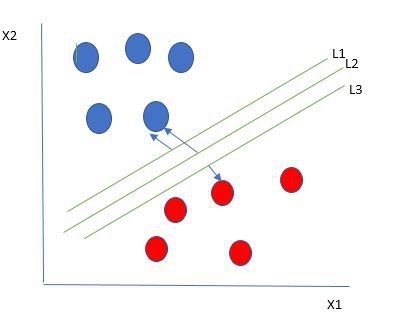
همچنین دادههایی که نزدیکتر به ابرصفحه هستند بعنوان 《بردار پشتیبانی》(support vector) انتخاب
میشوند. هدف در این الگو این است که بردارهای پشتیبانی بیشترین فاصله را تا ابرصفحه داشته باشند.
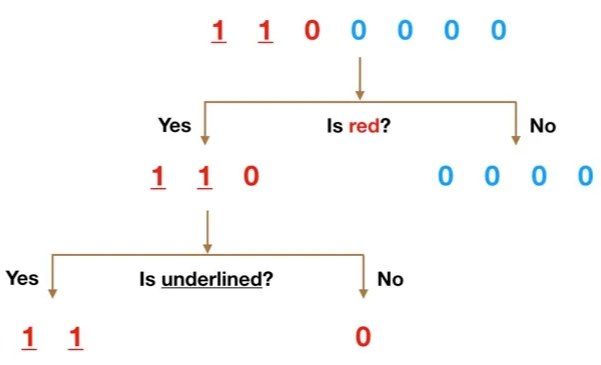
الگوی random forest زیرمجموعهای از ویژگیهای تصادفی را ایجاد میکند تا درختهای تصمیمگیری
کمترین ارتباط و تناسب را با هم داشته باشند. هر کدام از درختها به صورت جدا، یک دسته را پیشبینی
میکنند و در نهایت دستهای که توسط بیشترین درختها پیشبینی شده باشد، به عنوان نتیجه نهایی انتخاب
میشود.
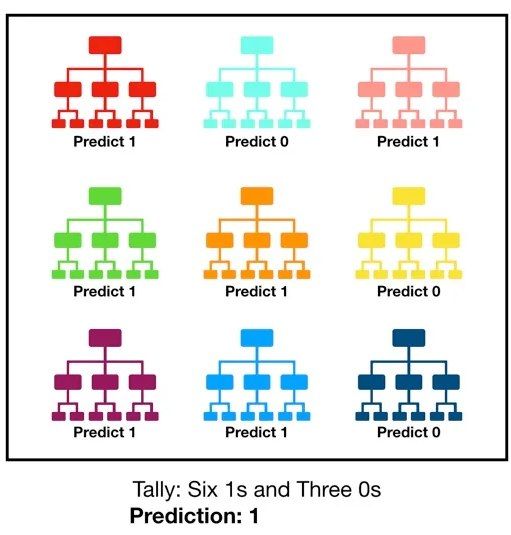
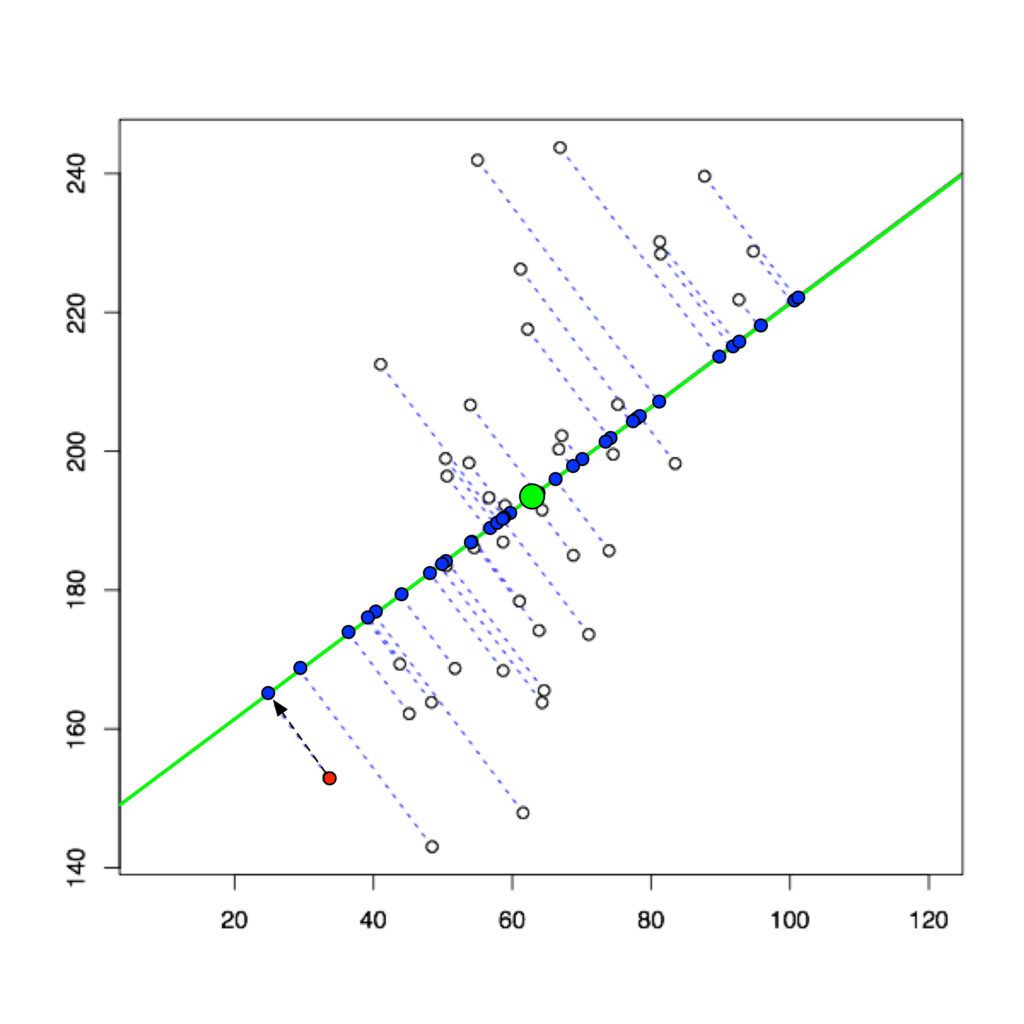
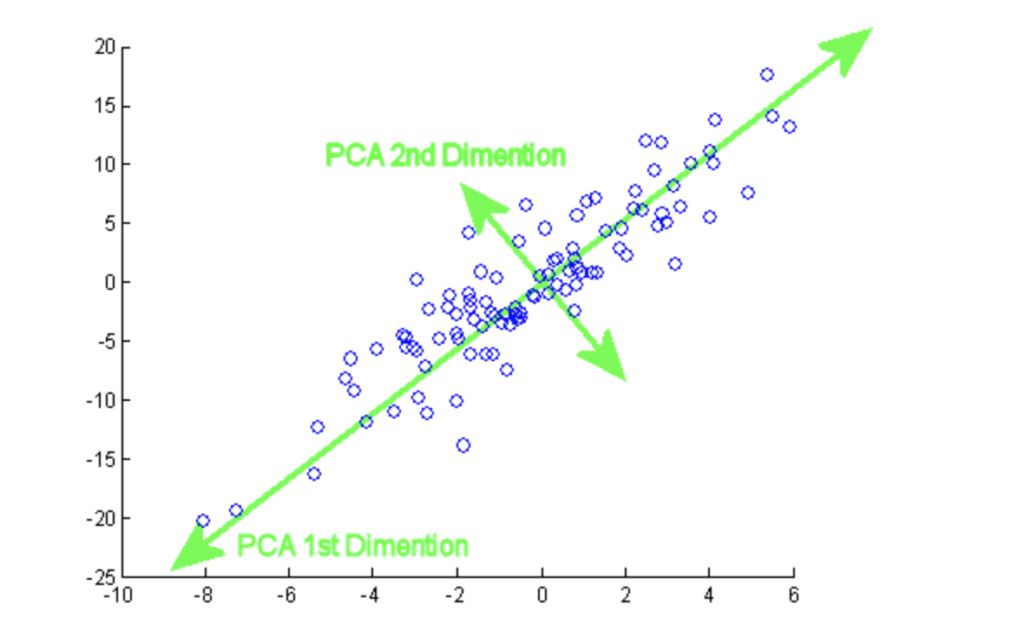
الگوریتم Principal Components Analysis(PCA): یک الگوریتم برای کاهش ابعاد داده است. این الگوریتم ابعاد دادههای بزرگ را کمتر کرده و آن را به دادههای کوچکی که حاوی اکثر اطلاعات مهم است تقسیم میکند. این روش با حذف کردن بعضی از دادهها، بررسی و تحلیل آن را برای ماشین آسانتر کرده و در عینحال تاثیر بسیار کمی روی دقت آن میگذارد. در شکل پایین خطی که با بیشترین دادهها، کمترین فاصله را دارد انتخاب شده، دادههایی که نزدیک به خط واقع شده به عنوان دادههای مهمتر انتخاب شده و دادههای دورتر نادیده گرفته میشوند.
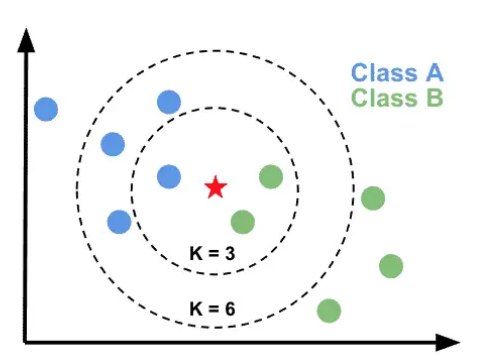
الگوریتم K-Nearest Neighbors(KNN) (البته این الگوریتم گاهی به عنوان الگوریتم تحت نظارت و گاهی به عنوان الگوریتم بدون نظارت در نظر گرفته میشود): در این الگوریتم فرض میشود دادههایی از یک دسته در نزدیکی هم قرار دارند. عدد K به عنوان یک ضریب، تعداد دادههای همسایهی اطراف داده مجهول را انتخاب کرده و هر داده را در مرکز یک دایره فرضی با تعداد K داده قرار میدهد. بدینترتیب دستهای که بیشترین داده از آن در ایندایره باشد، دادهی مجهول را نیز متعلق به آن دسته میکند. برای مثال در تصویر پایین اگر K را برای داده مجهول (ستاره قرمز) عدد 3 در نظر بگیریم، یک دایره فرضی با 3 داده همسایه به مرکزیت داده مجهول تشکیل میشود. به دلیل بیشتر بودن تعداد دادههای دسته B (داده سبز رنگ) در این دایره دادهی مجهول را نیز متعلق به دسته B میدانیم. همچنین اگر K را 6 در نظر بگیریم، در دایرهای با 6 داده همسایه، تعداد دادههای دسته A (داده آبی رنگ) بیشتر بوده و داده مجهول را متعلق به دسته A میدانیم.
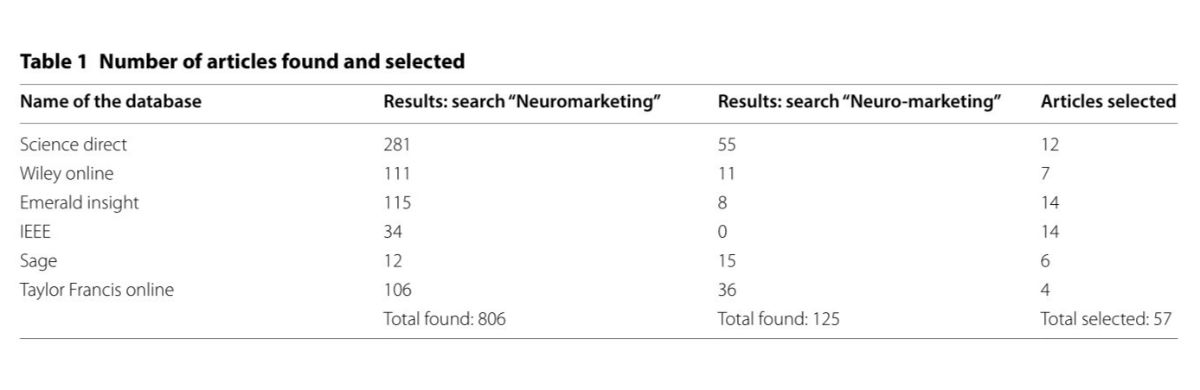
امروزه، مقالات نورومارکتینگ بر آنالیز پاسخهای رفتاری مشتریان تمرکز کردهاند. این آزمایشات بهطور عمده از تئوری 《ناقرینگی پیشانی آلفا》برای کانال چپ و راست پیشانی استفاده میکنند.
علاوه بر گروه امواج آلفا، از امواج بتا و تتا نیز برای شناسایی عصبی و پاسخهای احساسی مشتریان استفاده میشود. جدول پایین آمار یافتههایی مربوط به امواج مغزی و عملکرد آنها در مطالعات نورومارکتینگ را نشان میدهد.
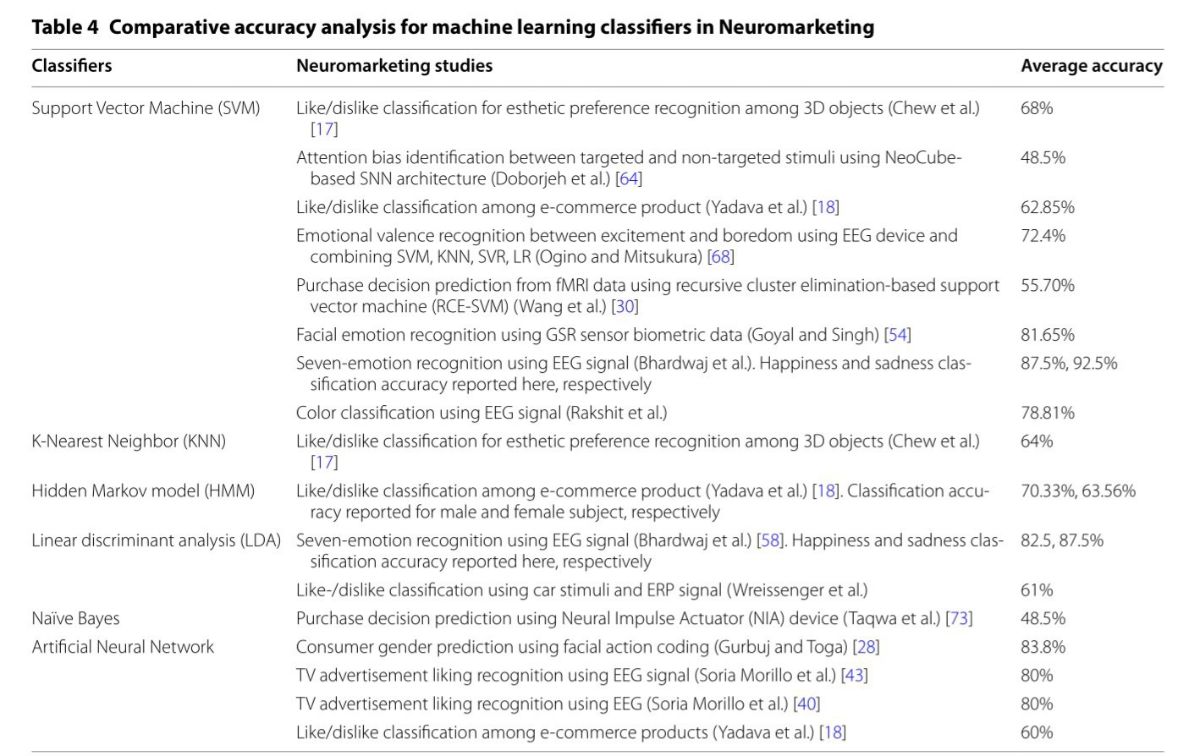
در این مطالعه تعداد زیادی از تحقیقات نورومارکتینگ، از هوشمصنوعی بهمنظور پیشبینی و دستهبندی استفاده کردهاند. جدول پایین دقت میانگین این الگوریتمها را در مطالعات نورومارکتینگ نشان میدهد.
طبق این جدول، شبکه عصبی مصنوعی با دقتی نزدیک به ۸۰ درصد، بیشترین دقت را میان این الگوریتمها دارد. اگرچه شبکههای عصبی مصنوعی به تعداد بیشتری داده برای فاز تمرینی نیازمند است اما این تعداد زیاد نیز خود بیانگر پویایی آن در نورومارکتینگ است.
بعد از شبکه عصبی مصنوعی، الگورتیم "SVM" با دقت ۷۰ درصد، بیشترین دقت در دستهبندی را کسب کردهاست.
همانطور که مطالعه کردید، هوش مصنوعی کاربردهای زیادی در نورومارکتینگ دارد که ماشینلرنینگ از شاخه های مهم آن است. این روش به سه دستهی تحت نظارت، بدون نظارت و تقویت شده تقسیم میشوند.در این سه دسته هر کدام از الگوریتمها، به طورمجزا در تحلیل اثر محرک ها بر فعالیت مغز و سپس در نورومارکتینگ میتوانند کاربرد داشته باشند. در نهایت وابسته به نوع مطالعه، دقت الگورتیمها مقایسه شده و دقیق ترین آنها برای تحقیقات انتخاب میشود.


