
در نقش یک محقق تجربه کاربری (UX Researcher)، توصیه میشه پست های شنود (Listening post) را رصد کنیم و فیدبک کاربران رو تجمیع کنیم تا بتونیم گوش شنوای فیدبک های کاربرامون باشیم و محصول بهتری رو به کاربر بدیم.
یکی از موارد پست های شنود برای یک محصول دیجیتال (در اینجا بصورت خاص اپلیکیشن) کامنت های کاربرامون توی کافه بازار و گوگل پلی هست. که در مورد جمع آوری کامنت ها به شخصه کمی چالش داشتم، راه حلی که بهش رسیدم رو تصمیم گرفتم شر کنم. صد البته بهترین راه نیست و یکی از اهدافم برای نوشتن این مطلب این بود که روشهای بهینه تر رو از خوانندگان مطلب دریافت کنم.
تعریف کلمه کلیدی Web Scraping: عمل «وب اسکرپینگ» یعنی یک نرم افزار به طور خودکار (احتمالا اینجا میشه نیمه خودکار) اطلاعاتی که توی سایتها بصورت عمومی در دسترس هست رو جمع کنه. تا از این راه بتونیم داده ها رو تحلیل و بررسی کنیم.
در این مطلب فرض شده بنا به هر دلیلی به پنل توسعه دهنده دسترسی نداریم.
چالش هایی که داشتم:
روش ها و افزونه های مختلفی رو برای این کار تست کردم و در نهایت با افزونه کروم Instant Data Scraper تونستم همونطور که مد نظرم بود دیتا رو جمع آوری کنم و خروجی اکسل بگیرم.
مزایای این افزونه:
بعد از نصب افزونه روی مرورگر کروم دسکتاپ، کافیه به صفحه اون اپلیکیشن توی کافه بازار نسخه وب رفت روی آیکن افزونه کلیک کرد. تا پنجره اون باز بشه.
بنا به دلایلی Autoload و نمایش "نظرات بیشتر" توی این افزونه برای سایت کافه بازار باگ داره و نمیشه به کارکردش مطمئن بود و لازمه قبلش چند بار بصورت دستی همه نظرات رو لود کنیم.
توی پنجره نمایش داده شده باید چند بار گزینه Try another table رو زد تا افزونه به درستی جدول نظرات رو انتخاب کنه. زمان min delay و max delay روی حالت پیشفرض جواب میده و اوکی هست.
نیازی به زدن Locate Next Button نیست چون بصورت دستی همه نظرات رو لود کردیم.
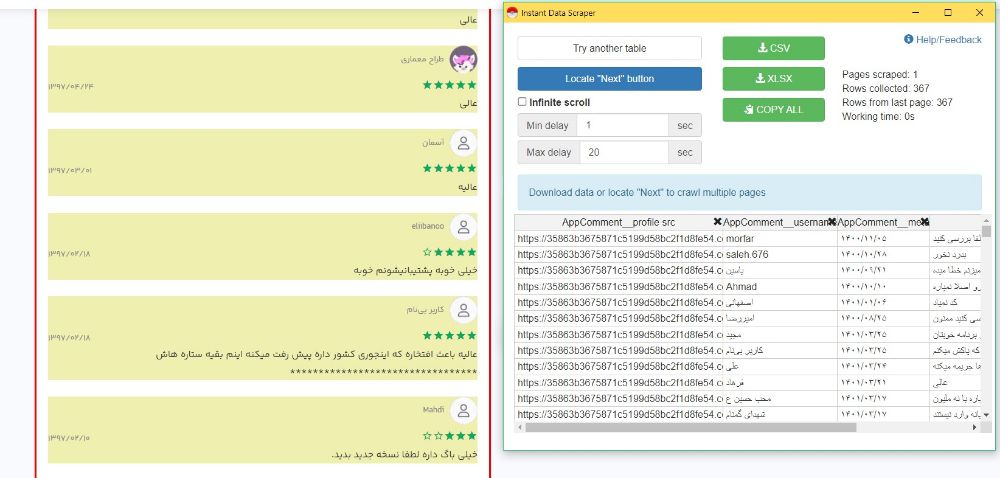
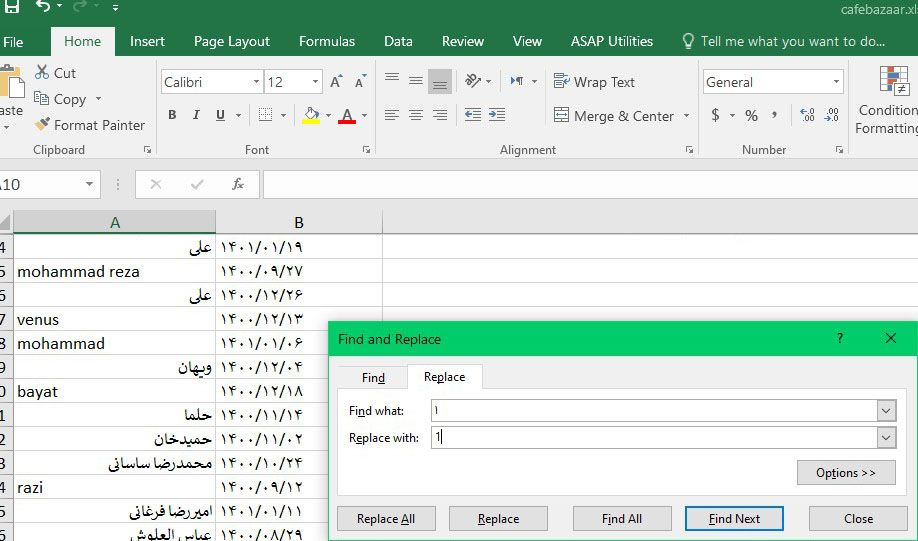
و تمام! با توجه به اینکه افزونه خروجی CSV فارسی رو درست انکد نمیکنه اینجا بهتره خروجی اکسل گرفته بشه.
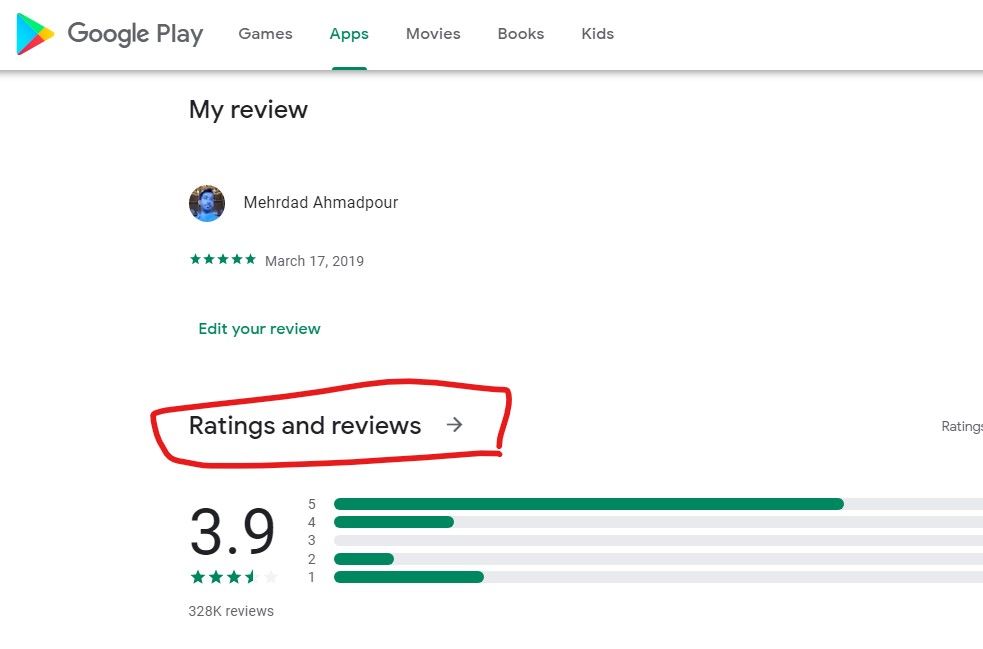
اینجا کار شبیه کافه بازار هست، اما با این تفاوت که نظرات در پنجره جداگانه باز میشه.
لازمه توی صفحه اپلیکیشن روی لینک مشخص شده کلیک کنید تا به مودال نظرات کاربران دسترسی پیدا کنید تا از اون صفحه بشه با افزونه، نظرات رو گردآوری کرد.
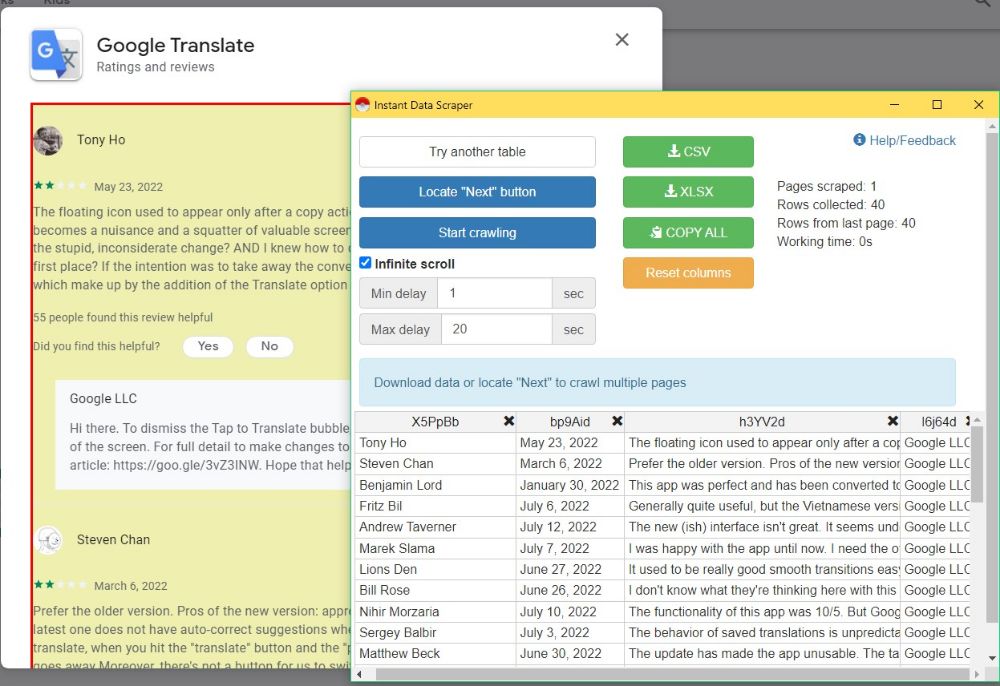
برای اسکن یا crawl کامنت های گوگل پلی استور ترجیحاً بهتره یک بار تا حد زیادی تا تاریخی که مرتبط باشه و زیاد قدیمی نباشه اسکرول بشه و بعد دکمه Start crawling رو بزنید. چون برای من یک بار دکمه Infinite scroll خوب تشخیص داد و بار دیگه درست نتونست اسکن کنه و بیش از 40 آیتم اسکن نکرد.
ممکنه روش های بهتری هم برای این روند باشه، سعی میکنم اگر به روش بهینه تری برخورد کردم این پست را آپدیت کنم. اگر پیشنهادی دارید ممنون میشم در بخش کامنت مطرح کنید.


