
فرض کن میخوای توی عنوان محصولات سرچ کنی و دنبال مقدار «شامپو بچه» بگردی. حالا برای همین موضوع میای چکار می کنی؟ بگی توی عنوان تک تک محصولات برو دنبال مقدار «شامپو بچه» بگرد و رکورد هایی رو که لازمه بر گردون.
مثلا محصول شماره ۱ عنوانش «شامپو بس بچه گانه» هست. به نظرت اگه بگی که %شامپو بچه% برات این رکورد رو میاره؟ قطعا جواب منفی هست.
حالا فرض کن یه فروشگاهی هستی که ۱۰ هزار تا محصول داری. برای سرچ کردن میای sequential scan میکنی؟ قطعا جوابت منفی هست و میگی ایندکس گذاری میکنم.
خب پس ما ۲ تا مشکل داریم که در نهایت هر دوشون با یه راه حل حل میشن. اونم اینه که متد ایندکس گذاری خودت رو باید درست انتخاب کنی.
در کل free text search توی دیتابیس های سنتی کار سختی هست. مثلا mysql ما یه فانکشن داریم و توی PostgreSQL هم متد های ایندکس گذاری GIN و GIST رو داریم. متدی که اینجا برای full text search توضیح داده میشه متد GIN هست. برای مطالعه بیشتر در مورد ایندکس ها توی PostgreSQL به این لینک مراجعه کنید.
مشکل اینجاس که تو اکوسیستم های جاوااسکریپتی یه پیاده سازی قوی نداریم. یعنی پشتیبانی کاملی از این ویژگی نداریم. پس searching nested data معمولا یه معضل هست. از اونجایی که هیچ دولوپری دوست نداره raw SQL بنویسه اکثرا سراغ ElasticSearch میرن که قابلیت های زیادی داره ولی ما اینجا دنبال چیز دیگه ای هستیم. پس اگه میخوای در مورد ElasticSearch بیشتر بدونی کلیک کن.
قبلش بگم که منم از ElasticSearch خیلی خوشم میاد ولی چیزی که اینجا مد نظرمونه اینه که تا حد امکان از امکانات خود PostgreSQL استفاده بکنیم.
برای اینکه بتونیم از قابلیت full text search استفاده بکنیم باید قبلش چند تا کار بکنیم:
برای شروع توسط داکر سرویسی از این داکر ایمیج ایجاد کنید. سپس وارد سرویس شوید و روی دیتابیس dellstore شروع به تست کنید. مثلا این کوئری رو بزنید:
select * from products where title like '%ALI%';
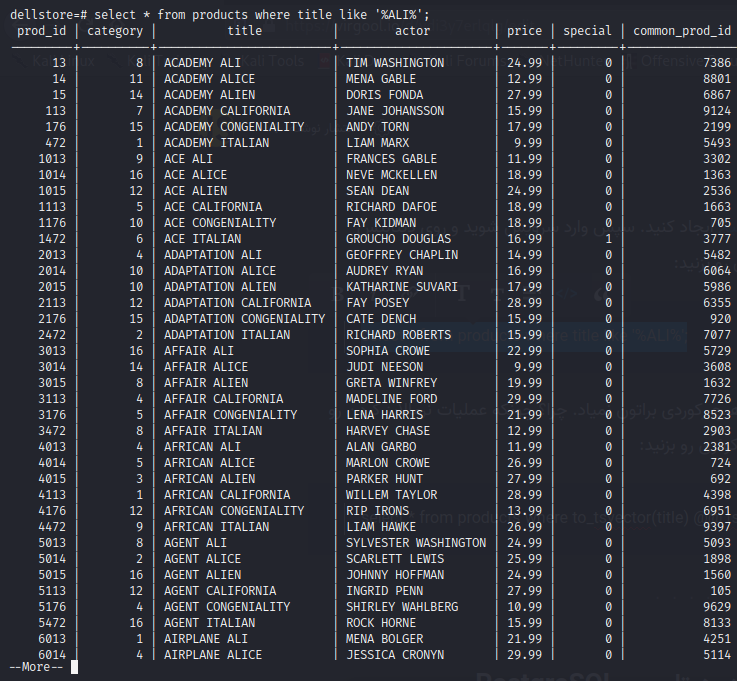
این کوئری براتون ۶۰ تا رکورد رو میاره. حالا ALI رو ali بکنید و همون کوئری رو بزنید. هیچ رکوردی براتون نمیاد. چرا؟ چونکه عملیات نرمالایز کردن رو براتون به صورت خودکار انجام نمیده. حالا این کوئری رو بزنید:
select * from products where to_tsvector(title) @@ tsquery('ali:*');
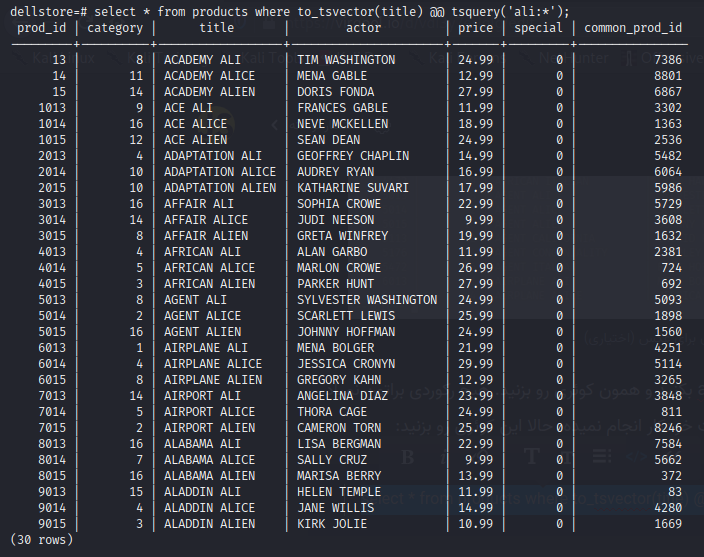
این کوئری براتون ۳۰ تا رکورد رو میاره و دیگه رکورد هایی مثل AMERICAN CALIFORNIA رو (آی دی ۴۱۱۳) براتون نمیاره.
حالا فرض کن کوئری باید روی title و actor بخوره. یعنی بگه مثلا این متن چه توی title چه توی actor بود اون رکورد رو بیار. تو حالت معمولی کوئری این شکلی میشد:
select * from products where title like '%ALI%' or actor like '%Matthew%';
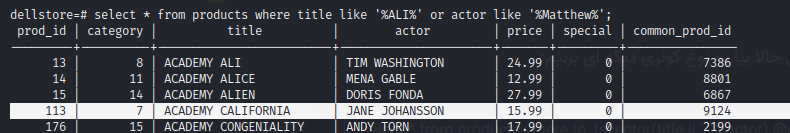
این کوئری برات ۶۰ تا رکورد رو میاره ولی حالا بیا یه نوع کوئری دیگه ای بزنیم:
select * from products where to_tsvector(title || ' ' || actor) @@ to_tsquery('matthew:* | ali:*');
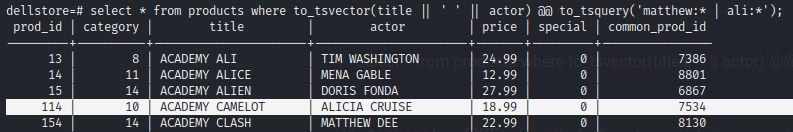
این کوئری برات ۱۲۲ تا رکورد رو میاره. خب پس حتما متوجه شدی که اصلا نمیشه LIKE رو با tsquery مقایسه کرد. کوئری اول برات محصول آی دی شماره ۱۱۳ رو میاره ولی کوئری دوم برات محصول آی دی شماره ۱۱۴ رو میاره. دلیلش اینه که توی کوئری اول گفتی توی actor فقط Matthew باشه و توی title فقط ALI باشه. ولی کوئری دوم میگه من دنبال matthew و ali توی همه رکورد ها تو هر دو ستون title و actor میگردم.
نوع tsvector
توی دیتابیس PostgreSQL برای full text search (جستجو توی متون) ۲ نوع داده tsvector و tsquery تعریف شده. tsvector یه داکیومنت رو جوری نمایش میده که برای text search بهینه سازی شده هست. tsquery هم یه text query هست.
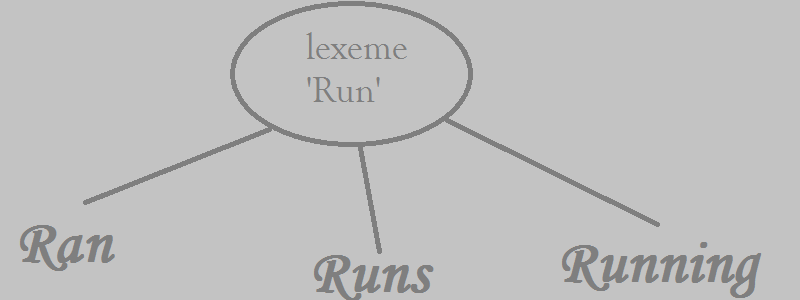
نوع داده tsvector مجموعه ای از lexeme ها هست. این مجموعه یه لیست مرتبه. lexeme مجموعه ای از اشکال یک واژه هست که normalize هم شدن. نکته اینه که مرتب سازی و duplicate-elimination (حذف واژه های تکراری) به صورت اتوماتیک انجام میشه.
وقتی داری جدول رو ایجاد می کنی می تونی بگی یه فیلد دارم که از نوع TSVector هست یا بعدا بهش اضافه کنی.
create table table_name (id serial primary key, title tsvector);
alter table products add column __search tsvector;
توی تصویر زیر می تونید lexeme ها رو بهتر ببینید.
نوع TSVector عملیات normalize کردن رو به صورت اتوماتیک انجام نمیده. مثلا توی مثال زیر fat و Fat دو تا در نظر گرفته میشن.
SELECT 'The Fat Rats fat'::tsvector;
پس برای normalize کردن باید از فانکشن to_tsvector استفاده کرد.
SELECT to_tsvector('english', 'The Fat Rats');
چونکه داریم از یه دیتاست استفاده می کنیم در زیر اومدیم فیلد جدید update کردیم.
UPDATE products SET __search = to_tsvector(title || ' ' || actor); /*my choice*/
UPDATE products SET __search = to_tsvector(title); /*or you can do this*/
برای اطلاعات بیشتر در مورد ایندکس گذاری توی PostgreSQL به این پست مراجعه کنید. برای ایجاد ایندکس این کوئری رو اجرا کنید:
create index idx_table_name_field_name on table_name using GIN(field_name);
for example
create index idx_products_search on products using gin(__search);
وقتی یه ستون مجزا برای ذخیره داکیومنت های tsvector می نویسیم باید یه trigger تعریف بکنیم تا بیاد مقدار اون ستون رو به روز نگهداره. دو تا store procedure از پیش تعریف شده توی PostgreSQL برای اینکار هست. اولیش tsvector_update_trigger هست.
این trigger ها به صورت خودکار میان چند تا ستون textual ستون tsvector رو محاسبه میکنه.
tsvector_update_trigger(tsvector_column_name, config_name, text_column_name [, ... ]);
tsvector_update_trigger_column(tsvector_column_name, config_column_name, text_column_name [, ... ]);

/* for example: */

create trigger products_vector_update before insert or update on products for each row execute procedure tsvector_update_trigger(__search, 'pg_catalog.english', title, actor);
این عملگر میگه که tsquery ای که زدی با مقادیر ذکر شده توی ستونی که از نوع tsvector هست مطابقت داره یا نه. مقداری که این عملگر بر میگردونه از نوع boolean هست.
اگه دو تا عملوند های این عملگر از نوع tsvector باشه اونا رو با هم concatenate میکنه و مقداری که بر میگردونه tsvector هست. ولی اگه عملوند های دو طرف این عملگر از نوع tsquery باشه اونا رو با هم OR میکنه و مقدار بازگشتی اون از نوع tsquery خواهد بود.
برای اینکه ۲ تا tsquery رو با هم AND بکنی می تونی از این عملگر استفاده بکنی. توی مثال زیر یه نوع دیگه & رو توی tsquery می بینید. این & میگه که این دو تا واژه رو به عنوان دو تا tsquery جداگونه در نظر بگیر. تو مثال زیر اون & مشخص کننده اینه که رکورد هایی رو بیار که توشون dee و matthew باشه و اصلا مهم نیست که:
select * from products where __search @@ to_tsquery('dee & matthew');
ولی مثلا اگه شما رکوردی نداشته باشی که dee matthew به همین ترتیب توش نوشته شده باشه با کوئری زیر به اون مقدار دست پیدا نمی کنید.
select * from products where __search @@ to_tsquery('dee matthew');
برای منفی کردن tsquery از این عملگر استفاده میشه.
وقتی چند تا tsquery داری و میخوای بگی که بعد از این tsquery این tsquery باید باشه از این عملگر استفاده می کنیم.
select * from products where __search @@ to_tsquery('dee<->matthew');
برای زمانی استفاده میشه که بخوای بگی توی tsquery1 آیا کل tsquery2 قرار دارد یا نه. نوع بازگشتی آن boolean هست.
برای زمانی استفاده میشه که بخوای بگی توی tsquery1 آیا مقادیر tsquery2 را دارد یا نه. نوع بازگشتی آن boolean هست.
این عملگر دقیقا مثل wildcard درصد توی عملگر LIKE هست. مثلا توی کوئری زیر همه رکورد هایی که با mat شروع میشن برگشت داده میشن.
select * from products where __search @@ to_tsquery('mat:*');
فرض کن شما الان از سمت فرانت اند یه کوئری اومده که توش matthew و dee نوشته شده است. حالا میخوای سرچ بزنی. میای میگی برو تمام رکورد هایی رو که توشون matthew و dee هستن رو برام بیار و برات مهم نباشه که بعد از matthew یا dee چیزی نوشته شده یا نه. مثلا matthew1 و matthewAlx هم برگردونده میشه.
select * from products where __search @@ to_tsquery('dee:* & matthew:*');
نکته: عملگر های مقایسه ای (=، > و ...) که برای B-tree تعریف شدن توی tsvector هم پشتیبانی میشن ولی کاربرد زیادی برای text search ندارن.
یه tsquery ای تولید میکنه که از punctuation ها صرف نظر میکنه.
select * from products where __search @@ plainto_tsquery('academy freeman');
یه tsquery ای تولید میکنه برای جستجو توی متن که از punctuation ها صرف نظر میکنه.
هی tsquery ای تولید میکنه که مناسب کوئری های سرچ اینترنتی هست.
نرمالایز کردن لغات و تبدیل کردنشون به tsquery
تبدیل یه text به tsvector
میاد رنک داکیومنت رو بر میگردونه
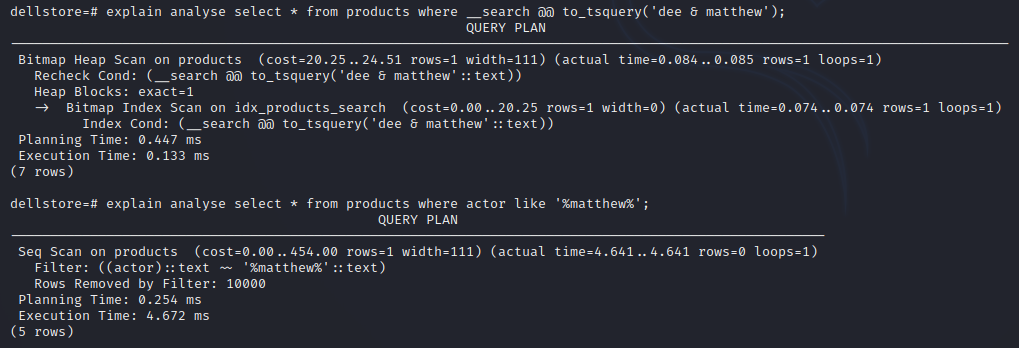
الان ما یه حرکتی میزنیم تا تفاوت سرعت رو ببینید. توی تصویر زیر ما اومدیم یه کوئری نسبتا خوب روی جدول products روی فیلد __search زدیم و بعدش همون کوئری رو روی فیلد actor زدیم. تفاوت سرعت اجرا ۴۰ برابر هست و سرعت دادن جواب نهایی ۸ برابر سریع تر هست.
در کل یه tradeoff بین recall و precision داریم.
High precision means that fewer irrelevant results are presented
معنی precision بالا یعنی نتایجی غیر مرتبطی که بر میگرده خیلی کم هست
High recall means that fewer relevant results are missing
ولی recall بالا یعنی نتایج مرتبطی که گم میشن خیلی کم هست.
استفاده از عملگر LIKE بهتون دقت بالایی میده. مثلا تو سرچ می کنی "%کتاب%" و نتایجی که دریافت حتما شامل کلمه کتاب هستن. ولی توی مدل recall جواب هایی که برات میاد میتونه شامل "کتاب ها"، "کتب"، "کتاب های" و ... . البته بازم به الگوریتمی که برای سرچ استفاده می کنه بر میگرده.
استفاده از عملگر LIKE بهتون صد درصد precision میده بدون هیچ recall ای. اما full text search بهتون یه عالمه انعطاف پذیری برای پایین آوردن precision و بالا بردن recall میده. اکثر پیاده سازی full text search ها از inverted index استفاده می کنند. inverted index یه ایندکسی هس که key ها term های منحصر به فردیه.
برای مطالعه بیشتر در مورد ایندکس ها و inverted index توی postgres کافیه یه سر به این پست بزنید.
مقدار هر key به مجموعه ای از رکورد ها وصل میشه که حاوی اون term هستن. full text search برای intersection ،union و ... بهینه شده. یه الگوریتم ranking درجه اینکه یه رکورد توی این مجموعه رکورد ها، چقدر به کلمه سرچ شده میخوره مشخص میکنه.
ولی نکته مهم در مورد LIKE این هست که این عملگر فوق العاده میتونه inefficient باشه. مثلا:
ولی اگه ستون ایندکس گذاری شده باشه عملیات تطابق میتونه روی مقادیر کلید های ایندکس اجرا بشه، اما efficiency اون خیلی کمتر از وقتی هست که میگی دقیقا مقدار ایندکس همون باشه. بدترین شرایط استفاده از wildcard ها هست.


