
وقتی اتفاق بدی رخ میده، اول باید بفهمیم چه اتفاقی افتاده و این یعنی نیاز به کلی داده از شرایط و محیط در زمان مورد نظر، و به دنبال اون مسئلهی جمعآوری و جستجو در میان دادهها، تشخیص شرایط خطا و... . این یکی از مسئلههایی بود که در تیم میانافزار باید حل میکردیم و برای حلش باید چند تا کار انجام میدادیم:
ما وب سرویسهامون رو با .NET توسعه داده بودیم که روی سرورهای ویندوزی مستقر بودن، و از MongoDB، Redis و Kafka روی ماشینهای لینوکسی استفاده میکردیم. تیم زیرساخت برای پایش سرورها PRTG رو راهاندازی کرده بود و موارد مربوط به سختافزار سرورها رو رصد میکرد. اما چند تا مشکل با اون داشتیم:
کمی قبل از اینکه ما این مسیر رو شروع کنیم، از یه طرف، حامد برای پر کردن خلأ بین اپلیکیشنها و ابزارهایی که میتونستن از طریق Web API اطلاعات مورد نظرشون رو جمع کنن (مثل PRTG) پروژهای راهانداخته بود به اسم Detectors. و از طرف دیگه، به صورت محدود از ELK و Filebeat برای گردآوری Log استفاده کرده بودیم.
تا اینجا PRTG رو داشتیم که در کنار Detectors میتونست دادههای مورد نیاز رو تا حد خوبی جمعآوری کنه و با ELK میتونستیم فایلهای Log رو یکجا ببینیم. مشکل داشبورد هنوز به قوت خودش باقی بود و اینکه دو ابزار مختلف داشتیم خیلی رضایتبخش نبود. آشکارساز مجهز به ماژولهای Redis و Kafka بود ولی چیزی برای MongoDB نداشت.
در این شرایط میتونستیم:
اضافه شدن ابزار یا جایگزینی کل راهکار انقدری بد بود که بیخیال گزینه ۲ و ۴ بشیم. گزینهی ۱ هم اگرچه کمهزینهترین راه بود، اما بعضی از مشکلاتمون رو حل نمیکرد. پس سراغ گزینه ۳ رفتیم! چون:
البته باید اعتراف کنم که نمیشه نقش «شهوت تکنولوژی» و «مد بودن» رو در این انتخاب نادیده گرفت. اگر سرزنشمون کردین فکر کنم لازمه با Elastic Stack آشنا بشین؛ ولی مراقب باشین دستتون رو نبرین ؛)
ما کار عجیبی نمیخواستیم بکنیم و تا وقتی عکس هست، کی حال داره نوشته بخونه؟!
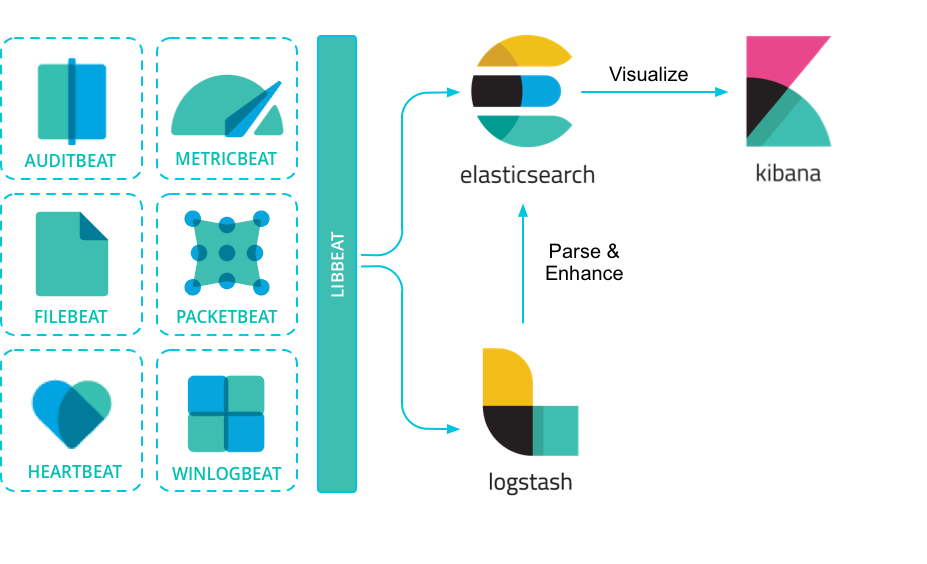
یکم دقیقتر بخوام توضیح بدم:
هووف! به نظر میاد وقت شادی پس از گل باشه، نه؟ اما من یکم از اصغر فرهادی ایده گرفتم و چیزهایی که خودمون زودتر فهمیده بودیم رو بهتون نگفتم که بتونم تا اینجا بیارمتون و بگم: متأسفانه اینطور که فکر میکنین نیست!
در مراحل بررسی گزینهها متوجه شده بودیم که ماژولهای Redis و MongoDB از متریکبیت همهی سنجههای مورد نظر ما رو گردآوری نمیکنن. لعنت به متنباز، گنو و هر چی بهش مربوطه!!
اما ما اینطوری بهش فکر نکردیم و با خودمون گفتیم:
مردم از کاشتن زیان نبرند؛
دگران کاشتند و ما خوردیم،
ما بکاریم و دیگران بخورند.
پس آستینهامون رو بالا زدیم، محیط توسعه رو آماده کردیم، چیزهایی که لازم داشتیم رو نوشتیم و بهشون PR دادیم (۷۶۹۵، ۷۶۱۳، ۷۶۱۱، ۷۶۰۴)؛ حالا توی نسخهی ۶.۵ اغلب این تغییرات منتشر شده.
در مسیر استفاده از این تکنولوژی، نکتههای کوچکی فهمیدیم که زندگی رو برامون شیرینتر میکرد. اولیش استفاده از قابلیت اضافه کردن field به Beatها برای دسترسی بهتر به دادهها بود. و به طور عمومی از این فیلدها استفاده کردیم:
تجربه دوم این بود که باید بر اساس بسامد تولید داده و حجم دادهها، قالب indexها رو مشخص کنیم. برای نمونه حجم دادههایی که توسط پکتبیت در یه روز تولید میشد، حدود ۵-۱۰ گیگابایت بود ولی حجم لاگهای گردآوری شده تو یه هفته به سختی به همین رقم میرسید!
درس سوم این بود که وقتی نگاشت (mapping) برای یه نمایه (index) ایجاد بشه، دیگه به این راحتی نمیشه اصلاحش کرد. به همین خاطر برای تست تجزیه با grok یا خروجی ماژول جدید، از یه نمایه مجزا برای عیبیابی استفاده میکردیم (و برای سهولت در شناسایی بهش پسوند debug میدادیم).
در این نوشته، بیشتر به انتخاب ابزار برای گردآوری، تحلیل، دیداریسازی و هشداردهی پرداختیم. اما هنوز سؤالاتی مثل این که «چه اطلاعاتی باید جمع کنیم؟»، «چطور از ElastAlert استفاده کردیم؟» و... بیجواب مونده. اگر عمری بود در قسمتهای بعدی در مورد این چیزها مینویسم. تا اون موقع، میتونین نگاهی به «راهنمای کامل برای ELK» و «راهاندازی کلاستر عملیاتی Elasticsearch با رنچر» بندازین.


