
شبکههای اجتماعی و افزایش تولید حجم متن، تصویر یا ویدیو در بستر اینترنت و ... حجم عظیمی از داده را امروزه تولید میکنند. تمامی این شرکتها بزرگ همچون لینکدن، توییتر، گوگل، مایکروسافت و ... نیاز به ذخیرهسازی حجم عظیمی از اطلاعات و در عین پردازش آن برای استخراج اطلاعات آماری، پاسخگویی نیاز کاربران، تحلیل داده و ... دارند. همچنین اکثر این شرکتها اگر چه روشهایی را در طول زمان برای مدیریت دادههای خود در نظر گرفتهاند، اما هر کدام معمولا مقالات یا ابزارهایی را از روشهای نگهداری و پردازش دادهی خود در طول زمان منتشر و عمومی کردهاند. هر کدام از این ابزارها به شکل مختلفی بخش یا کلیهی نیازمندی حوزهی دادههای حجیم را پوشش دادهاند. به طور کلی، میتوانیم ابزارهای موجود در حوزهی دادههای حجیم را در یک طیف قرار دهیم که دو سر این طیف به شکل زیر است:
اکثر ابزارها معمولا به دو سر این طیف نزدیک هستند و بخشی از ابزارها نیز در میانه قرار دارند. هدف در این پروژه این هست که تا حد خوبی معماری ابزارهای مختلفی از این طیف را مورد بررسی قرار دهیم.
اکثریت تمرکز در این مقاله بر روی رویکرد صنعتی (مرور ابزارها، فناوریها و ..) میباشد. البته تعداد این ابزارها بسیار زیاد میباشد و همگی آنها نیز به صورت مبنعباز نبوده و تنها تعدادی مقاله در مورد آنها منتشر شده است. با این حال تلاش بر این بوده است که اکثر ابزارهای معروف پوشش داده شوند. بررسیهای این مقاله در مورد اکثر ابزارهای موجود در بخشی زیر میباشد:
در ادامه رویکرد یکسانی برای بررسی هر کدام از ابزارهای بالا مشخص شده است. برای این منظور یکسری معیارهای مشخص تعیین شده و هدف بر این است تا هر کدام از این معیارها برای ابزارهای ارائهشده در فهرست بالا بررسی شود.
در ادامه به ترتیب برای بخشی از فهرست ابزارها که بررسی شدهاند، توضیحات هر کدام از معیارهای بالا را مشاهده میکنیم.
کارکرد اصلی ابزار نگهداری داده است. این ابزار مجموعهای از نرمافزارهای منبع باز است که استفاده از شبکهای از رایانههای زیادی را برای حل مشکلات مربوط به حجم عظیم داده و محاسبات تسهیل میکند. بخش HDFS این ابزار یک چارچوب نرمافزاری برای ذخیرهسازی توزیع شده فراهم میکند.
ابزار یک سیستم فایل با ساختار بلوکی است که در آن هر فایل به بلوکهایی با اندازه از پیش تعیین شده تقسیم میشود. این بلوکها در یک خوشه (cluster) از یک یا چند ماشین ذخیره میشوند. این ابزار از معماری Master/Slave پیروی میکند، که در آن یک خوشه از یک گره اصلی (NameNode) تشکیل شده است و همه گرههای دیگر، گرههای برده (DataNodes) هستند. HDFS را میتوان بر روی طیف وسیعی از سرورها که صرفا جاوا را پشتیبانی میکنند مستقر کرد. با توجه به کارکرد Namenode، این مولفه به محیطی با فضای ذخیرهسازی کم و منابع محاسباتی بالا نیاز دارد.
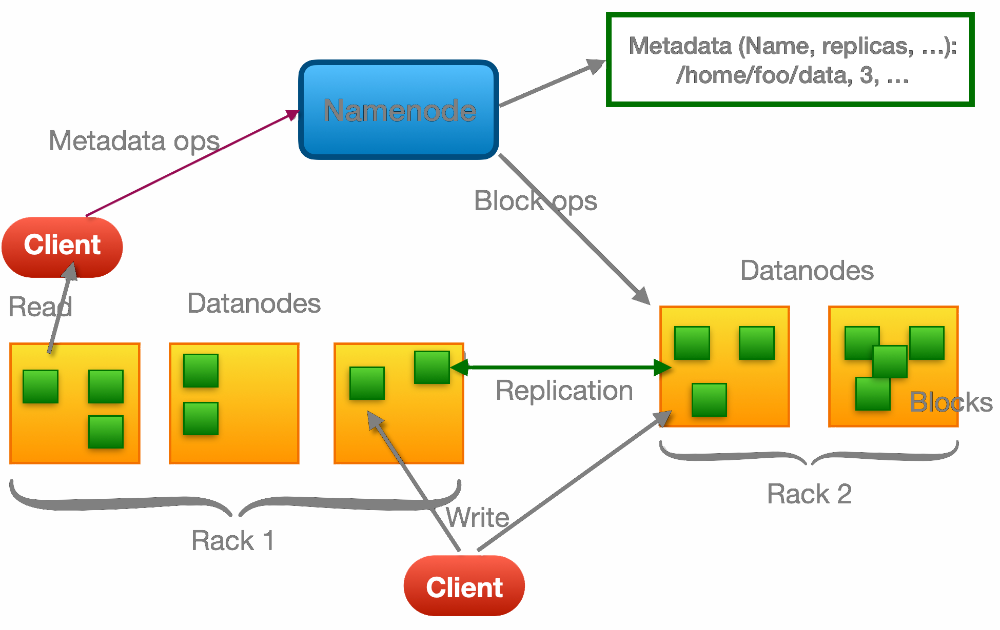
وظایف Namenode به شرح زیر میباشد:
تمام دادهها در گرههای برده ذخیره میشود و از این رو به منابع ذخیرهسازی بیشتری نیاز دارد. این گرههای برده میتوانند سروهای معمولی در محیط توزیع شده باشند. گرههای برده درخواستهای سطح پایین خواندن و نوشتن را از کاربرهای سیستم فایل انجام میدهد. به منظور ذخیرهسازی داده در هنگام نوشتن یا خواندن داده به منظور پردازش، ارتباط کاربر با گره اصلی برقرار میشود و خود گره اصلی این درخواست را در صورت نیاز به گرههای بردهی مرتبط انتقال میدهد.
در معماری ارائهشده برای این ابزار، گره اصلی به صورت پیشفرض نقطهی شکست سیستم (Single Point of Failure) محسوب میشود. ابزار در دسترسبودن گره اصلی را با اجازهدادن به ما برای داشتن دو گره اصلی در پیکربندی فعال/غیرفعال (active/passive) فراهم میکند. برای این منظور میتوان از یکی از رویکردهای زیر استفاده کنیم:
برای افزایش دسترسپذیری گرههای برده، مکانیزمهای مختلفی شامل تکرارکردن داده در گرهها (replication)، مکانیزم آگاهی از وضعیت و ساختار Rack ها و ... ارائه شده است تا در صورت از دسترس خارجشدن چندین گره برده از خوشه (بسته به نحوهی تنظیمات) مشکلی برای خوشه ایجاد نشود. از آنجایی که ما از سختافزار برای نگهداری داده استفاده میکنیم و میدانیم که میزان خرابی این سختافزارها بسیار بالا است، بنابراین اگر یکی از گرهها خراب شود، HDFS همچنان کپی آن بلوکهای داده از دست رفته را خواهد داشت. به همین دلیل تا حد خوبی به خطاهای سختافزاری در سطح نگهداری داده مصون هستیم.
به منظور کاهش سربار ابزار در هنگام راهاندازی (بعد از رخداد فاجعه یا خاموششدن موقتی به دلیل تعمیرات)، یک فرایند دیگر به نام Secondary Namenode ایجاد شده است. (این ابزار برای HA کردن مولفه نیست و صرفا به منظور ایجاد یکسری تصویر لحظهای از وضعیت گرههای اصلی هست)
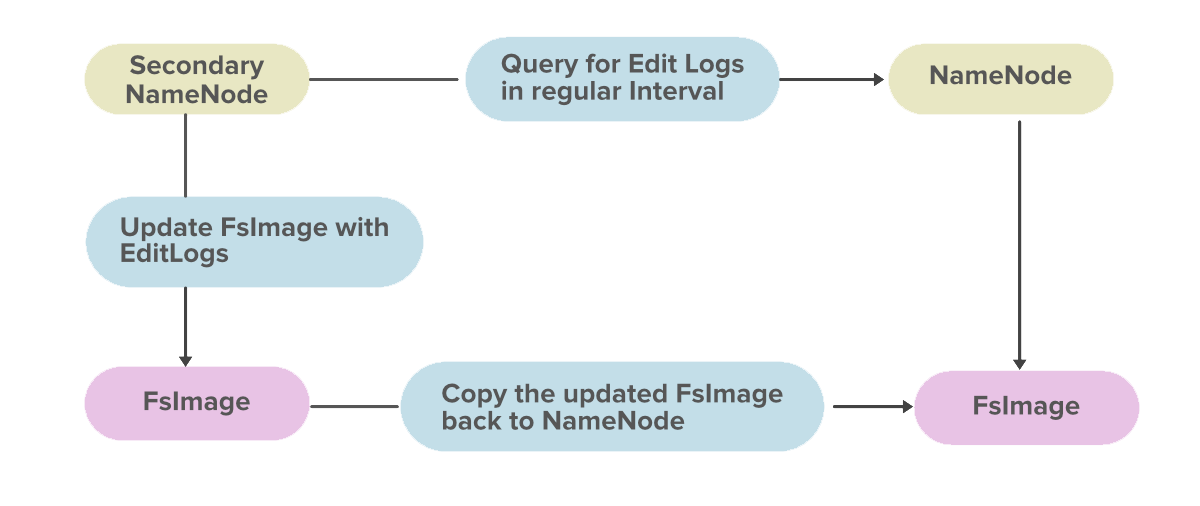
کارکردهای Secondary Namenode شامل موارد زیر میشود:
گره اصلی تضمین میکند که همه کپیهای یک بلاک در یک Rack ذخیره نشوند. برای کاهش تأخیر و همچنین ارائه تحمل خطا از یک الگوریتم هوشیاری Rack داخلی استفاده میشود. به عنوان مثال با در نظر گرفتن ضریب تکرار 3، الگوریتم Rack Awareness میگوید که اولین نسخه از یک بلوک در یک Rack محلی و دو کپی بعدی در یک Rack متفاوت (از راه دور) ذخیره شوند. مزایای الگوریتم Rack Awareness شامل موارد زیر است:
یکی از چالشهای مهم در حوزهی دادههای حجیم بحث نگهداری و مقاومبودن نبست به از دست رفتن داده است. معمولا وقتی یک سرور را به تنهایی نگاه میکنیم تکنیکهای مختلفی مثل RAID و ... استفاده میشود تا نسبت به از دسترفتن داده مقاوم شویم و در عین حال کارایی خواندن و نوشتن افزایش داده شود. اما این رویکردها و همچنین اتصال حجم زیادی دیسک به یک سرور یا استفاده از دیسکهای حجیم برای سرور مناسب نیست. استفاده از دیسکهای حجیم با توجه به سرعت محدود IO یک دیسک میتواند کارایی را کاهش دهد و همچنین در تعداد دیسکها نیز محدودیت وجود دارد. رویکردی که در HDFS استفاده میشود این است که داده در گرههای کلاستر توزیع میشود و مدیریت این توزیعها و استفاده از دیسک تمامی سرورها به صورت یکپارچه توسط این ابزار فراهم میشود. با توجه به موازیسازی کارایی خواندن دادهها و همچنین نوشتن دادهها (با توجه به تکرار دادهها برای مقاومسازی) افزایش مییابد.
به منظور دستیابی به پردازش با کارایی بالا، پردازش را به داده و نه داده را به پردازش منتقل میکند. در واقع به جای انتقال دادهها به یک گره و سپس پردازش آن، منطق پردازش به گرههای مختلف ارسال میشود و سپس دادهها به موازات گرههای مختلف پردازش میشوند. سپس نتایج پردازش شده به گرهای ارسال میشود که در آن نتایج ادغام میشوند و پاسخ به کاربر برگردانده میشود.
با توجه به معماری ارائهشده توسط این ابزار، به راحتی از طریق افزودن گرههای اصلی میتوانیم فضای ذخیرهسازی و قدرت پردازشی خوشه را افزایش دهیم. البته این مورد به راحتی در مورد گرههای اصلی صادق نیست و نیاز به افزایش منابع به صورت عمودی شامل فضای اصلی و ... (Vertical Scaling) دارد. با این حال به راحتی میتوانیم گرههای برده را به صورت افقی افزایش دهیم و تعدادشان برای تقسیم بار و پردازش سریعتر اضافه کنیم. (Horizontal Scaling)
از آنجایی که یک فرمت یکسان برای تمام نیازمندیها و سازمانهای دنیا کافی نیست، وجود پشتیبانی از فرمتهای متنوع و عدم ایجاد محدودیت در این زمینه بسیار مهم است. HDFS میتواند انواع دادهها را شامل ساختاریافته، نیمه ساختاریافته یا بدون ساختار ذخیره کند.
ابزار نوشتهشده امکان ارتباط با کلاستر HDFS را از طریق رابط کنسولی و همچنین محیط وب فراهم میکند. البته قابلیتهای ارائهشده در محیط وب شامل موارد محدودی مثل مشاهدهی فایلها، وضعیت کنونی کلاستر، تنظیمات و ... میباشد و برای بهرهگیری از تمامی قابلیتهای مدیریت و نگهداری ابزار استفاده از رابط کنسولی الزامی است. این ابزار مبتنی بر زبان Javaپیادهسازی شده است و به همین دلیل کلاینتهای آن معمولا برای زبانهای مبتنی برا JVM مثل جاوا و اسکالا بیشتر میباشد. از کلاینتها به منظور پردازش دادههای کلاستر استفاده میشود.
کارکرد اصلی ابزار مدیریت پردازش داده و زمانبندی است. این ابزار به روشهای مختلف پردازش داده مانند پردازش گراف، پردازش تعاملی، پردازش جریانی و همچنین پردازش دستهای اجازه میدهد تا دادههای ذخیره شده در سیستم توزیعشده هادوپ را پردازش کنند. به عبارتی این ابزار امکان اجرای انواع رویکردهای پردازش دادهی حجیم فراتر از MapReduce را فراهم میکند.
این ابزار همانطور که گفته شد در کنار ابزار HDFS مورد استفاده قرار میگیرد. این ابزار به عنوان بخش پردازشی اصلی هادوپ شناخته میشود و وظیفهی مدیریت پردازشهایی را که روی کلاستر انجام میشوند، بر عهده دارد. همچنین این ابزار وظایف زمانبندی کارها را (Job Scheduling) نیز انجام میدهد. برای این منظور تمام فعالیتهای پردازشی را با تخصیص منابع (بر اساس سیاستهای مختلف) و زمانبندی وظایف انجام میدهد.
این ابزار از دو مولفهی اصلی به نام Resource Manager و Node Manager تشکیل شده است و دو بخش فرعیتر آن Application Master و Container است.
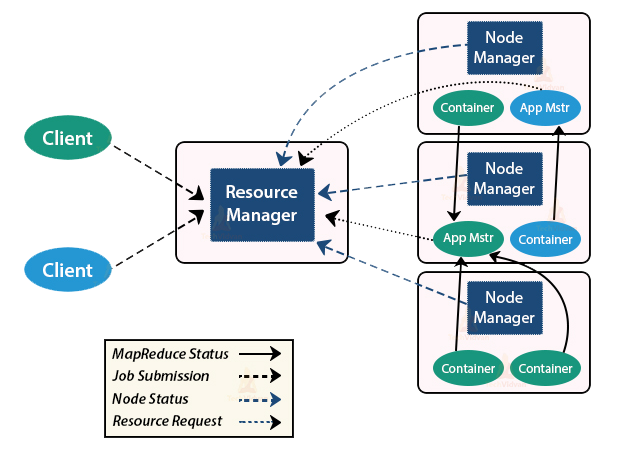
بخش Resource Manager وظایف زیر را بر عهده دارد:
این بخش از مولفه خود از دو بخش داخلی و مهم تشکیل شده است:
بخش گره اجرایی (Node manager) روی هر گره برده حاوی مولفهی DataNode نصب میشود و وظیفه اجرای درخواستهای آمده به سمتش را بر روی گرههای برده به عهده دارد. استفاده از منابع (حافظه، CPU و ...) ظروف اجرایی جداگانه را نظارت میکند و مدیریت لاگ را نیز انجام میدهد. همچنین طبق دستور مدیر منابع، ظرف اجرایی (Container) را در صورت لزوم متوقف میکند.
به ازای هر برنامه (Job) که از طریق این ابزار و به درخواست کاربر برنامهریزی میشود، یک مدیر برنامه (Application Master) منحصر به فرد ایجاد میشود. این مولفه اجرای برنامه را در خوشه هماهنگ میکند و همچنین خطاها را مدیریت میکند. وظیفه آن تعامل با منابع از طریق مدیر منابع (Resource Manager) و همکاری با گرههای اجرایی (Node Manager) برای اجرا و نظارت بر وظایف اجزا میباشد.
بخش ظرف (Container) مجموعهای از منابع فیزیکی مانند RAM، هستههای CPU و دیسکهای موجود در یک گره خوشه است که برای یک برنامه ارسالی از سمت کاربر استفاده میشود تا مقدار خاصی از منابع موجود در یک گره خاص را برای آن فراهم کند.
امکان بالا آوردن چندین نسخه از مدیر منابع (Resource Manager) برای افزایش دسترسپذیری سرویس ممکن میباشد. نحوهی بالا بردن دسترسپذیری ابزار کردن به صورت حالت فعال/غیرفعال میباشد و بعد از اتصال به Zookeeper میتواند به صورت خودکار در صورت متوقفشدن مولفه فعال، مولفهی غیرفعال جایگزین آن شود. (بدیهی است که دسترسپذیری ابزار وابسته به تنظیم درست ابزار وابسته میباشد)
همچنین Resource Manager کارهای ارسالی از سمت کاربر را بر روی گرههای اجرایی (Node Manager) اجرا میکند که در صورت از دسترفتن هر کدام از آنها (به دلیل خرابی ماشین یا ...)، امکان اجرای آن قسمت از کار بر روی گره اجرایی دیگری فراهم هست. به همین دلیل نسبت به از دسترفتن تعدادی گرده در خوشه بسته به تنظیمات صورت گرفته مقاوم میباشد.
این ابزار از طریق مکانیزمهای داخلی خود (مانند Node Manager و Scheduler) میتواند به صورت مناسب و همچنین پویا (dynamic) منابع موردنیاز برای اجرای درخواستهای کاربر را تخصیص دهد. فراهمنمودن رویکردهای مختلف توسط این ابزار از جمله معیارهای مختلف مثل انصاف، بهرهوری و ... برای نحوهی تخصیص منابع، بررسی پویای منابع در هنگام اجرا، اولویتبندی و ... از ویژگیهای زمانبند این ابزار میباشد. البته بدیهی است که برای دستیبای به کارایی خوب، لازم است که که ابزار هادوپ به خوبی تنظیم شود.
با توجه به سوارشدن این ابزار بر روی کلاستر هادوپ و مقیاسپذیری خود هادوپ، این ابزار نه تنها مقیاسپذیری هادوپ را کاهش نداده بلکه با رویکری مشابه امکان پردازش عظیم بر روی کلاستر هادوپ را با رویکردی مقیاسپذیر مشابه هادوپ فراهم کرده است. البته بدیهی است که برای دستیبای به مقیاسپذیری خوب، لازم است که که ابزار هادوپ به خوبی تنظیم شود.
این ابزار نه تنها بستری را برای پردازشهای توزیعشده روی کلاستر هادوپ فراهم میکند، بلکه این ویژگی را با انعطاف زیاد فراهم میکند. به این صورت که نه تنها امکان زمانبندی و مدیریت منابع برای برنامههای MapReduce که فریمورک محبوب هادوپ در زمینهی اجرای پردازشهای توزیعشده میباشد را فراهم میکند، بلکه برای ابزارهای توسعهدادهشده توسط دیگر شرکتهای مثل اسپارک، Hive و ... نیز بستری را فراهم میکند. به همین دلیل تقریبا در اکثر دیگر ابزارها به جای استفاده از زمانبند و مدیریت منابع داخلی، به صورت مستقیم از خود YARN استفاده میشود.
این ابزار این امکان را نیز فراهم میکند تا از طریق docker containerization چندین نسخه از یک برنامه در کنار هم اجرا کنیم که برای برخی نیازها مفید میباشد.
فراهمنمودن قابلیتها از جمله مشاهده کارهای در حال اجرا، منابع تخصیصدادهشده، میزان پیشرفت کارها و مدیریت لاگ از دیگر مزایای خوب این ابزار میباشد. این موارد هم از طریق API و هم از طریق محیط وب سادهای فراهم شده است. از طریق رابط تعاملی (CLI) نیز میتوان با این ابزار تعامل کرد.
با توجه به قرارگرفتن این ابزار بر روی ابزار هادوپ، محدودیتهای مشاهدهشده برای آن ابزار نیز در این قسمت صادق میباشد.
کارکرد اصلی ابزار، فراهمسازی پایگاه داده درحوزهی کلانداده میباشد. HBase یک پایگاه داده متنباز، چندبعدی (multidimensional)، توزیع شده، مقیاسپذیر و NoSQL است. HBase بر روی زیرساخت HDFS اجرا میشود و قابلیتهایی یک پایگاهداده را در اختیار Hadoop قرار میدهد. این ابزار به گونهای طراحی شده است که با تحمل خطای بالا، امکان ذخیره مجموعه بزرگی از دادههای توزیعشده را ارائه میدهد.
از نظر شیوهی نگهداری داده، این ابزار از روش column oriented برای نگهداری داده استفاده میکند که به منظور ذخیرهسازی حجم زیادی داده و همچنین انجام پردازشهای OLAP مناسبتر است. برای این منظور همانند پایگاهدادههای معمولی شامل جدول (table) میباشد اما هر جدول به صورت ستونی شامل تعدادی Column Family میباشد. یک Column Family میتواند از چندین Column Qualifier تشکیل شده باشد اما تمامی محتوای هر Column Family به صورت پیوسته روی دیسک ذخیره میشود. ذخیرهسازی دادهها به همراه زمان (Timestamp) مربوط به ویرایش/اضافهشدن میباشد که امکان جستجو روی نسخههای مختلف یک داده را فراهم میکند. در نگاه قضیهی CAP، تمرکز HBase بر روی فراهمسازی دسترسپذیری (Availability) و سازگاری (Consistency) بوده است. در این راستا، در یک ردیف، ابزار خواندن و نوشتن واحد (atomic) را فراهم میکند.
این ابزار از سه مولفهی اصلی شامل سرور HBase Region، سرور HMaster و منطقهها (Regions) تشکیلشده است که برای هماهنگی با یکدیگر از ابزار خارجی Zookeeper استفاده میکنند.
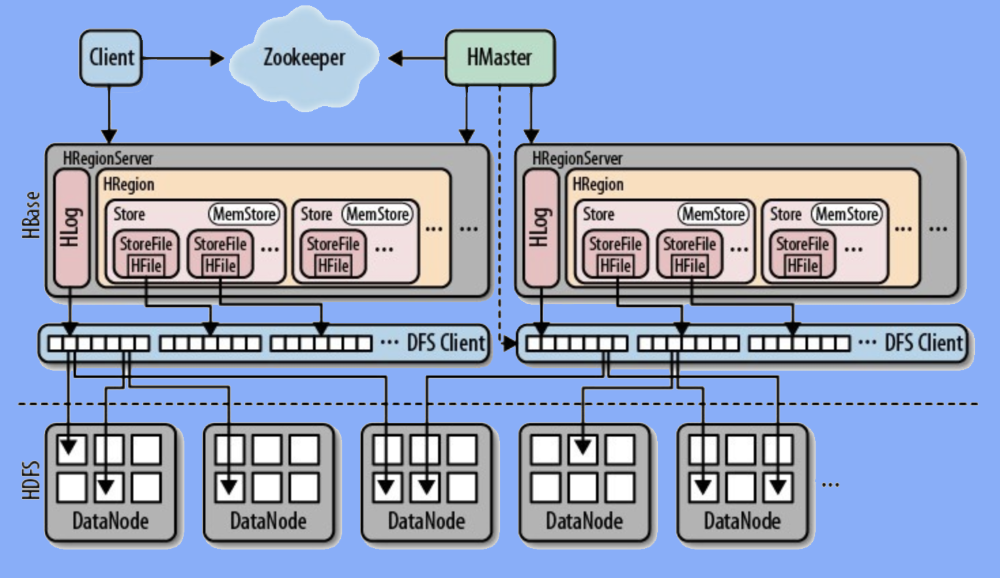
یک جدول به چند منطقه (Region) تقسیم میشود. منطقه یک محدوده مرتبشده از ردیفهایی است که دادهها را بین یک کلید شروع و یک کلید پایان ذخیره میکند. یک منطقه دارای اندازه پیشفرض 256 مگابایت است که میتواند بر اساس نیاز تغییر کند. یک گروه از مناطق توسط یکسرور منطقه (Region Server) به کاربران (clients) ارائه میشود. (مسئول مدیریت، اجرای عملیات خواندن و نوشتن در آن مجموعه از مناطق است) یک سرور منطقه میتواند تقریباً شامل 1000 منطقه باشد که نشاندهندهی قدرت پردازشی خوب این ابزار است.
سرور HMaster عملیات ایجاد و حذف جداول (DDL) را انجام میدهد و تخصیص مناطق به سرورهای مناطق توسط آن انجام میشود. هماهنگی و مدیریت مناطق به خصوص در هنگام راهاندازی بر عهدهی آن میباشد. در حین بازیابی و متعادلسازی بار، منطقهها را دوباره به سرورهای منطقه اختصاص میدهد. تمام سرورهای مناطق را با کمک Zookeeper در خوشه نظارت میکند و فعالیتهای بازیابی را هر زمان که سرور منطقهای از کار بیفتد، انجام میدهد. Zookeeper مانند یک هماهنگکننده در محیط توزیعشده ابزار عمل میکند و با برقراری ارتباط از طریق نشستها، به حفظ وضعیت سرور در داخل خوشه کمک میکند. هر سرور منطقه به همراه سرور HMaster ضربان قلب مداوم را در فواصل منظم به Zookeeper میفرستد و بررسی میکند که کدام سرور زنده و موجود است. (وضعیت سرورهای منطقه توسط جدول META در Zookeeper نگهداری میشود)
همانطور که در بخش معماری توضیح داده شد، تعداد زیادی سرور منطقه وجود دارد و قابلیت بازیابی خطا برای هر کدام از آنها به صورت خودکار توسط زوکیپر وجود دارد. در نتیجه به راحتی قابلیت مقیاسپذیری و در عین حال فراهمسازی دسترسپذیری دارند. همچنین بخش HMaster میتواند با کمک Zookeeper به صورت دسترسپذیر بالا با معماری Active/Passive اجرا شود و دسترسپذیری خوشه را افزایش دهد.
ابزار از طریق ماکنیزم WAL (Write Ahead Log) که بر روی سراسر خوشهی HDFS ارائه میدهد، قابلیت این را دارد که در زمان رخداد خطا و مشکل، به صورت خودکار خود را ترمیم و راهاندازی مجدد کند.
برای اتصال به کلاستر HBase در زمینهی جاوا کلاینت خیلی خوبی فراهم شده است که به راحتی امکان اتصال و بهرهوری از امکانات HBase را به صورت برنامهنویسی فراهم میکند. همچنین در زمینهی روشهای مبتنی بر Restful API و Thrift نیز امکاناتی برای اتصال کاربران فراهم شده است.
کارکرد اصلی ابزار پردازش داده میباشد. Apache Spark یک چارچوب محاسباتی خوشهای منبع باز و توزیعشده برای پردازش بلادرنگ (real-time) محسوب میشود.
در معماری اسپارک، ما یک گره master داریم که به عبارتی برنامه ما در آن اجرا میشود و مدیریت کل اجرای برنامه را به عهده میگیرد. (به عبارتی میتواند هر گرهای باشد که قابلیت اتصال به خوشه اسپارک را دارد) همچنین در کنار این گره master، کلی گره در خوشه داریم که از آنها در اسپارک با عنوان worker یاد میشود. در گره اصلی، برنامه درایور (driver program) را داریم که همان برنامهی نوشته شدهی ما میباشد. در واقعیت کدی که نوشته میشد به عنوان یک برنامه درایور عمل میکند یا اگر از shell استفاده کنیم، shell به عنوان برنامه درایور عمل میکند. در داخل برنامه درایور، اولین کاری که انجام میشود این است که یک Spark Context ایجاد میشود. این Context به صورت یک دروازه برای همه عملکردهای اسپارک عمل میکند.
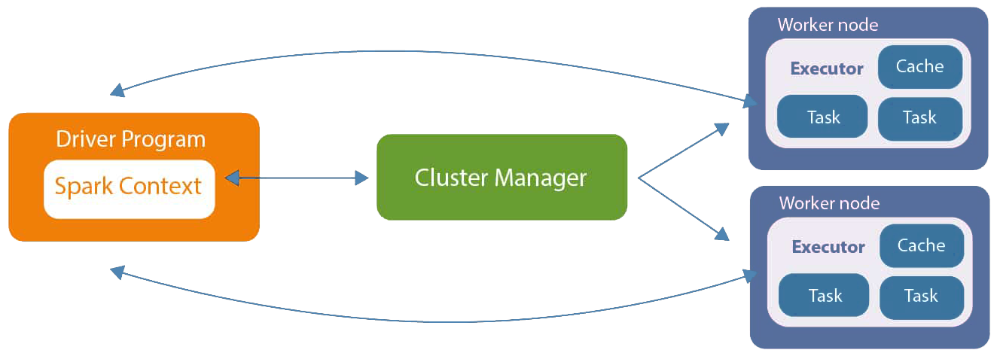
بخش Context با مدیر خوشه برای مدیریت کارهای مختلف هماهنگ میشود. برنامه درایور و Context از اجرای کار در خوشه مراقبت میکنند. یک کار یا برنامه به وظایف (task) متعددی تقسیم میشود که بر روی گرههای کارگر توزیع میشوند (توسط Executorsها اجرا میشوند) و سپس نتیجه به Context برگردانده میشود. گرههای کارگر، گرههای بردهای هستند که کار آنها اساسا اجرای وظایف است.
هنگامی که کاربر کد برنامه کاربردی را برای اجرا ارسال میکند، درایور به طور ضمنی کد کاربر را که شامل تبدیلها و اقدامات است به یک گراف غیر حلقهای منطقی (logical DAG) تبدیل میکند. در این مرحله بهینهسازیهایی مانند جابهجایی اجرای دستورات و ... نیز انجام میشوند. پس از آن، نمودار منطقی با چندین مرحله به طرح اجرای فیزیکی نهایی (Physical Plan) که همان اجرای واقعی روی خوشه اسپارک میباشد، تبدیل میشود. پس از تبدیل به یک طرح اجرای فیزیکی، وظایف (tasks) مختلف مبتنی بر آن ایجاد میشوند و به خوشه ارسال میشوند. قبل از ارسال، ابتدا از طریق Cluster Manager منابع لازم درخواست میشود و مدیر خوشه اجراکنندهها را (Executors) در گرههای کارگر راهاندازی می کند. سپس وظایف برای مجریان ارسال میشوند و مجریها شروع به کار میکنند، خودشان را نزد Context ثبت میکنند. در طول اجرای وظایف، برنامه درایور مجموعهای از مجریانی که اجرا میشوند را نظارت میکند. درایور گره همچنین وظایف آینده را بر اساس قراردادن دادهها زمانبندی میکند.
وظایفی که توسط اسپارک ایجاد میشوند، مبتنی بر ساختارهای دادهی RDD هستند. کلمهی RDD مخفف سه عبارت زیر میباشد:
اسپارک به منظور فراهمسازی دسترسپذیری بالا از معماری active/passive برای گرههای اصلی استفاده میکند. همچنین در زمینهی کارگرها نیز به صورت تحملخطا عمل کرده و در صورت پیشآمدن هر مشکلی برای یکی از گرهها، از طریق دیگر گرهها به اجرای دوبارهی آن بخش خاص از برنامه میپردازد. (البته لازمهی آن این است که داده فقط بر روی آن گره خاص نباشد. مثلا از طریق HDFS داده تکرار شده باشد و در چندین گره موجود باشد وگرنه خود داده باعث عدم دسترسپذیری بالا خواهد شد.)
اسپارک با استفاه از تعریف RDD و تبدیل دادههای ورودی به این انتزاع تلاش میکند تا در عین مستقلشده نسبت به دادهی ورودی، دسترسپذیری و تحمل خطای بالا را ایجاد کند.
اگر تعداد کارگران افزایش داده شود، کارها میتوانند به وظایف بیشتری تقسیم شوند و آنها به طور موازی در چندین گره کارگر اجرا شوند که بسیار سریعتر خواهد بود. با افزایش تعداد کارگران، اندازه حافظه نیز افزایش مییابد و میتوانید کارها را در حافظه اصلی نگه داشت (cache) تا سریعتر اجرا شوند.
همچنین ابزار قادر است از طریق پارتیشنبندی کنترلشده دادهها، به سرعت بسیار زیاد دست یابد. استفاده از این روش به موازیسازی پردازش دادههای توزیعشده با حداقل ترافیک شبکه کمک میکند.
اسپارک ارزیابی خود را تا زمانی که کاملا ضروری باشد به تاخیر میاندازد. این یکی از عوامل کلیدی در سرعت آن است. برای این منظور، اسپارک تبدیلات و دستورهای کاربر را به یک گراف غیر حلقهدار جهتدار (DAG) محاسبات اضافه میکند و تنها زمانی که کاربر مقداری داده را درخواست کند، این DAG واقعاً اجرا میشود. (همچنین قبل اجرا محتوای گراف تا حد امکان ساده و بهینه میشود)
با توجه به معماری برای اسپارک که شامل گرههای اصلی و کارگر میشود و اجرای وظایف تنها توسط کارگرها میباشد، میتوان با افزایش تعداد کارگرها به صورت خطی قدرت پردازشی و همچنین حجم پردازش موازی یا تحمل خطا را افزایش داد.
اسپارک به منظور تعامل با خوشه، APIهای سطح بالایی را در جاوا، اسکالا، پایتون و R ارائه میدهد. کد اسپارک را میتوان به هر یک از این چهار زبان نوشت. همچنین اسپارک نصبشده به صورت پیشفرض برای یکسری زبانها از جمله اسکالا و پایتون رابط کنسولی فراهم نموده است.
اسپارک از چندین منبعداده مانند Parquet، JSON، Hive و Cassandra جدا از فرمتهای معمول مانند فایلهای متنی، CSV و RDBMS پشتیبانی میکند. اسپارک مکانیزمی قابل اتصال برای دسترسی به دادههای ساختاریافته از طریق Spark SQL نیز فراهم میکند.
کارکرد اصلی ابزار پردازش داده بلادرنگ است. چارچوب محاسباتی پردازش جریانی منبع باز و توزیعشده است. پردازش جریانهای نامحدود داده به صورت قابل اعتماد (تحمل خطای بالا) فراهم میکند و برای پردازش بلادرنگ استفاده میشود.
ابزار هیچگونه قابلیت مدیریت داخلی ندارد و برای مدیریت وضعیت خوشهای خود، مواردی مانند تایید پیام، وضعیتهای پردازش و سایر پیامها، به ZooKeeper متکی است. همچنین دو مدل دادهی زیر در این ابزار استفاده میشوند:
معماری این ابزار مبتنی بر master/slave میباشد. یک سرور اصلی به نام Nimbus وجود دارد که روی یک گره به نام Master Node اجرا میشود. سرویسهای به نام سرپرست (Supervisor) وجود دارند که روی هر گره کارگر اجرا میشوند. سرپرستان یک یا چند فرآیند کارگری (worker process) شروع میکنند که به صورت موازی برای پردازش ورودی اجرا میشوند.
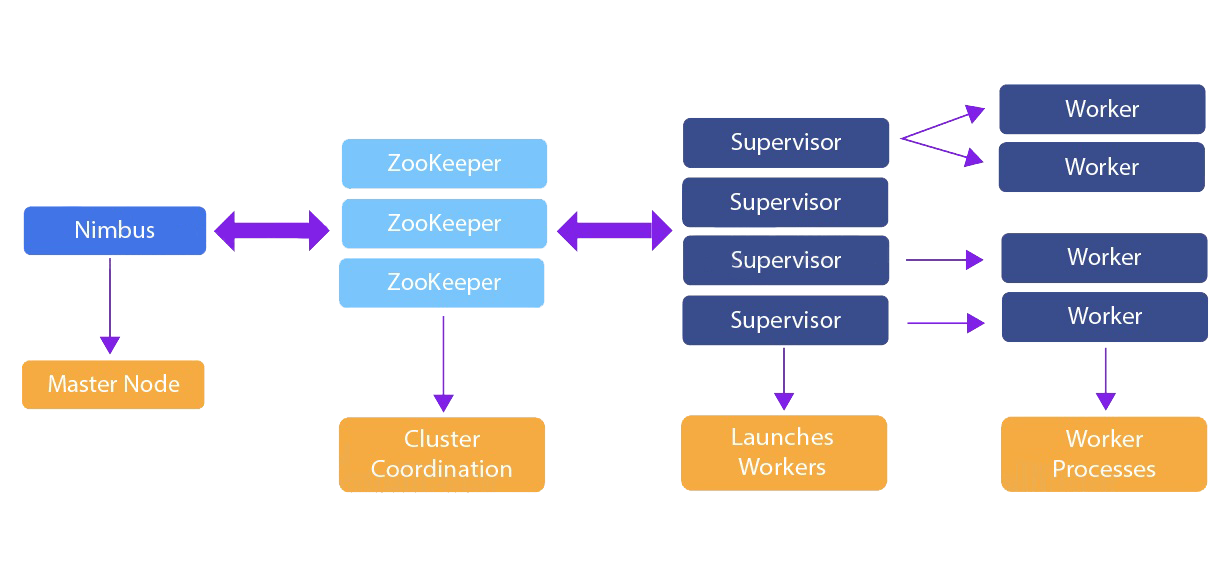
فرآیند Nimbus وظایف را به گرههای کارگر اختصاص داده و توزیع میکند. همچنین در عین حال وظایف را نظارت میکند تا از اجرای درست آنها مطمئن شود و وظایف مربوط به خرابی گره را مجدداً اختصاص میدهد. فرآیند سرپرست (Supervisor) روی هر گره کارگر از خوشه اجرا میشود. هر وظیفه را که از سمت گره اصلی به آن محول میشود، به عنوان یک فرآیند جداگانه به نام فرآیند کارگر (worker process) اجرا میکند. فرآیند کارگر همان کار و پردازش واقعی را انجام میدهد. اجراهای آنها توسط بخش سرپرست شروع و نظارت میشود. تعداد فرآیندهای کارگر برای هر وظیفه یا کار ایجادشده توسط کاربر بر روی خوشه، قابل پیکربندی است.
ابزار از دو مولفهی اصلی به نامهای Spout و Bolt تشکیل شده است. این دو نوع مولفه، جریان ورودی یا داخلی را پردازش میکنند. بخش دهانهها (spout) دادههای خارجی سیستم را برای تولید جریانهای tuple پردازش میکنند و آنها را به boltها میفرستند. این مولفه، دادهها را از سایر سیستمهای صف مانند کافکا، توییتر و ... میتواند دریافت کند. پیادهسازی Spout برای تولیدکنندگان داده محبوب در دسترس است. یک Spout واحد میتواند چندین جریان خروجی تولید کند که در صورت نیاز هر خروجی توسط یک یا چندین بخش دیگر مصرف شوند. Boltها جریان tuple ارسالشده به خودشان را دریافت میکنند و پردازش میکنند. خروجی آنها دوباره جریانی از tupleها خواهد بود که متناسب با کارکرد برنامه به مقصد مناسب ارسال میشود.
منطق هر برنامه در قالب یک توپولوژی بستهبندی شده است که اساساً شبکهای از Boltها و Spoutها است. توپولوژی برای همیشه اجرا می شود مگر اینکه کاربر سامانه به صراحت آن را متوقف کند. شبکه شامل گرههایی است که منطق پردازش را تشکیل میدهند و پیوندهایی که انتقال دادهها و اجرای فرآیندها را نشان میدهند. انواع توپولوژیهای کاربردی به صورت پیشفرض توسط ابزار فراهم شده است.
دسترسپذیری این ابزار با توجه به معماری آن به دسترسپذیری Zookeeper نیز وابسته میباشد. با این حال پیادهسازی آن به گونهای است که بر روی گرههای فراوانی (workers) استقرار مییابد و نحوهی پیادهسازی آن تحمل از دسترفتن تعدادی گره را فراهم میکند. همچنین پیادهسازی گره اصلی به صورت active/passive میباشد که دسترسپذیری بالایی را فراهم میکند.
قابلیت اعتماد یا تحمل خطای این نرمافزار متناسب با نیاز کاربر میتواند تضمین کند که هر واحد داده حداقل یک بار یا دقیقا یک بار پردازش شود. پیامها فقط زمانی دوباره پردازش میشوند که خرابی وجود داشته باشد. برای این منظور لازم است که پیادهسازی مربوط به spoutها و boltها در صورت رخداد خطا، در صورت نیاز کاربر فرایند پردازش را تکرار کنند. البته پیادهسازی این قابلیت به تنهایی از طریق Storm ممکن نیست. در مورد بخشهای ورودی داده (spout) لازم است که منبع ورودی داده قابلیت دریافت بازخورد داشته باشد و بتواند در صورت نیاز داده را دوباره ارسال کند. (مثلا اگر UDP باشد Storm در آن صورت کاری نمیتواند انجام دهد) همچنین برای بخشهای داخلی (Bolt) لازم است که پردازشهای رخداده در لایهی ذخیرهکنندهی میانی (مثل یک حافظهی in-memory یا دیتابیس یا ...) ذخیره شوند تا در صورت خطا امکان ادامهی فرآیند و از دستنرفتن دادهها وجود داشته باشد. اگر این امکان فراهم نشود، Storm دوباره کاری نخواهد کرد. به عبارتی این ابزار در صورت فراهمسازی شرایط امکان تحملخطا و پردازش تمامیدادهها را دارد اما به تنهایی این امکان را به صورت داخلی فراهم نکرده است. (غیر از پیادهسازی یکسری امکانات برای اتصال به ابزارهای معروف مثل Kafka یا Hadoop)
متناسب با تنظیماتی که برای اجرای jobها مشخص میشود و منابعی که در اختیار آن گذاشته میشود میتواند کارایی خوبی در پردازش دادههای درون خوشه داشته باشد.
همچنین بسته به این که پیادهسازی مربوط به ورودیدهندههای داده (spout) به چه صورتی باشد، میتواند توانایی پردازش حجم زیادی داده با نرخ بالای ورودی را داشته باشد. به عبارتی کارایی آن در بخش ورودی متناسب با نوع ورودی داده است. (به عنوان مثال اگر از کافکا برای ورودی داده استفاده شود، کارایی برنامه وابسته به کافکا خواهد بود یا اگر از Hadoop به عنوان مبدا ورودی داده استفاده شود، کارایی وابسته به تنظیمات و توانایی خوشه Hadoop خواهد بود)
زمان تاخیر مربوط به این ابزار با توجه به مسئلهی مدلشده میتواند متفاوت باشد و وابسته به نرخ ورودی یا محاسبات انجامشده باشد. به همین دلیل در مورد تاخیر با قطعیت نمیتوان نظری داد.
مقیاسپذیری این ابزار در درجهی اول وابسته به نحوهی دریافت ورودی داده و خروجی داده و محلهای میانی ذخیرهی داده میباشد. با فرض مقیاسپذیر بودن وابستگیهای خارجی ابزار که در بالا ذکر شد، در آن صورت خود ابزار به راحتی با افزودهشدن گرههای به کلاستر (به عنوان مثال برای افزایش توان پردازشی) به صورت افقی گسترش پیدا کند.
تنظیمات استاندارد برای اجرای این ابزار در روز صفر مناسب هستند و تقریبا با کمترین هزینه میتوان ابزار را اجرا نموده و به کار کردن و کسب تجربه پرداخت.
استفاده از این ابزار و ارتباط با آن توسط زبانهای برنامهنویسی متنوعی پشتیبانی میشود. همچنین این ابزار میتواند بر روی YARN هم سوار شود و کاملا با اکوسیستم Hadoop ادغام شود.
کارکرد اصلی ابزار پردازش داده است. ابزار یک چارچوب متنباز و موتور پردازش توزیعشده برای محاسبات دارای حالت (stateful) بر روی جریانهای داده نامحدود و محدود است.
ابزار برای اجرای برنامههای جریانی در هر مقیاسی طراحی شده است. برنامهها به هزاران وظیفه موازی تقسیم میشوند که به طور همزمان در یک خوشه از گرهها توزیع و اجرا میشوند. مکانیزم تقسیم کار توسط ابزار مدیریت میشود اما مکانیزم اجرای آن توسط گرههای خوشه میتواند توسط خود ابزار به صورت standalone یا توسط پیکربندی ابزارهای دیگر (مثل YARN و ...) مدیریت شود. علاوه بر این، ابزار به راحتی حالت (state) برنامه بسیار بزرگ را حفظ میکند. الگوریتم checkpoint که به صورت ناهمزمان (آسنکرون) و افزایشی اجرا میشود، حداقل تأثیر را بر تأخیرهای پردازش تضمین میکند و در عین حال ثبات حالت را دقیقاً یک بار (exactly-one consistency) تضمین میکند.
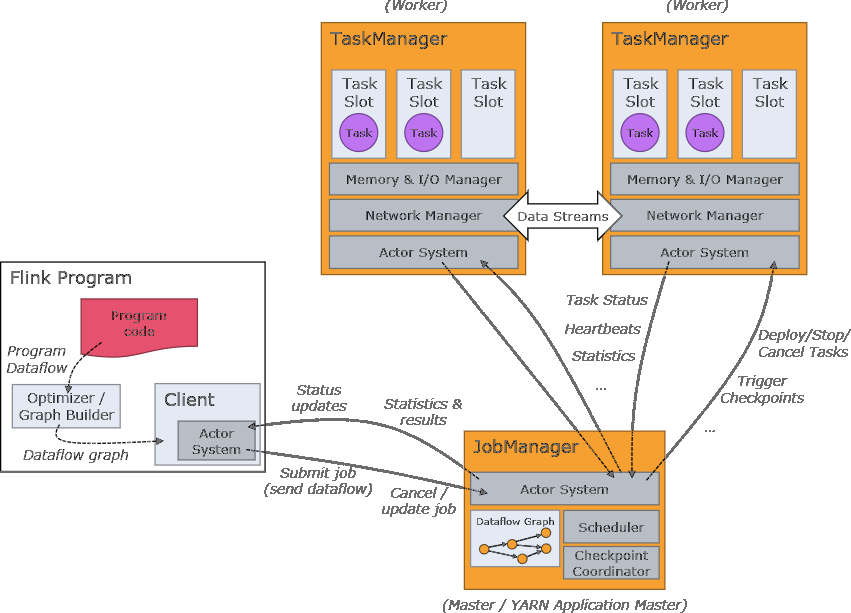
ابزار میتواند به صورت HA استقرار پیدا کند و شامل نقطهی شکست (Single Point of Failure) نمیباشد. البته در صورتی که برای مواردی مثل ذخیرهسازی checkpointها یا زمانبندی اجرای کارها (Scheduling) از ابزار خارجی استفاده شود (پیکبرندی به گونهای باشد که از قابلیتهای این ابزارها استفاده شود) در آن صورت دسترسپذیری ابزار وابسته به دسترسپذیری آن ابزارها نیز خواهد بود.
تحمل خطا ابزار برای مقاومشدن نسبت به خرابیها به صورت داخلی پیادهسازی شده است. برای این منظور ابزار هر از چند گاهی از طریق checkpoint وضعیت سامانه را ذخیرهسازی و حفظ میکند. نقاط checkpoint به ابزار امکان بازیابی وضعیت و موقعیتهای موجود در جریانها را برای بازیابی (recovery) از وضعیت ناموفق میدهد.
برنامههای Stateful Flink برای دسترسی به حالت محلی بهینه شدهاند. وضعیت کارها همیشه در حافظه حفظ میشود یا اگر اندازه حالت از حافظه موجود بیشتر باشد، در ساختارهای داده روی دیسک با دسترسی کارآمد حفظ میشود. به همین دلیل، کارها همه محاسبات را با دسترسی به حالت محلی، اغلب در حافظه، انجام میدهند که تأخیر پردازش بسیار پایینی را ایجاد میکند. ابزار با کنترل دورهای و ناهمزمان تلاش میکند تا تاثیر کمی بر روی تاخیر و توان پردازشی ایجاد کند.
به منظور رسیدن به کاراییهای بیشتر میتوان آن را با ابزارهای دیگر در موضوعات check-pointing و ورودی داده و زمانبندی کارها متصل کنید تا از کارایی بیشتری برخوردار شوید. (متناسب با امکانات فراهمشده توسط ابزارهای خارجی)
این ابزار پشتیبانی خوبی برای پارتیشنبندی و مقیاسبندی دارد. در صورتی که از ابزارهای دیگر مانند Yarn یا Mesos و ... برای پیکربندی زیرساخت اجرای عملگرها استفاده شود، مقیاسپذیری و دسترسپذیری وابسته به آن ابزارهای خارجی خواهد بود اما اگر از روش خوشه مستقل (standalone) استفاده شود، امکان فراهمسازی مقیاسبندی خوبی را فراهم میکند.
ابزار را میتوان بر روی ارائهدهندگان منابع مختلف مانند YARN، Apache Mesos و Kubernetes و همچنین به عنوان خوشه مستقل روی گرهها مستقر کرد. تعامل با آن برای پیادهسازی منطقهای برنامه میتواند مبتنی بر زبانهای برنامهنویسی Java/Scala صورت بگیرد.
ابزار برای ذخیرهسازی checkpointها با ابزارهای خارجی مختلفی میتواند تعامل داشته باشد. از نمونه این ابزارها میتوان به ابزارهای مدیریت صف مانند کافکا، Google Pub/Sub، RabbitMQ یا فضای فایلی مانند هادوپ، GFS، S3، NFS، Ceph اشاره کرد که امکان پیکربندیشدن به عنوان محل ذخیرهسازی را دارند.
به منظور تعامل با این ابزار امکانات رابط کنسولی فراهم شده است. ابزار به منظور پایش وضعیت کارها قابلیتهای زیر را فراهم نموده است:
کارکرد اصلی ابزار، پردازش داده با زبان SQL میباشد.
یک موتور جستجوی SQL منبع باز برای جستجو دادههای بزرگ است. اجرای پرسوجو بر روی دادههای نیمه ساختاریافته و برنامههای کاربردی کلانداده را پشتیبانی میکند، در حالی که هنوز اکوسیستم ANSI SQL، زبان پرس و جو استاندارد صنعت را فراهم میکند.
ابزار شامل یک محیط اجرای توزیع شده است که برای پردازش داده در مقیاس بزرگ ساخته شده است. در هسته این ابزار سرویس Drillbit قرار دارد که مسئولیت پذیرش درخواستهای کاربر، پردازش پرسوجوها و برگرداندن نتایج به کاربر را بر عهده دارد.
ابزار از ZooKeeper برای نگهداری وضعیت عضویت گرهها در کلاستر و اطلاعات سلامت سرویسها استفاده میکند. البته ابزار توانایی اجرا در هر محیط خوشهای توزیعشده را دارد و تنها پیشنیاز آن Zookeeper است.
کاربر (client) یک پرس و جو را ارسال میکند. هر سرویس (Drillbit) در خوشه میتواند درخواستهای کاربران را بپذیرد و مفهوم ارباب یا برده در معماری ابزار وجود ندارد. سپس سرویس پرس و جو را تجزیه میکند، آن را بهینه میکند و یک طرح پرس و جو توزیع شده ایجاد میکند که برای اجرای سریع و کارآمد بهینه شده است. سرویسی که پرسوجو را میپذیرد به گره محرک (driver) برای درخواست تبدیل میشود. این سرویس فهرست گرههای دیگر را از زوکیپر دریافت میکند و گرههای مناسب را برای اجرای قطعات طرح پرسوجوی مختلف برای به حداکثر رساندن محلیبودن دادهها تعیین میکند. سرویس محرک اجرای قطعات پرسوجو را بر روی گرههای جداگانه طبق برنامه اجرا زمانبندی میکند. گرههای مجزا اجرای خود را به پایان میرسانند و دادهها را به سرویس محرک برمیگردانند. سرویس محرک جوابهای بازگرداندهشده را در قالب جریان داده به کاربر باز میگرداند.
تصویر زیر نشاندهنده اجزای سرویس Drillbit است:
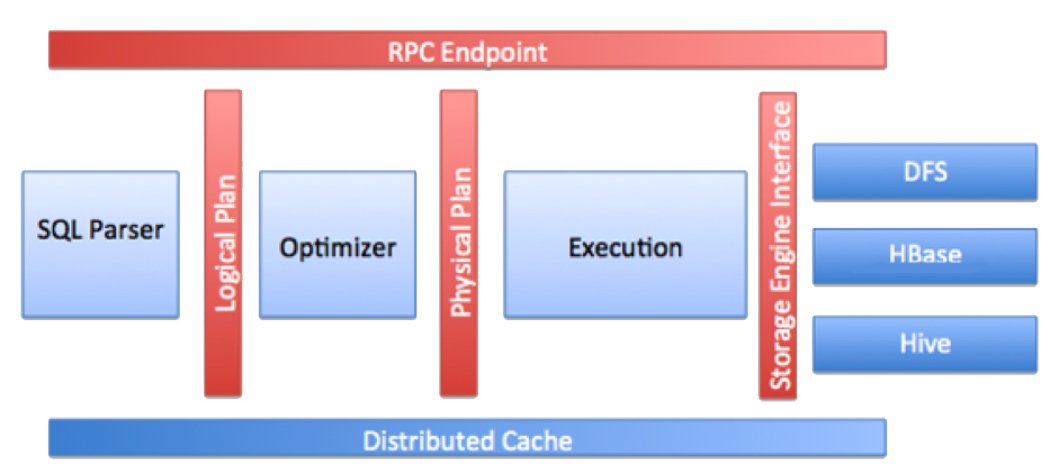
اجزای مهم این سرویس موارد زیر هستند:
با توجه به نبود مکانیزم master/slave و امکان افزایش تعداد سرویسها در خوشه، به راحتی امکان افزایش دسترسپذیری ابزار وجود دارد. همچنین در هنگام اجرای پرس و جوها، در صورت رخداد خطا در هر گره، اجرای آن را به گرههای دیگر منتقل میکند که سبب نمیشود نسبت به رخداد خطا تحملپذیر بوده و دسترسپذیری آن افزایش یابد. البته متناسب با نوع دادهای که برای کوئری انتخاب میشود (مثلا مخزن HDFS و ...)، تحمل خطای ابزار در برابر مشکلات وابسته به ابزار جانبی نیز خواهد بود.
این ابزار به راحتی با بالا آوردن یکسری سرویس (Drillbet) اجرا میشود و به راحتی توسط ابزار ZooKeeper مقیاس پیدا کرده و روی چندین گره بالا بیاید. ابزار برای شروع فرآیند اجرای پرس و جو نیازی به مشخصات طرح یا نوع برای دادهها ندارد. این ابزار ساختاردادهها را را در حین پردازش کشف میکند.
برخلاف سایر فناوریهای مانند پایگاهداده سنتی رابطهای، ابزار نیازی به ابرداده (metadata) متمرکز ندارد. به منظور پرس و جو از دادهها، کاربران نیازی به ایجاد و مدیریت جداول/نماها در یک مخزن ندارند و به همین دلیل به راحتی میتواند بر روی هر نوع دادهای سوار شده و مقیاس آن به راحتی کاهش یا افزایش پیدا کند.
کاربر (client) یک پرس و جو را از طریق روشهای JDBC، ODBC، رابط خط فرمان یا REST API ارسال میکند.
ابزار در کنار فایل محلی سیستم عامل از انواع دادههای NoSQL از جمله موارد زیر پشتیبانی میکند:
HBase، MongoDB، MapR-DB، HDFS، MapR-FS، Amazon S3، Azure Blob Storage، Google Cloud Storage، Swift، NAS, ...
کاربران تجاری، تحلیلگران داده میتوانند از ابزارهای استاندارد BI زیر برای تعامل با دادههای غیرمرتبط استفاده کنند. توسعهدهندگان میتوانند از REST API ساده ابزار در برنامههای سفارشی خود برای ایجاد داشبوردهای مفید استفاده کنند:
Tableau، Qlik، MicroStrategy، Spotfire، SAS, Excel, ...
ابزار یک معماری قابل توسعه را در همه لایهها، از جمله لایه افزونه ذخیرهسازی، لایه پرس و جو، بهینهسازی، اجرای پرس و جو و API های کاربر ارائه میدهد. هر لایه را برای نیازهای خاص میتوان سفارشی کرد یا لایه را به مجموعه وسیعتری از ابزار گسترش داد.
کارکرد اصلی ابزار پردازش دادههای روی سیستم منبعباز Hadoop میباشد. یک ابزار ذخیرهسازی داده در اکوسیستم Hadoop است که زبانی شبیه SQL را برای پرس و جو و تجزیه و تحلیل کلان داده ارائه میکند. انگیزه اصلی ایجاد ابزار، مسیر یادگیری سادهتر برای توسعه دهندگان و تحلیلگران کلانداده میباشد.
با توجه به اجرای Hive بر روی خوشه Hadoop، معماری این ابزار پیچیدگیهای کمی داشته و میتوان آن را به صورت خلاصه در تصویر زیر مشاهده نمود:
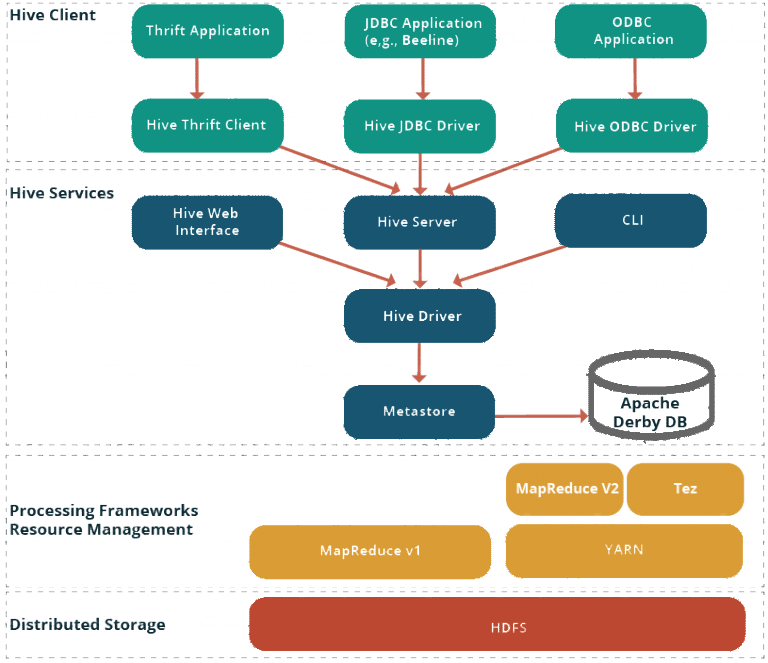
بخش کلایت: این ابزار از برنامههای نوشته شده در بسیاری از زبانها با استفاده از پروتکلهای مختلف به منظور ارتباط با سرور پشتیبانی میکند.
خدمات Hive: خدمات مختلفی مانند رابط کاربری وب، کنسول و ... برای انجام پرس و جو ارائه شده است.
چارچوب پردازش و مدیریت منابع و ذخیرهسازی توزیع شده: در داخل ابزار از چارچوب Hadoop MapReduce به عنوان موتور واقعی برای اجرای پرس و جوها استفاده میشود. از آنجایی که ابزار بر روی هادوپ نصب میشود، از HDFS زیرساخت هادوپ برای ذخیرهسازی توزیع شده استفاده میکند.
درایور (driver) پرس و جو را به کامپایلر ارسال میکند که در آن تجزیه، بررسی نوع و تحلیل معنایی با کمک طرحهای تعریفشده در metastore انجام میشود. در مرحله بعد، یک طرح منطقی بهینه شده در قالب DAG از MapReduceها تولید میشود. در نهایت موتور اجرایی این وظایف را به ترتیب وابستگیها با استفاده از زیرساخت هادوپ اجرا میکند.
بخش metastore به عنوان یک مخزن مرکزی برای ذخیره تمام اطلاعات فراداده موردنیاز ابزار استفاده میشود. این اطلاعات شامل ساختار جداول و پارتیشنها به همراه ستون، نوع ستون، نوع تبدیل فرمتها یعنی serializer و deserializer و ... میباشد. این بخش از دو واحد اساسی تشکیل شده است: سرویسی که دسترسی بخش را برای سایر سرویسهای ابزار فراهم میکند و پایگاهدادهای مستقل از HDFS که برای نگهداری اطلاعات فراداده استفاده میشود.
مدل دادهی استفاده شده در این ابزار اطلاعات دادهها را مبتنی بر 3 مفهوم زیر نگهداری میکند:
با توجه به امکانات ابزار امکان بالاآوردن چندین نسخه از سرور (server) ابزار وجود داشته که امکانات دسترسپذیری را فراهم میکند. با توجه به وابستگی کامل ابزار به زیرساخت هادوپ، مواردی مثل تحملپذیری، دسترسپذیری و ... ابزار کاملا مستقل نبوده و وابسته به نحوهی استقرار HDFS هستند.
از طریق استفاده از امکانات remote/local metastore قابلیت بالاآوردن چندین metastore را به صورت همزمان دارید که در نتیجه دسترسپذیری را افزایش میدهد. البته این metastore ها طبق توضیحات بالا از یک پایگاهداده جدا مستقل از HDFS استفاده میکنند. بدیهی است که دسترسپذیری ابزار به دسترسپذیری پایگاهدادهی استفادهشده نیز وابسته میباشد.
ذخیره اطلاعات فراداده ابزار در یک RDBMS به منظور کاهش زمان بررسیهای معنایی (semantic) در طول اجرای پرس و جو از مهمترین ویژگیهای این ابزار میباشد. همچنین کامپایلر درونی این ابزار به گونهای عمل میکند که پرس و جوهای ورودی را با توجه به اطلاعات فراداده به بهترین شکل (بهینهترین حالت) به برنامهی منطقی که درختی از MapReduce ها میباشد تبدیل کند. با این حال با توجه به وابستگی کامل ابزار به زیرساخت هادوپ، مواردی مثل کارایی اجرای پرس و جوها به قابلیتهای فراهمشده توسط زیرساخت HDFS وابسته میباشد که در بخشهای قبلی توضیح داده شده است.
این ابزار با توجه به معماری ارائهداده قابلیت استقرار چندین سرور (Hive server) و همچنین چندین metastore را فراهم نموده است. با این حال افزایش تعداد این استقرارها سبب افزایش مقیاسپذیری اجرای پرس و جو نمیشوند و تنها دسترسپذیری را افزایش میدهند. این ابزار از زمانبندهای هادوپ و زیرساخت هدوپ استفاده میکند و به همین دلیل مقیاسپذیری آن منطبق بر مقیاسپذیری زیرساخت HDFS میباشد.
ابزار از هر برنامه کاربری نوشته شده در جاوا، PHP، Python، C یا Ruby پشتیبانی میکند و میتواند این برنامهها را از طریق Thrift خود اجرا کند. همچنین ابزار رابطهای کنسول (CLI) و رابط کاربری وب را نیز برای ارتباط فراهم نموده است.
کارکرد اصلی ابزار پردازش داده میباشد. این ابزار یک پلتفرم برای تجزیه و تحلیل مجموعه دادههای بزرگ است که از یک زبان سطح بالا برای بیان برنامههای تجزیه و تحلیل دادهها تشکیل شده است.
معماری این ابزار با توجه به قرارگیری بر روی زیرساخت HDFS، ساده و به صورت زیر میباشد:
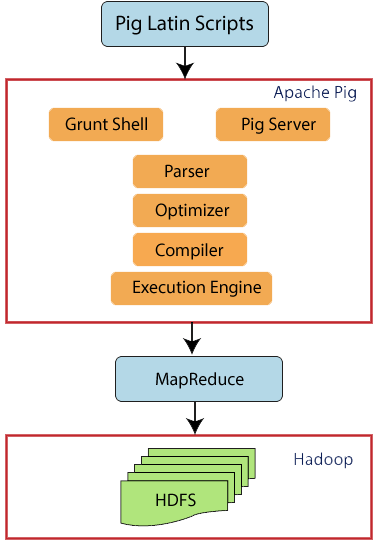
در ابتدا اسکریپت نوشتهشده به زبان Pig به محیط اجرای Pig توسط محیط تعاملی (shell) یا سرور ارسال میشوند. Pig Script ها در ادامه به بخش پارسر منتقل میشوند. پارسر پس از بررسی نوع و نگارش اسکریپت، یک DAG (گراف غیر چرخهای جهت دار) را خروجی میدهد. عملگرهای منطقی به صورت گرهها و جریانهای داده به صورت یالها نمایش داده میشوند. سپس DAG به بهینهساز ارسال میشود. بهینهساز فعالیتهای بهینهسازی مانند عملگرهای تقسیم، ادغام، تبدیل و ترتیب مجدد و ... را انجام میدهد. پس از فرآیند بهینهسازی، کامپایلر کد بهینه شده را در قالب یکسری MapReduce کامپایل میکند. کامپایلر وظیفه تبدیل کارهای Pig را به طور خودکار به MapReduce بر عهده دارد. MapReduce برای اجرا به موتور اجرا ارسال میشوند و بعد از اجرا نتیجه لازم متناسب با نیاز کاربر ذخیره یا نمایش داده میشوند.
توضیحات مبنی بر امکان بالاآوردن برنامه به صورت HA در مستندات نرمافزار یافت نشد. متاسفانه امکان اجرای چندین نسخه (instance) از مولفه وجود دارد اما هر نسخه به صورت مستقل عمل میکند و اطلاعات داخلی یک نسخه در صورت رخداد مشکل در اختیار نسخه دیگر نیست. اگر چه با توجه به وابستگی کامل ابزار به زیرساخت هادوپ، مواردی مثل تحملپذیری، دسترسپذیری و ... ابزار کاملا مستقل نبوده و وابسته به نحوهی استقرار HDFS میباشد، اما اگر خود برنامه قابلیت HA نداشته باشد، امکان دارد در هنگام ارسال MapReduce ها به زیرساخت هادوپ دچار مشکل شود. (حتی اگر زیرساخت هادوپ کاملا در دسترس باشد)
ابزار به طور خودکار وظایف و پرس و جوهای تعریفشده را قبل از اجرا بهینه میکند. برای این منظور از تکنیکهای مختلفی به صورت پیشفرض بهره میگیرد شامل موارد زیر (لیست کامل آنها و توضیحاتشان را میتوانید از این لینک مشاهده کنید)
PushUpFilter, PushDownForEachFlatten, ColumnPruner, MapKeyPruner, LimitOptimizer, ...
با توجه به وابستگی کامل ابزار به زیرساخت هادوپ، مواردی مثل کارایی اجرای پرس و جوها به قابلیتهای فراهمشده توسط زیرساخت HDFS وابسته میباشد که در بخشهای قبلی توضیح داده شده است.
این ابزار از زمانبندهای هادوپ و زیرساخت هدوپ استفاده میکند و به همین دلیل مقیاسپذیری آن منطبق بر مقیاسپذیری زیرساخت HDFS میباشد. البته خود برنامه بار محساباتی کمی دارد با این حال امکان بالاآوردن چند نسخه از ابزار به صورت مستقل وجود دارد که میتوان از این طریق برای کاهش بار روی یک نسخه اقدام کرد.
ابزار از زبان اسکریپت خاصی و مشخصی استفاده میکند. با این حال در صورتی که نیاز به این باشد که یکسری توابع شخصی برای توسعه قابلیتهای ابزار نوشته شود، امکان نوشتن این کدهای توسعهدهنده در قالب زبانهای مبتنی بر JVM مثل جاوا و اسکالا وجود دارد. همچنین ابزار تنها رابطهای کنسول (CLI) را فراهم نموده است.
کارکرد اصلی پردازش داده میباشد. Impala یک موتور پرس و جوی SQL با پردازش موازی انبوه، منبع باز، کاملاً یکپارچه است که به طور خاص برای استفاده از انعطافپذیری و مقیاسپذیری Hadoop طراحی شده است.
معماری این ابزار به صورت خلاصه از سه سرویس اصلی تشکیل شده است. معماری سطح بالای ابزار را در عکس زیر مشاهده میکنید:
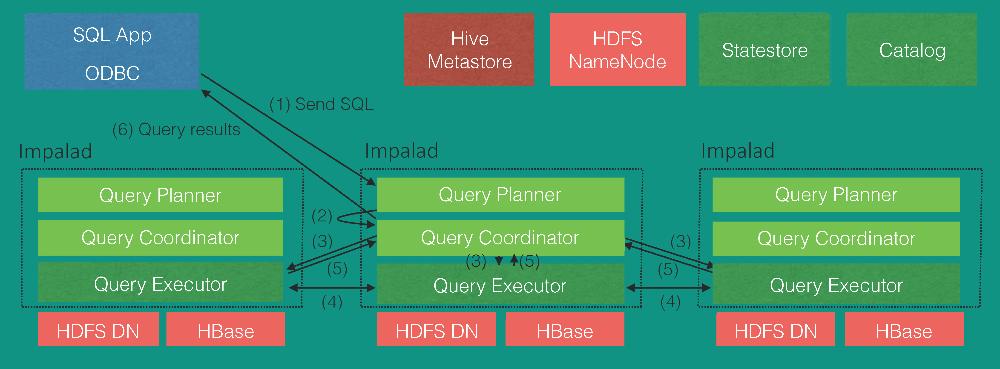
سرویس Impala daemon (impalad) به صورت همزمان دو وظیفه پذیرش پرسوجوها از سمت کاربر (client) و هماهنگی اجرای آنها در سراسر خوشه را بر عهده دارد. البته این سرویس در اجرای قطعات پرس و جو از طرف دیگر سرویسهای impalad موجود در خوشه نیز مشارکت میکند. هنگامی که این سرویس با مدیریت اجرای پرس و جو کاربر در نقش اول عمل میکند، به عنوان هماهنگکننده پرس و جو (Coordinator) عمل میکند. همه این سرویسها متقارن هستند و هر کدام ممکن است در همه نقشها (اجراکننده یا هماهنگکننده) عمل کنند. این ویژگی به تحمل خطا و تعادل بار کمک میکند.
یک سرویس impalad بر روی هر ماشینی در خوشه که datanode اجرا میکند، مستقر میشود. این به Impala اجازه میدهد تا از موقعیت دادهها استفاده کند و بلوکها را از سیستم فایل بدون نیاز به استفاده از شبکه بخواند.
دومین سرویس، سرویس نگهدارندهی وضعیت (Statestore) میباشد که یک سرویس برای اشتراک فراداده (metadata) از طریق مکانیزم انتشار/اشتراک (publish-subscribe) میباشد. فرادادههای خوشه در تمام سرویسهای Impala توسط این قسمت منتشر میشود. درواقع همه گرهها باید مثلاً نسخههای بهروز کاتالوگ سیستم و نمای اخیر عضویت خوشه (گرههایی که سالم بوده و توانایی مشارکت دارند) و ... داشته باشند تا درخواستها به درستی زمانبندی شوند. طراحی ابزار برای جلوگیری از RPC های همزمان و چالشهای آن، به گونهای انجام شده است تا بهروزرسانیها برای همه طرفهای علاقهمند ارسال شود. پیادهسازی این سرویس شبیه ترکیبی از Zookeeper و Kafka میباشد اما به صورت مستقل توسط ابزار توسعه و استقرار مییابد.
سومین سرویس، سرویس کاتالوگ (Catalog) میباشد که به عنوان مخزن کاتالوگ عمل میکند. تغییرات اعمالشده در کاتالوگ از طریق سرویس نگهدارندهی وضعیت پخش میشود. سرویس کاتالوگ اطلاعات را از ابزارهای دیگر (به عنوان مثال Hive Metastore یا HDFS Namenode) دریافت و آن اطلاعات را در یک ساختار کاتالوگ سازگار با Impala نگهداری میکند. این معماری به ابزار اجازه میدهد تا نسبت به ساختار ابزارهای دیگر بیاعتنا باشد و امکان اضافهکردن فرادادههای ابزارهای دیگر (مثلاً HBase) وجود داشته باشد. از آنجایی که کاتالوگها اغلب بسیار بزرگ هستند، فرادادهها در پسزمینه به صورت lazy بارگزاری میشوند.
در کنار موارد بالا ابزار از دو بخش اصلی frontend و backend تشکیل شده است. بخش frontend مبتنی بر زبان جاوا توسعه یافته است و بخش backend مبتنی بر زبان C++ توسعه یافته است. بخش forntend مسئول کامپایل متن SQL در طرحهای پرس و جو برای اجرا توسط سرویسهای ابزار است. کامپایل شامل تجزیه کننده SQL، بهینهساز پرس و جو مبتنی بر هزینه و ... است که همگی از ابتدا پیادهسازی شدهاند. (از ابزارهای دیگر استفاده نشده است) بخش backend قطعات پرس و جو را از frontend دریافت میکند و مسئول اجرای سریع آنها است. (طراحی این بخش متناسب با امکانات سختافزار مدرن میباشد)
تمامی سرویسهای impalad موجود در خوشه به دلیل قابلیت دریافت پرس و جو از سمت کاربر، شبیه هم بوده و به همین دلیل دسترسپذیری در زمینه ارسال پرس و جو به خوشه و اجرای آن کاملا بالا میباشد.
بخش نگهدارندهی وضعیت (statestore) هیچ ابردادهای را روی دیسک نگه نمیدارد و همه ابردادههای فعلی توسط مشترکین زنده به آن منتقل میشوند. بنابراین، در صورت راهاندازی مجدد این سرویس (به علت مشکل یا بعد از اعمال یک تغییر)، وضعیت آن در مرحله اولیه ثبتنام توسط مشترکان (سرویسهای impalad) بازیابی میشود. اگر دستگاهی که سرویس روی آن کار میکند از کار بیفتد، سرویس جایگزین میتواند در جای دیگری راهاندازی شود و مشترکان از این به بعد از آن استفاده کنند. ابزار به صورت خودکار مکانیزمی برای انتقال درخواستها به سمت سرویس جدید ندارد و معمولا از ابزارها و روشهای دیگر مثل تنظیمات DNS استفاده میکنند تا مشترکان را به طور خودکار به سرویس جدید متصل شوند.
بدیهی است که به دلیل قرارگیری این سرویس بر روی سرویسهای HDFS یا HBase و ...، دسترسپذیری این سرویس وابسته به سرویسهای نامبرده نیز میباشد.
ابزار به جای استفاده از RPCهای همزمان که دارای کندیها و چالشها هستند، از رویکرد انتشار/ اشتراک استفاده نموده است. این رویکرد البته شاید چالشهای دیگری داشته باشد اما تا حد خوبی توسط ابزار رفع شدهاند.
در زمینهی سرویس کاتالوگ، از آنجایی که اطلاعات فراداده دیگر ابزارها اغلب بسیار بزرگ هستند و دسترسی به جداول به ندرت یکنواخت است، سرویس کاتالوگ فقط برای هر جدولی که در راهاندازی پیدا میکند یک اسکلت کلی ایجاد میکند. فرادادههای جدول به صورت دقیقتر در پسزمینه بارگیری میشود. اگر جدول قبل از بارگیری کامل موردنیاز باشد، ابزار به صورت خودکار این را تشخیص داده و یک درخواست با اولویت را به سرویس کاتالوگ صادر میکند. این درخواست تا زمانی که جدول به طور کامل بارگیری شود سرویس را مسدود میکند.
در زمینهی اجرای کوئری، مکانیزمهایی برای تحلیل و بهینهسازی پرس و جو بیش از اجرا استفاده میکند. ابزار از زبان C++ برای بخش اجرای پرس و جو استفاده میکند و از تولید کد در زمان اجرا برای تولید مسیرهای کد کارآمد (با توجه به تعداد دستورالعملها) و سربار حافظه کوچک، به ویژه در مقایسه با سایر موتورهای پیادهسازی شده در جاوا استفاده میکند.
تمامی سرویسهای impalad موجود در خوشه، مشابه با یکدیگر بوده و هر کدام میتوانند به عنوان مدیریتکنندهی پرس و جو یا اجراکننده عمل کنند. به همین دلیل به راحتی میتوان با بالابردن تعداد سرویسها، مقیاس ابزار را برای پردازش و اجرای کوئریها افزایش داد.
در پیادهسازی ارائهشده توسط ابزار، تنها یک سرویس statestore در نظر گرفتهشده است و طبق ادعای ابزار برای کلاسترهایی با اندازههای کوچک تا میانه نیز کافی است. با این حال امکان بالا آوردن چند عدد از این سرویس برای تقسیم بار و مقیاسپذیری ممکن است.
یک موتور کاملاً جدید است که از ابتدا به زبان C++ و جاوا نوشته شده است و با استفاده از مولفههای استاندارد از جمله HDFS، HBase، YARN و ... انعطافپذیری Hadoop را حفظ میکند و میتواند اکثر فرمتهای فایل پرکاربرد مانند Sequence File، Parquet، Avro، RCFile و ... را بخواند.
از بیشترین استاندارها و دستورات موجود در حوزهی SQL پشتیبانی میکند. منطقهای سفارشی موردنیاز برنامه را میتوان از طریق توابع ساده یا تجمعی تعریفشده توسط کاربر (UDF) به زبانهای جاوا و C++ اضافه نمود.
تعامل با این ابزار برای اجرای پرس و جو از طریق رابط تعاملی (shell)، ارتباطات ODBC یا JDBC یا Hue قابل انجام است.
کارکرد اصلی واردنمودن یا خارجسازی داده میباشد. یک ابزار استاندارد، ساده، قوی، انعطافپذیر و قابل توسعه برای دریافت دادهها از تولیدکنندگان مختلف داده (مانند فایلهای گزارش، رویدادها، ...) و واردسازی آنها به یک مخزن داده متمرکز (معمولا Hadoop یا HBase) یا بلعلکس است.
معماری ابزار در عین سادگی مزیتهای فراوانی را به همراه آورده است. معماری این ابزار از یکسری عامل (Agent) تشکیل شده است. هر عامل از تعدادی ورودی داده (Source) دریافت میکند، دادهها را به یک یا چند کانال (Channel) ارسال میکند و تعدادی ارسالکننده (Sink) دارد که هر کدام بسته به نیاز به یک یا چند کانال وصل هستند و دادههای کانال را دریافت کرده و به مقصد بعدی (مخزن داده یا یک عامل دیگر به عنوان گره بعدی) ارسال میکنند. رخدادها که در ورودیها دریافت میشوند، به عنوان واحدی از جریان داده تعریف میشود که دارای بدنه بایتی (payload) و مجموعهای اختیاری از ویژگیها (headers) هستند. یک عامل یک فرآیند سیستمی مبتنی بر جاوا است که در ورودی خود رویدادها را دریافت و آنها را به مقصد بعدی (hop) ارسال میکند.
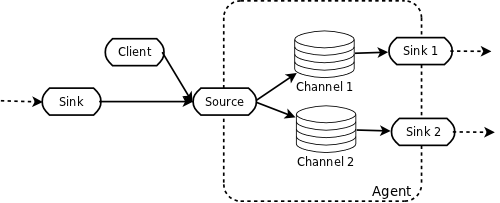
با توجه به این معماری و امکان سواردکردن عاملها به صوت زنجیرهای پشت سر هم، امکان ایجاد جریان دادههای متنوع از جمله موارد زیر وجود دارد:
انتقال بین فرستنده و دریافتکننده در تمامی قسمتهای جریان داده به صورت تراکنشی و ثبتی رخ میدهد و تا زمان عدم اطمینان از ارسال یک رویداد، فرآیند تکرار میشود.
معماری به منظور افزایش کارایی و فراهمسازی کابردهای مختلف، مفاهیم دیگری را از جمله موارد زیر فراهم نموده است:
ابزار به منظور مقاومبودن نسبت به مشکلات احتمالی در عاملها، مکانیزمی به نام پردازندههای خروجی (Sink Processors) فراهم نموده است. از طریق این مفهوم میتوان خروجیها را گروهبندی نمود. گروههای خروجی به کاربران این امکان را میدهند که چندین خروجی را در یک موجودیت گروهبندی کنند. گروهبندی خروجیها را میتوان به منظور ارائه قابلیتهای متعادلکننده بار (load balancing) در تمام خروجیهای داخل گروه یا برای دستیابی به مقاومکردن یک خروجی نسبت به خرابی موقت استفاده کرد.
همچنین در قسمت ورودی مربوط به عاملها، میتواند با اجرا کردن چندین عامل به منظور دریافت ورودی (جریان داده Fan-in) ورودی داده را نیز نسبت به خطاها مقاوم نمود.
البته دسترسپذیری کامل ابزار وابسته به نحوهی دریافت ورودی، نوع کانالهای استفاده شده و نحوهی ارسال خروجی میباشد. به عنوان مثال در صورتی که فرستنده از روش UDP برای ارسال ورودی استفاده کند، در صورت رخداد هر مشکل و عدم دریافت بسته و همچنین عدم ارسال دوباره از سمت فرستنده، بسته گم خواهد شد. یا در حالت استفاده از کانال in-memory در صورت رخداد خطا در عامل، اطلاعات درون حافظه از بین خواهد رفت. به همین دلیل دستیابی به دسترسپذیری کامل امکانپذیر است به شرطی که تنظیمات کانال و نحوهی دریافت و ارسال به مخزن خروجی با نوعهای مناسبی تنظیم شوند.
برخلاف استفاده از روشهای ساده مانند put کردن در مخزن دادهی HDFS، ساخت فایلهای Avro و ... که هر کدام تنظیمات فراوانی و موازیسازی برای رسیدن به کارایی خوب لازم دارند، با استفاده از معماری ابزار و اجرا کردن چند عامل یا استفاده از قابلیتهای دستهبندی (batch) ابزار میتوان به کارایی خوبی در نوشتن دادهها در خروجی دست یافت. همچنین بسته به نوع کانالهای میانی میتوان از مزیتهای کارایی ابزارهای میانی نیز استفاده نمود. (به عنوان مثال کانال از نوع کافکا مزایا و کاراییهای کافکا را نیز فراهم میکند)
معماری ابزار به گونهای است که به راحتی میتوان به صورت افقی (horizontal) مقیاس برنامه را افزایش داد. افزایش یا کاهش مقیاسپذیری به راحتی و از طریق افزودن یا حذف یکسری عاملها انجام میشود.
تنظیم و مدیریت وضعیت و ساختار جمعکنندهها و فرستندهها به راحتی و از طریق یکسری فایل کانفیگ صورت میگیرد که استفاده از ابزار را ساده و لذت بخش میکند. ابزار به صورت پیشفرض از لیست فراوانی از ورودیها و خروجیها پشتیبانی میکند که لیست کامل آنها را از این لینک میتوانید مشاهده کنید. به عنوان نمونه:
Sources: Avro, Thrift, JMS, Kafka, NetCat, Sequence Generator, Syslog, HTTP Source, ...
Channels: Memory, JDBC, Kafka, File, ...
Sinks: HDFS, Hive, Avro, Thrift, File Roll, HBase, Elastic Search, Kafka, ...
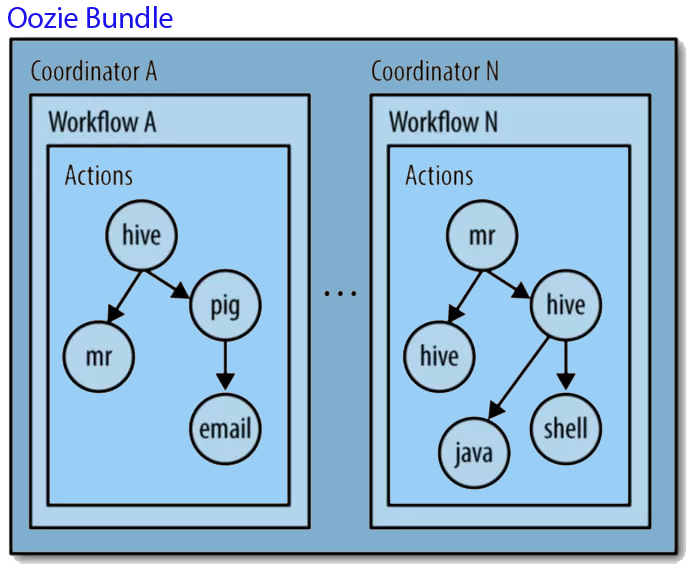
کارکرد اصلی زمانبندی اجرای جریان کارها میباشد. در موارد بلادرنگ، یک کار به کارهای دیگر وابسته است، مانند خروجی یک کار MapReduce ممکن است برای پردازش بیشتر به Hive job منتقل شود. همچنین برنامهریزی مجموعهای از کارها میتواند بر اساس زمان مانند روزانه، هفتگی، ماهانه یا بر اساس در دسترس بودن داده باشد. ابزار این امکان را در اختیار شما قرار میدهد تا به راحتی این نوع سناریوها را مدیریت کنید.
مدلهای موجود در ابزار در قالب سه مفهوم قرار میگیرند:
معماری ابزار به سادگی تصویر زیر میباشد (در تصویر نحوهی در دسترس بودن بالا نیز نمایش داده شده است):
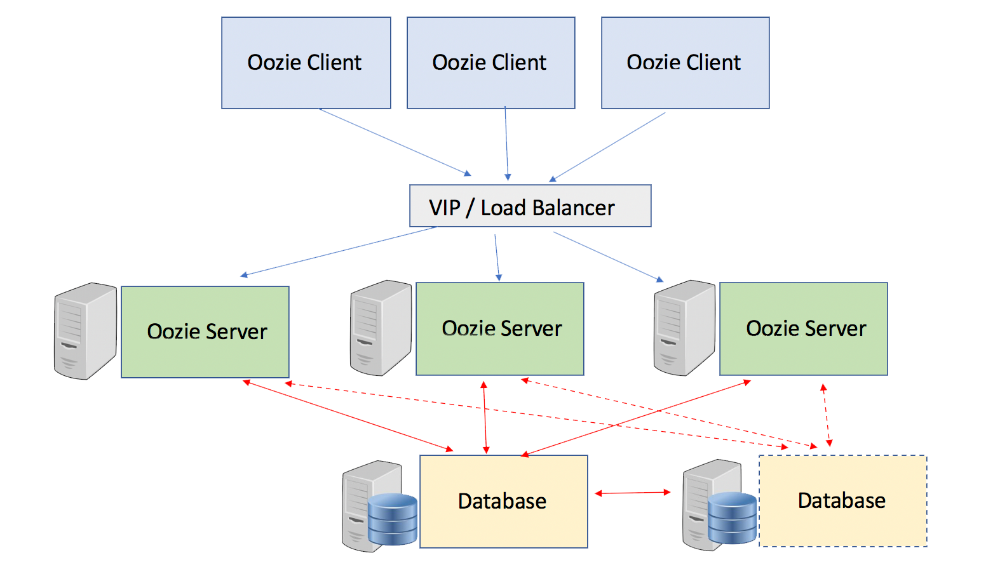
یک سرور Oozie به عنوان برنامه وب جاوا که در سرور Tomcat میزبانی میشود مستقر میشود و تمام اطلاعات مرحلهای مانند تعاریف گردش کار، کارها و ... در یک پایگاه داده ذخیره میشوند. بخش کاربر (کلاینت) Oozie در واقعی کاربری است که به منظور تعریف گردش کار، اجرای یک کار، تنظیم و ... به سرور متصل میشود.
دسترسپذیری بالا در ابزار از طریق بالاآوردن چندین نسخه از برنامه به صورت همزمان انجام میشود. تمامی این نسخهها برای مشاهدهی یک وضعیت یکسان و ارتباط با یکدیگر، به یک پایگاهدادهی یکسان متصل میشوند. (بدیهی است که برای رسیدن به حداکثر دسترسی و حذف نقطهی شکست، لازم است پایگاه داده نیز به صورت دسترسپذیر تنظیم و اجرا شود)
همچنین خود ابزار هیچ وضعیتی را در زمان اجرا در مموری نگه نمیدارد و اجرای تمای کارهای تعریفشده توسط کلاسترهای دیگر (مانند Hadoop، Hive، Spark و ...) انجام میشود. به همین دلیل در عمل دسترسپذیری کامل این ابزار وابسته به تنظیم درست وابستههای زیرساختی ابزار میباشد.
با توجه به شیوهی طراحی ابزار، میزان منابع مصرفی سرور بسیار کم میباشد و به همین دلیل به راحتی با حداقل منابع، بهترین عملکرد را خواهد داشت. البته بدیهی است که کارایی این ابزار وابسته به پایگاهدادهی استفادهشده، نوع کارها و تنظیمات مربوط به خوشههای اجراکنندهی کارها میباشد که در بخشهای قبلی توضیح داده شدهاند.
ابزار به راحتی در مقیاس افقی (horizontal) قابل توسعه است. اجرای کار خاص در فرآیند سرور ابزار نیست. سرور تنها مسئول اجرای گردش کار است، در حالی که اقدامات در گردش کار، مانند MapReduce یا جاوا، توسط خوشهای دیگر اجرا میشوند. سرور تنها مسئول استعلام وضعیت اجرا و نتایج این اقدامات است، بنابراین بار سرور کم میباشد. با این حال اگر تعداد گردش کار ارسالی توسط کاربران افزایش یافت، به سادگی میتوان تعداد سرورهای Oozie را اضافه کرد. وضعیت کار در پایگاه داده رابطهای حفظ میشود. از آنجایی که وضعیت کار به جای حافظه یک ماشین، در پایگاه داده ذخیره میشود، بسیار مقیاسپذیر است.
پایگاه داده مربوط به ذخیرهسازی وضعیت ابزار میتواند انوع مختلفی از پایگاهدادهها از جمله موارد زیر باشد:
Apache Derby، HSQL، Oracle، MySQL, PostgreSQL, ...
همچنین بخش کلاینت به منظور اتصال به سرور میتواند از مکانیزمهای مختلفی مانند HTTP و رابط کاربری وب، REST API، رابط تعاملی (CLI) و ... استفاده کند.
ابزارهای فراونی در این زمینه موجود هستند و تنها بخشی از آنها بررسی و تحلیل شدند. اطلاعات دقیق فنی این ابزارها، تعاملات آنها، ویژگیهای آنها و ... همه در بخشهای قبلی قابل مشاهده است. برای هر ابزار میتوانید با مطالعه همان ابزار به اطلاعات خلاصهای در مورد جنبههای مختلف معماری آن برسید. با این حال اگر نیاز داشته باشید که یک یا چند ابزار را از نظر «تعاملپذیری» مقایسه کنید، میتوانید توضیحات مربوط به این بخش را برای هر کدوم از دو ابزار مطالعه کنید و مقایسه کنید. به همین دلیل با توجه به این که امکان مشاهدهی کامل تمامی اطلاعات ابزار یا مقایسه یکسری ویژگیهای ابزارهای مختلف با یکدیگر وجود دارد، در ادامه تلاش است که بر اساس چند رویکرد خاص و توضیحات قبلی، دستهبندیهایی را ایجاد کنیم.
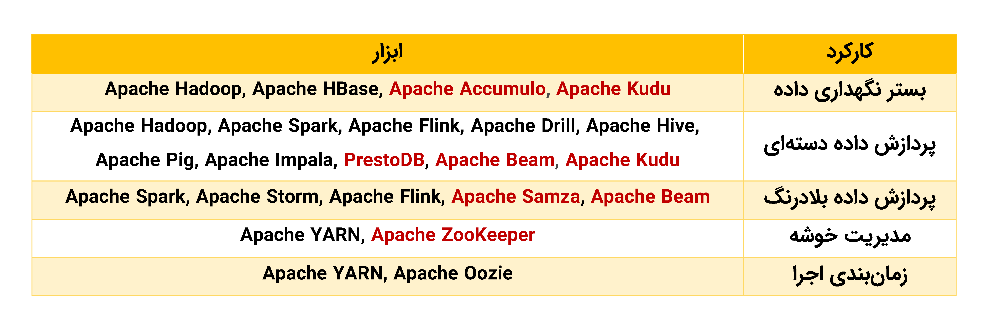
مهمترین و شاید متمایزترین ویژگی بین ابزارهای بررسیشده، کارکرد ابزار میباشد. ابزارها هر کدام یک کارکرد اصلی داشته و در عین حال از چندین کارکرد دیگر نیز پشتیبانی میکردند. به همین دلیل در جدول زیر دستهبندی مربوط صورتگرفته برای کارکردهای مختلف را مشاهده میکنید. در این جدول نام یک ابزار میتواند در چندین سطر مشاهده شود که نشاندهندهی پشتیبانی ابزار از کارکردهای مختلف میباشد. همچنین بخشی از ابزارها به دلیل حجم بالای مقاله مورد بررسی دقیق قرار نگرفتند اما بر اساس یه جستجوی ساده، دستهبندی آنها مشخص شده و با رنگ قرمز مشخص شدهاند. (البته دقت این روش کم بوده و ممکن است ابزار کارکردهای دیگری هم داشته باشد که در نظر گرفته نشده باشد)
این ابزارها در زمانهای مختلفی ایجاد شده و ممکن است این پنداشت وجود داشته باشد که ابزارهای جدید نسبت به ابزارهای قدیمی رویکرد بهتری داشته باشند. با این حال خوب است که بدانیم محبوبیت این ابزارها طبق بررسی صورتگرفته به صورت زیر میباشد (معیار بررسی میزان محبوبیت مخزن توسعه میباشد):
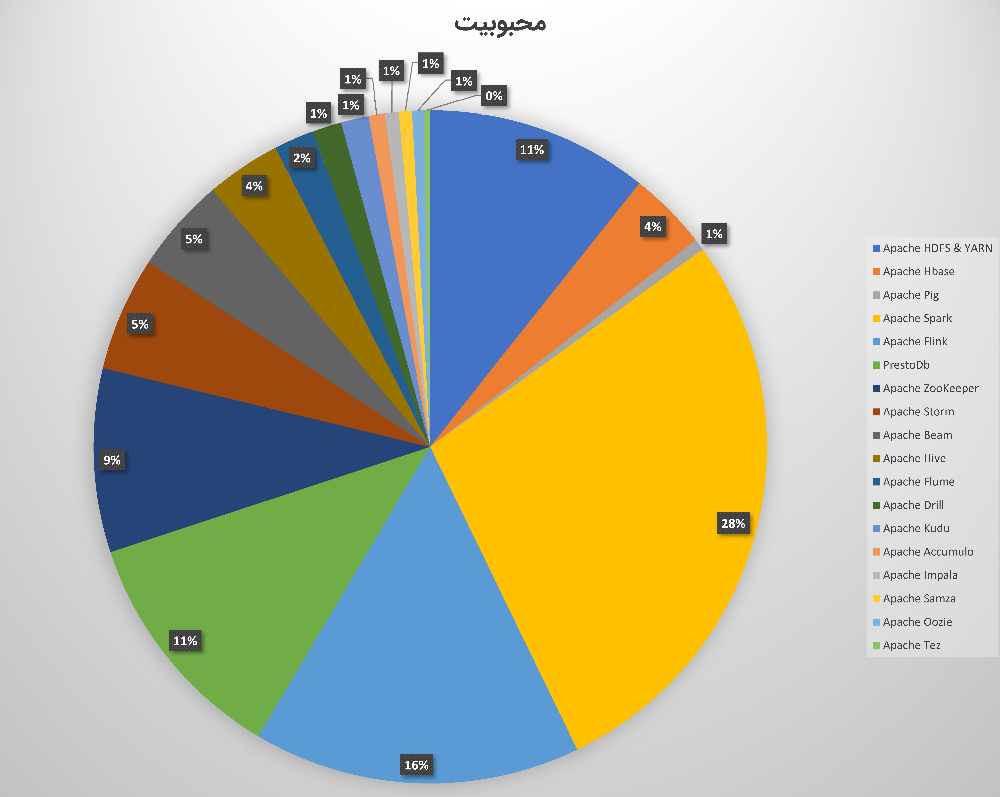
همانطور که مشاهده میشود ابزارهای Apache HDFS & YARN، Apache Spark و Apache Flink جزو مواردی هستند که محبوبیت بسیار زیادی دارند. این در حالی است که این موارد معمولا بهترین عملکرد خود را در کنار ابزارهای دیگر دارند و همراه با آن استفاده میشوند. تقریبا این ابزارها با توجه به community فعالی که دارند در حال توسعه و پیشرفت بوده و روز به روز بر محبوبیت آنها افزوده میشود.
نکتهی جالب دیگر در این مورد ابزارها بررسی زمان انتشار اولین نسخهی رسمی آنها میباشد. نمودار زمانی میتواند نکات جالب دیگری را در مورد این ابزارها نسبت به نمودارهای قبلی نشان دهد.
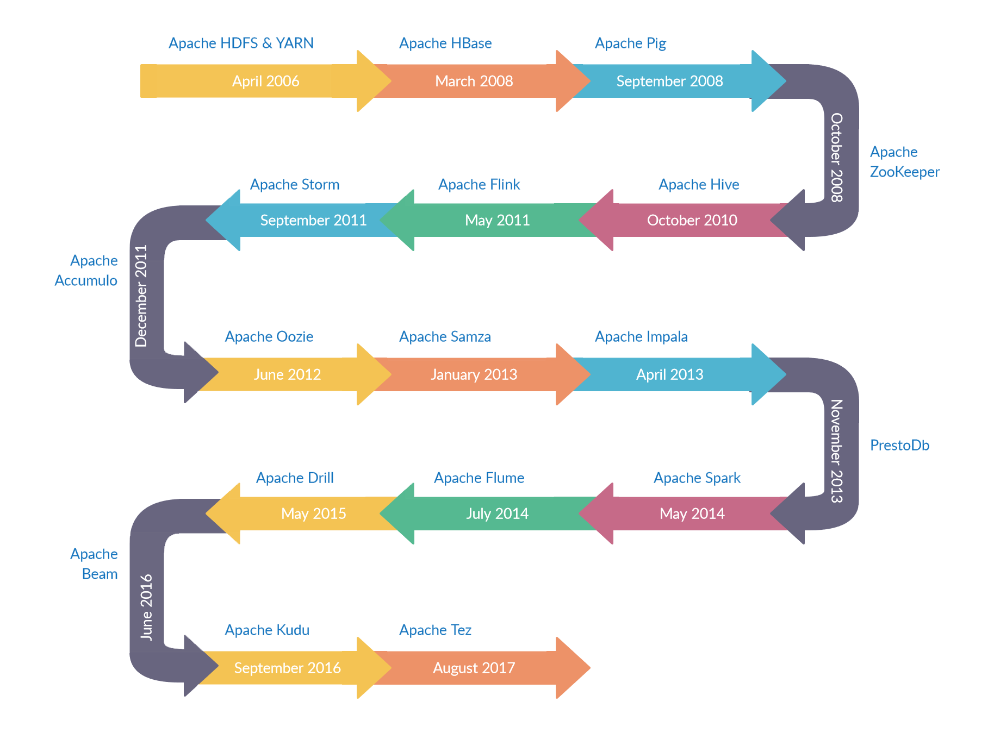
همانطور که در این نمودار مشاهده میشود، ابزار Apache HDFS & YARN که جزو محبوبترین ابزارها نیز بود، خوب جزو پیشگامان و اولینها در حوزهی پردازش داده میباشد. این در حالی است که ابزار Apache Spark که محبوبیت فراوانی داشت در سال 2014 (تقریبا 8 سال بعد) منتشر شده است. همچنین ابزار معروف دیگر یعنی Apache Flink نیز در سال 2011 (تقریبا 5 سال بعد) منتشر شده است. در کنار هم قرار دادن نمودار زمانی انتشار ابزارها و نمودار محبوبیت آنها نشان میدهد که هر ابزاری مورد قبول جامعه قرار نمیگیرد و اگر چه امروزه تکنولوژی پیشرفتهای فراوانی کرده است، اما ابزارهای قدیمی خود را به خوبی با تکنولوژیهای جدید همگام کردهاند و به همین دلیل حس نیاز به ابزاری جدید برای سازگاری با معماریهای جدید خیلی کم دیده شده است. (با توجه به نبود ابزارهای خیلی قوی جدید که در چند سال اخیر منتشر شده باشد)
در کنار موارد بالا خوب است که با توجه بررسیهایی که در بخشهای قبلی انجام شده است، گراف وابستگی/تعامل این ابزارها با یکدیگر را نیز بررسی کنیم.
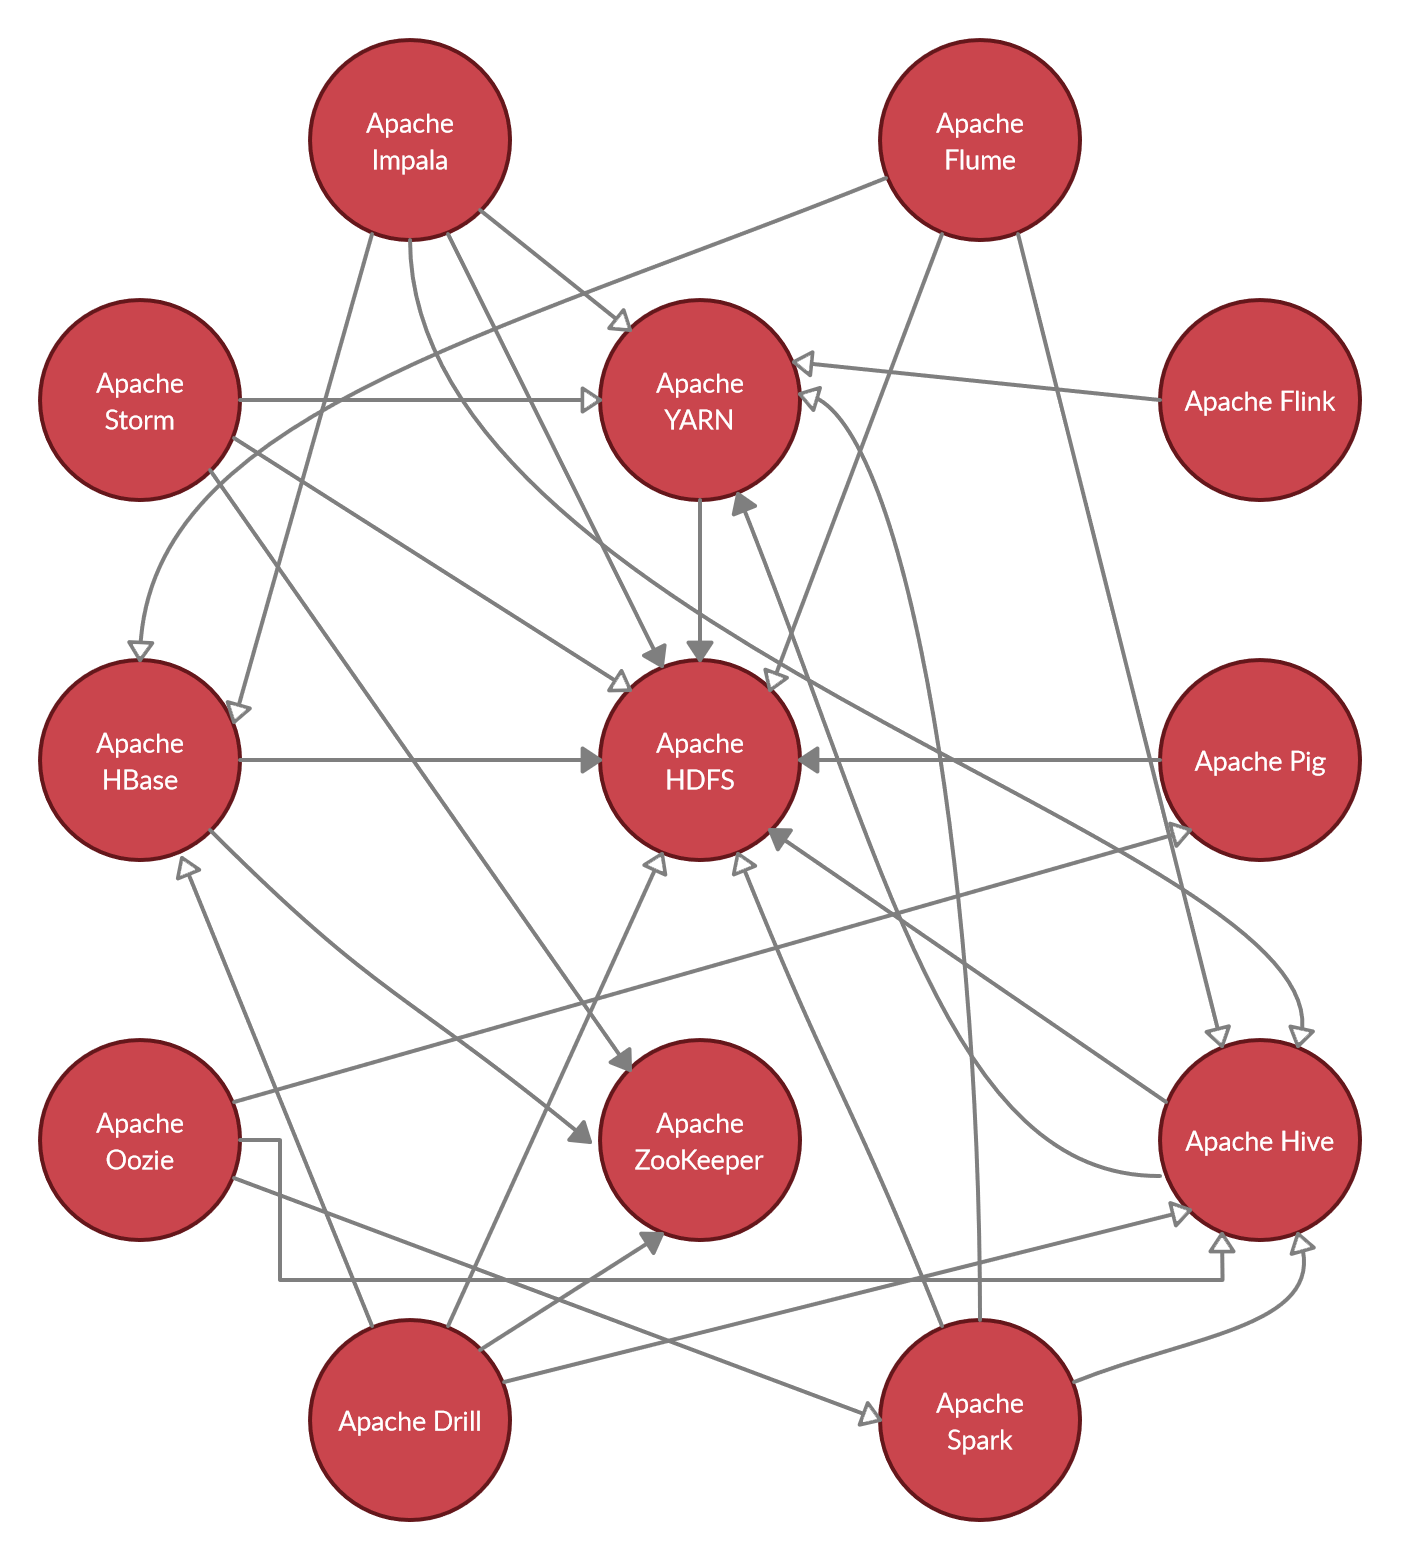
در این گراف که در تصویر بالا مشاهده میکنید، هر کدام از ابزارهای بررسیشده به صورت یک گره هستند و ارتباط میان گرهها، وابستگی/تعامل ابزارهای را نشان میدهد. گراف به صورت جهتدار بوده و به همین دلیل وجود یال جهتداری از A به B نشاندهندهی وابستهبودن/تعاملداشتن یک طرفه از سمت A به B میباشد. گرهها دارای دو حالت میباشند.
این گراف نیز به ما نشان میدهد میزان استفادهشده/تعاملپذیری ابزار Apache HDFS & YARN بسیار زیاد میباشد که حاکی از قدرت این ابزار میباشد. همچنین برخی ابزارهای مثل Hive اگر چه امروزه محبوبیت کمی دارند اما تعاملپذیری بالایی دارند که امکان مهاجرت را برای سازمانها ساده میکنند. (مثلا سازمان از ابزار محبوبتری استفاده کند اما در عین حال مشابه قبل از آن استفاده کند) البته شما میتوانید با قراردادن این نمودار در کنار دیگر نمودارها و تحلیلهای آنها به نکات جالبی دیگری نیز برسید!
با این حال همانطور که مشاهده میکنید با توجه به معیارهای مختلف بیانشده در بخشهای قبلی و اطلاعات ارائهشده در این بخش، ابزاری همهکاره به منظور رفع همهی نیازمندیها وجود دارد. هر کدام از ابزارها برای کارکردهایی خاص با ویژگیهای خاص ارائه شده و بدون محدودیت نیستند. همچنین روز به روز تکنولوژی در حال پیشرفت میباشد و شرکتهای بیشتری در این حوزه ابزارهای خود را متنباز کرده تا توسعه آنها سرعت بیابد. به همین دلیل با توجه به این که نیاز شما در چه زمینه میباشد و به دنبال چه نوع کارهایی هستید، انتخاب شما متفاوت خواهد بود. در این مقاله تلاش شده است تا به صورت خلاصه و از نگاههای مختلف ابزارها بررسی شوند تا در زمان کوتاهی دید خوبی به شما بدهند. امیدوارم که توانسته باشید تصمیم خود را گرفته باشید!
این مطلب، بخشی از تمرینهای درس معماری نرمافزار در دانشگاه شهیدبهشتی است.


