
علم را با نوشتن در بند كشيد - پيامبر (ص)
حتی قبل از ساخت کامپیوتر ها، انتقال اطلاعات مسئله مهمی بود. اوایل به این صورت بود که هر کسی که اطلاعات رو رد و بدل میکرد، از روش خودش برای این کار استفاده میکرد.
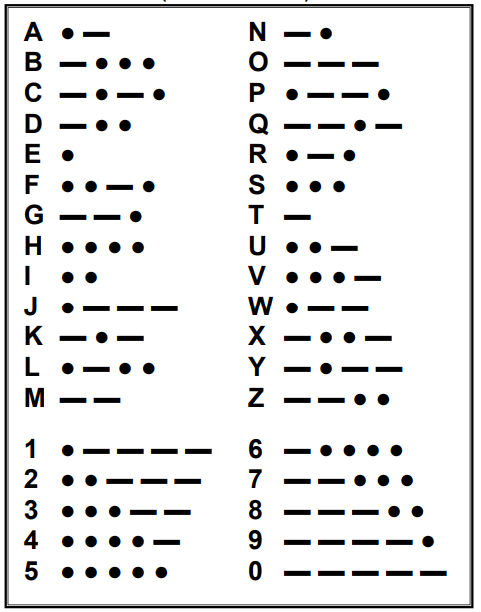
بعد ها استانداردی به نام کد morse code اومد. به این صورت بود که فقط آوای بلند ( - ) و کوتاه ( . ) داشت.
نوع لاتینش فقط شامل حروف انگلیسی ( بین بزرگ و کوچیک فرقی نمیذاشت ) و اعداد میشد. برای فاصله بین کلمات هم ی مدتی صبر میکردن.
توی این سایت میتونید متن تون رو بنویسید و morse code اش رو به صورت شنیداری و تصویری تحویل بگیرید.
بعد ها با استفاده بیشتر کامپیوتر ها، نیاز به ذخیره سازی این اطلاعات رو کامپیوتر ایجاد شد. یکی از اولین روش ها برای اینکار، Baudot Code بود که شامل حروف انگلیسی ( بازم بین بزرگ و کوچیک فرقی نمیذاشت ) و اعداد و چند تا کاراکتر دیگه مثل فاصله و چند تا کاراکتر نگارشی مثل ویرگول(،) و سمی کالن(;) میشد. این کد که به صورت باینری (0 و 1) ذخیره میشد، شامل 5 بیت بود و کلا 32 تا کاراکتر رو پشتبانی میکرد.
و بعد ASCII یا American Standard Code for Information Interchange اومد. فرقش با Baudot Code این بود که بجای 5 بیت از 7 بیت استفاده میکرد. بازه بزرگ تر 7 بیتی این قابلیت رو بهش داده بود که بین حروف بزرگ و کوچیک لاتین فرق بزاره و هردو رو پشتیبانی کنه. علاوه بر اینها، این روش از کاراکتر های نگارشی بیشتری مثل نقل قول(") و مد(~) و براکت( [ ] و { } ) … پشتیبانی میکرد.
ولی باز ی مشکل داریم، حروف غیر لاتین چی میشن پس؟ قبلا به این صورت بود که هر زبونی استاندارد خودش رو میساخت. مثلا توی آلمان، چیزی مثل ASCII ساخته بودن که فقط شامل حروف آلمانی بود.
تا اینکه تصمیم بر این گرفته شد که برای هر کاراکتر ی کد مجزا اختصاص بدن، طوری شامل همه حروف زبان ها و کاراکتر های پر استفاده باشه. اسمش رو گذاشتن Unicode.
این استاندارد جدید طی سال های متوالی آپدیت شده و زبان ها و قابلیت های جدیدی بهش اضافه شده و حتی از emoji هم پشتیبانی میکنه.
( البته اینم بگم که unicode اولین استاندارد نیست، ولی کامل ترینه )
بیشتر emoji ها مثل بقیه کاراکتر ها هستن که یک کد دارن. ولی بعضیاشون یک دنباله از کد های کاراکتری unicode هستن. ( لیست تمام emoji های پشتیبانی شده توی آخرین ورژن unicode یعنی ورژن 15 که همین سال 2022 معرفی شده رو از اینجا ببینید )
مثلا ایموجی مرد نقاش (??) سه تا کد داره "1F468 200D 1F3A8" که یعنی "ایموجی مرد(?) + کاراکتر خالی + ایموجی لوح نقاشی(?)"
فضای Unicode کلا 1,114,112 تا کاراکتر جا داره که به چند روش زیر میتونه ذخیره بشه:
روش اول ( UTF-8 ) پر استفاده ترین روش هست. که توی ادامه کمی در موردش توضیح میدم. مزیت این روش نسبت به بقیه، کم حجم تر بودنشه.
بالاتر گفتم که توی روش UTF-8 هر کد به صورت 1 تا 4 بایت ذخیره میشه. نحوه دقیق ذخیره سازی اش به این صورته:
هر بایت از اون محتوا رو نگاه میکنیم، اگر
برای نمونه من متن زیر رو بهتون به صورت باینری نشون میدم:
English فارسی ?? ∆∫
واقعیت:
کد های Unicode رو به صورت U+hhhh مینویسن ( که اون h جای رقم بر مبنای 16 یا hex هست )
01000101 :: E (U+00045)
01101110 :: n (U+0006E)
01100111 :: g (U+00067)
01101100 :: l (U+0006C)
01101001 :: i (U+00069)
01110011 :: s (U+00073)
01101000 :: h (U+00068)
00001010 :: \n (U+0000A)
11011001 10000001 :: ف (U+00641)
11011000 10100111 :: ا (U+00627)
11011000 10110001 :: ر (U+00631)
11011000 10110011 :: س (U+00633)
11011011 10001100 :: ی (U+006CC)
00001010 :: \n (U+0000A)
11110000 10011111 10010010 10101001 :: ? (U+1F4A9)
11110000 10011111 10100100 10100011 :: ? (U+1F923)
00001010 :: \n (U+0000A)
11100010 10001000 10000110 :: ∆ (U+02206)
11100010 10001000 10101011 :: ∫ (U+0222B)
کاراکتر n\ به معنی خط بعد هست
کدی که باهاش خروجی بالا رو تولید کردم میتونید اینجا ببینید
زبون های برنامه نویسی از نظر آگاهی به Unicode به 2 دسته آگاه و ناآگاه تقسیم میشن.
معمولا زبون های سطح سیستم ناآگاه هستن ولی زبون های سطح بالا آگاه هستن.
توی ادامه تفاوت هاشون رو توی چند تا سناریو توضیح میدم.
فرض کنید که یک emoji مثلا ? رو به صورت رشته ( string ) توی یک مغیر ذخیره کردید و حالا میخواید اندازه اون رشته رو بدست بیارید:
فرض کنید که متن "سلام" رو به صورت رشته ( string ) توی یک مغیر ذخیره کردید و حالا میخواید کاراکتر دوم رو با حرف فاصله جایگزین کنید.
فرض کنید که میخواید متن "?️??" که شامل 3 تا ایموجی پرچم است رو برعکس کنید.
what character encodings were used before 1963? - Super User
ASCII (American Standard Code for Information Interchange)
UTF-8, UTF-16, and UTF-32 - Stack Overflow
UTF-8 :: Jenkov


