
Jev یک «مدل تصمیمگیری» است، نه یک مدل زبانی بزرگ. این تمایز، هسته اصلی ماجراست. در جایی که یک LLM باید متنی تولید کند و بعد شما آن متن را parse کنید تا بفهمید مدل چه تصمیمی گرفته است، Jev مستقیماً خودِ تصمیم را بهصورت تایپشده و همراه با احتمال برمیگرداند.
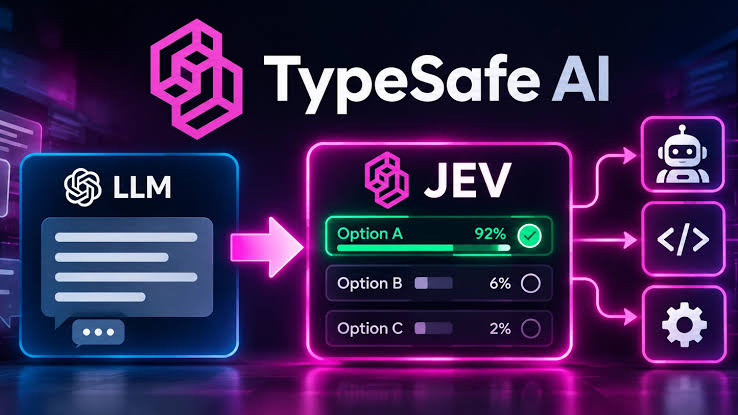
بخش بزرگی از کارهایی که امروز به LLM سپرده میشود، در واقع «تصمیمگیری» است، نه «نوشتن». یک agent باید تصمیم بگیرد کدام tool را صدا بزند. یک سیستم پشتیبانی باید تیکت را به تیم درست route کند. یک گردشکار امنیتی باید تشخیص دهد آیا ورودی کاربر یک حمله prompt injection است یا خیر. اینها همه سؤالاتی با پاسخ محدود هستند.
LLM برای این کار ساخته نشده است. یک LLM ابتدا باید دهها یا صدها token متن تولید کند، سپس شما با کد آن متن را parse کنید تا به یک مقدار قابل استفاده برسید. این چرخه هم کند است، هم گران، و هم شکننده؛ چون parsing ممکن است شکست بخورد. TypeSafe AI این مسئله را نوعی «عدم تطابق» میداند: شما یک سیستم تولید متن را مجبور میکنید ساختار تولید کند، و بعد آن ساختار را دوباره به چیزی تبدیل میکنید که کدتان بتواند به آن تکیه کند.
Jev که در ۱۵ سپتامبر ۲۰۲۶ بهصورت عمومی عرضه شد، اولین «System One Model» شرکت TypeSafe AI است. تفاوت بنیادین آن با LLM را میتوان در چند محور توضیح داد:
از نظر خروجی: LLM متن تولیدی برمیگرداند، اما Jev یک تصمیم تایپشده بههمراه توزیع احتمال برمیگرداند.
از نظر سرعت: LLM معمولاً در مقیاس ثانیه پاسخ میدهد، اما Jev حدود ۲۰۰ میلیثانیه زمان میبرد.
از نظر هزینه: TypeSafe ادعا میکند Jev در گردشکارهای تصمیمگیری حدود ۴۴۴ برابر ارزانتر از LLM است.
از نظر کاربرد: LLM برای مکالمه و تولید محتوا مناسب است، اما Jev برای classification، routing، ranking و guardrail طراحی شده است.
TypeSafe ادعا میکند Jev در مقایسه با LLM روی گردشکارهای System One، ۱۹۳.۶ برابر سریعتر و ۴۴۴.۶ برابر ارزانتر است. البته این اعداد به نوع گردشکار بستگی دارد، اما جهتگیری کلی روشن است: وقتی خروجی موردنیاز شما یک «برچسب» یا «امتیاز» است، تولید متن آزاد اتلاف منابع است.
نامگذاری TypeSafe مستقیماً از کتاب «تفکر، سریع و کند» دنیل کانمن وام گرفته شده است. کانمن دو سیستم شناختی انسان را از هم جدا میکند.
سیستم ۱ سریع، شهودی، خودکار و کمهزینه است. شما بلافاصله میفهمید یک چهره آشناست یا خیر.
سیستم ۲ کند، تحلیلی و پرتلاش است. برای محاسبه ۱۷ × ۲۴ باید «فکر کنید».
TypeSafe استدلال میکند LLMها عمدتاً سیستم ۲ هستند: قدرتمند، اما برای هر تصمیم کوچکی باید «فکر» کنند. Jev یک سیستم ۱ است: برای قضاوتهای سریع و تخصصی طراحی شده که یک انسان خبره در چند ثانیه انجام میدهد. این به معنای «جایگزینی» LLM نیست؛ بلکه یک لایه تصمیمگیری ارزان و سریع است که قبل از LLM قرار میگیرد.
هر درخواست به Jev از سه جزء تشکیل شده است.
State یا وضعیت متنی، JSON یا آرایهای از متنهاست که زمینه تصمیم را توصیف میکند: یک تیکت، یک پیام، یک رکورد گفتگو، یا ترکیبی از چند فیلد ساختاریافته. قاعده مهم این است که فقط چیزی را بفرستید که سؤال به آن نیاز دارد. هرچه State نامرتبط بیشتر باشد، دقت پایینتر میآید؛ پدیدهای که TypeSafe آن را «context rot» مینامد.
Question یا سؤال تایپشده باید یکی از سه primitive باشد. نخست Choice است که از میان چند گزینه یکی را انتخاب میکند؛ مثلاً «کدام تیم باید این تیکت را بررسی کند؟». دوم Score است که وضعیت را روی یک مقیاس مرتبشده امتیاز میدهد؛ مثلاً «فوریت از ۱ تا ۵». سوم Noul یا Yes/No است که احتمال درست بودن یک گزاره را برمیگرداند؛ مثلاً «آیا این ورودی یک prompt injection است؟».
Criteria یا معیارها برای سؤالهای Choice و Score، گزینهها یا سطوح مجاز را تعریف میکنند. سؤال از دو بخش تشکیل میشود: instructions که میگوید چه چیزی را قضاوت کن، و criteria که میگوید پاسخهای ممکن چه هستند.
نکته کلیدی این است که هر سؤال مستقل از سؤال دیگر و بهصورت موازی روی همان State ارزیابی میشود. افزودن سؤال جدید تقریباً زمان پاسخ را تغییر نمیدهد و باعث نمیشود سؤالها روی هم «اثر بگذارند». اگر یک تصمیم پیچیده دارید، آن را به چند سؤال کوچک بشکنید و نتایج را با منطق کد خودتان ترکیب کنید، نه با یک prompt غولآسا.
خروجی Jev یک مقدار قطعی نیست، بلکه یک توزیع احتمال روی گزینههاست، بههمراه یک مقدار confidence یا اطمینان. این دقیقاً همان چیزی است که تصمیم را «قابلاتکا برای کد» میکند.
منطق confidence gating ساده اما قدرتمند است. اگر تصمیم با اطمینان ۰.۹۷ گرفته شود، بهصورت خودکار اجرا میشود. اگر تصمیم با اطمینان ۰.۶ گرفته شود، به بازبینی دوم، یعنی انسان یا مدل بزرگتر، ارجاع داده میشود.
آستانهها در کد شما زندگی میکنند، نه در مدل. این یعنی میتوانید بدون تغییر مدل، رفتار سیستم را تنظیم کنید. اگر هزینه خطا بالا باشد، آستانه را بالا ببرید. اگر سرعت اولویت دارد، آستانه را پایین بیاورید و موارد نامطمئن را به لایه بعدی بفرستید.
یکی از قویترین showcases برای Jev، guardrail در برابر prompt injection است. یک مطالعه ارزیابی، Jev را با دو classifier اختصاصی Prompt Guard 2 در اندازههای ۲۲M و ۸۶M و همچنین یک LLM-as-judge مقایسه کرد. Jev در شاخص AUC به ۰.۸۷۱ رسید و از Prompt Guard 2 86M با ۰.۷۵۷ و Prompt Guard 2 22M با ۰.۷۱۴ بهتر عمل کرد.
در عمل، معماری به این شکل است: یک classifier سریع مثل Jev یا یک مدل کوچک، هر ورودی را با هزینه ناچیز و تأخیر بسیار کم بررسی میکند. اگر اطمینان بالا بود که ورودی «امن» است، ادامه مسیر خودکار میشود. اگر اطمینان پایین یا مشکوک بود، ورودی به یک LLM بزرگتر یا به انسان escalate میشود. این همان confidence gating است که در لایه امنیتی هم کار میکند.
TypeSafe جزئیات کامل معماری Jev را عمومی نکرده است، اما میگوید از معماری جدید، sampler جدید و الگوریتم آموزش جدیدی به نام RLCD استفاده میکند. RLCD مخفف Reinforcement Learning for Calibrated Decisions است.
برخلاف RLHF که LLMها را برای «ترجیح انسانی» بهینه میکند و مشکلاتی مثل overconfidence و mode dropping ایجاد میکند، RLCD مستقیماً برای تصمیمهای کالیبرهشده طراحی شده است.
قاعده سرانگشتی این است که از Jev استفاده کنید وقتی خروجی یک برچسب، امتیاز یا بله/خیر است؛ وقتی حجم بالا و هزینه مهم است؛ وقتی تأخیر باید کمتر از چند صد میلیثانیه باشد؛ وقتی به کالیبراسیون نیاز دارید، یعنی میخواهید بدانید مدل چقدر مطمئن است؛ و وقتی میخواهید تصمیم را در کد gate کنید.
از LLM استفاده کنید وقتی خروجی متن آزاد است، مثل توضیح، خلاصه یا مکالمه؛ وقتی حجم پایین است یا هزینه ثانویه است؛ وقتی تأخیر چند ثانیه قابلقبول است؛ وقتی به استدلال چندمرحلهای نیاز دارید؛ و وقتی میخواهید پاسخ را به انسان نشان دهید.
Jev جای LLM را نمیگیرد؛ لایهای قبل از آن میسازد. بسیاری از سیستمهای production از ترکیب هر دو استفاده میکنند: Jev تصمیمهای سریع و ارزان را میگیرد، و LLM فقط برای موارد پیچیده یا کماطمینان فراخوانی میشود.
Classification: برچسبگذاری تیکتها، ایمیلها، نظرات یا اسناد. Jev با یک forward pass و هزینه بسیار کم، توزیع احتمال روی کلاسها را برمیگرداند.
Routing: تصمیمگیری درباره اینکه یک درخواست به کدام تیم، کدام صف یا کدام مدل برود. در معماری model routing، Jev بهعنوان یک فیلتر ارزان عمل میکند: ابتدا تصمیم میگیرد آیا اصلاً نیاز به LLM گرانقیمت هست یا خیر، و اگر هست، کدام LLM مناسبتر است.
Ranking: مرتبسازی گزینهها بر اساس یک معیار؛ مثلاً امتیازدهی به کیفیت leadها یا اولویت بازبینی.
Semantic Find: پیدا کردن موارد مرتبط در میان حجم زیادی از داده، نه با جستجوی کلیدواژه، بلکه با قضاوت معنایی سریع.
Dynamic UI: تغییر رابط کاربری بر اساس تصمیمهای لحظهای؛ مثلاً نمایش یک دکمه اضافی فقط وقتی اطمینان کافی وجود دارد که کاربر نیاز به کمک دارد.
Agent Guardrail: همان مثال prompt injection. هر ورودی قبل از رسیدن به LLM اصلی از یک gate سریع عبور میکند.
Model Routing: Jev تصمیم میگیرد کدام مدل، کوچک یا بزرگ یا تخصصی، باید درخواست را پردازش کند. این تصمیم با هزینه بسیار کم گرفته میشود و صرفهجویی هزینه LLM را ممکن میکند.
Jev برای قضاوتهای سریع و محدود طراحی شده است، نه برای هر کاری.
استدلال چندمرحلهای: اگر پاسخ نیاز به زنجیرهای از استدلال دارد، Jev ابزار مناسب نیست. باید سؤال را به زیرسؤالها بشکنید و نتایج را در کد ترکیب کنید.
تولید متن: Jev متن نمینویسد. اگر خروجی موردنیاز شما توضیح، خلاصه یا مکالمه است، باید از LLM استفاده کنید.
ورودیهای چندرسانهای: Jev در حال حاضر فقط متن، JSON و آرایههای متنی را میپذیرد؛ تصویر، صدا و ویدیو پشتیبانی نمیشوند، حداقل در نسخهای که مستندات رسمی نشان میدهد.
دانش عمومی وسیع: Jev برای قضاوت روی یک State مشخص ساخته شده، نه برای پاسخ به سؤالات دانشمحور.
OpenAI Decisions API: OpenAI در اکتبر ۲۰۲۶ یک API اختصاصی برای تصمیمگیری عرضه کرد که بر پایه GPT-6 Luna ساخته شده و ادعا میکند ۱۰ برابر سریعتر از Responses API است. این API سه نوع خروجی میدهد: predicate یا احتمال درستی یک شرط، choice یا انتخاب از میان گزینهها، و score یا امتیاز روی یک مقیاس. از نظر مفهومی بسیار نزدیک به Jev است، اما بر پایه یک مدل زبانی بزرگتر بنا شده و ممکن است هزینه و تأخیر بالاتری داشته باشد.
BERT و ModernBERT: مدلهای encoder-only کلاسیک برای classification فوقالعادهاند، بهویژه وقتی داده برچسبدار دارید. ModernBERT با context تا ۸۱۹۲ token و کارایی بالا، گزینهای قوی برای متنهای طولانی است. اما این مدلها معمولاً به fine-tuning نیاز دارند و «zero-shot» نیستند.
SetFit: یک روش few-shot classification است که یک مدل sentence-embedding را روی چند مثال برچسبدار fine-tune میکند و در سناریوهای کمداده عملکرد بسیار خوبی دارد. در یک مطالعه مقایسهای، SetFit با MPNet به دقت ۸۳٪ و ModernBERT به دقت ۷۳٪ روی AG News رسیدند. SetFit وقتی عالی است که چند ده مثال برچسبدار دارید و میخواهید یک classifier سبک و دقیق بسازید.
Laya: یک مدل تصمیمگیری non-autoregressive متنباز و چندزبانه که بر پایه ModernBERT-large ساخته شده و از choice، score و noul پشتیبانی میکند. Laya در یک forward pass و با تأخیر حدود ۳۵ میلیثانیه تصمیم میگیرد و از نظر معماری یکی از نزدیکترین جایگزینهای متنباز برای Jev است.
Kev: خانوادهای از مدلهای تصمیمگیری کوچک بر پایه Qwen3.5/3.8 که میتوانید خودتان آموزش دهید و اجرا کنید. Kev در اندازههای ۰.۸B تا ۲۷B عرضه شده و API آن با SDK پایتون TypeSafe سازگار است؛ یعنی میتوانید Jev را با Kev جایگزین کنید بدون تغییر کد.
NanoJev و OpenJev: پروژههای متنباز دیگری که همان پارادایم «تصمیم تایپشده با احتمال» را دنبال میکنند. NanoJev بر پایه Qwen3-0.6B ساخته شده و OpenJev مجموعهای از مدلهای تصمیمگیری تایپشده است.
انتخاب به سه عامل بستگی دارد: داده برچسبدار، نیاز به چندزبانگی یا حریم خصوصی، و بودجه و زیرساخت.
اگر میخواهید سریع شروع کنید و زیرساخت مدیریتشده میخواهید، Jev یا OpenAI Decisions API گزینه مناسب است.
اگر داده برچسبدار کافی دارید و میخواهید حداکثر دقت را بگیرید، SetFit یا ModernBERT با fine-tuning انتخاب بهتری است.
اگر میخواهید همهچیز متنباز و local باشد، Laya، Kev، NanoJev یا OpenJev را بررسی کنید.
اگر به چندزبانگی نیاز دارید، Laya با پشتیبانی از بیش از ۱۰۰ زبان گزینه مهمی است.
اگر میخواهید مدل را روی سختافزار خودتان اجرا و fine-tune کنید، Kev از لپتاپ تا GPU دیتاسنتر قابل استفاده است.
اگر به guardrail سریع برای agent نیاز دارید، Jev یا یک classifier سبک مثل Prompt Guard 2 همراه با confidence gating مناسب است.
یک استراتژی رایج این است: Jev را بهعنوان لایه اول بگذارید. اگر اطمینان بالا بود، تصمیم خودکار اجرا شود. اگر اطمینان پایین بود، به SetFit یا ModernBERT، اگر داده برچسبدار دارید، یا به یک LLM ارجاع شود. این ترکیب هم هزینه را پایین نگه میدارد و هم دقت را بالا.
TypeSafe AI. “Introduction.” docs.typesafe.ai. https://docs.typesafe.ai/introduction
TypeSafe AI. “Home.” typesafe.ai. https://typesafe.ai/
Waehner, Kai. “How Decision Models Became a New AI Category After Jev.” kai-waehner.de, 20 Oct. 2026. https://www.kai-waehner.de/blog/2026/10/20/how-decision-models-became-a-new-ai-category-after-jev/
OpenAI. “使用 Decisions API 构建响应更迅速的应用.” openai.com, 22 Oct. 2026. https://openai.com/zh-Hans-CN/index/decisions-api/
“From Detection to Decision: Calibration and Deferral for Prompt-Injection Detection.” arXiv, Oct. 2026.
Poojithcodes. “jev-calibration-study.” GitHub. https://github.com/Poojithcodes/jev-calibration-study
Ali Awan, Abid. “7 大开源 TypeSafe Jev 替代方案.” DataCamp. https://www.datacamp.com/zh/blog/top-open-source-jev-alternatives
“Jev AI API 教程:用 Choice、Score、Noul 构建第一个结构化决策.” thejevai.com, 20 Sep. 2026. https://thejevai.com/zh/blog/jev-ai-api-tutorial
Jared Palmer. “Kev.” GitHub. https://github.com/jaredpalmer/kev
Kahneman, Daniel. Thinking, Fast and Slow. Farrar, Straus and Giroux, 2011. مبنای مفهومی System 1 و System 2.
Decision Model: مدلی که بهجای تولید متن، درباره یک ورودی «تصمیم» میگیرد و آن را بهصورت تایپشده، مانند برچسب، امتیاز یا احتمال، برمیگرداند.
System One Model: نام TypeSafe برای مدلهای تصمیمگیری سریع و شهودی، برگرفته از سیستم ۱ کانمن.
State: زمینه یا ورودیای که مدل باید درباره آن قضاوت کند؛ متن، JSON یا آرایه.
Typed Question: سؤالی با پاسخ محدود و از پیش تعریفشده؛ شامل Choice، Score و Noul.
Choice: نوع سؤالی که مدل از میان چند گزینه یکی را انتخاب میکند.
Score: نوع سؤالی که مدل وضعیت را روی یک مقیاس مرتب امتیاز میدهد.
Noul یا Yes/No: نوع سؤالی که مدل احتمال درستی یک گزاره را برمیگرداند.
Criteria: گزینهها یا سطوح مجاز برای پاسخ به یک سؤال Choice یا Score.
Confidence Gating: استفاده از آستانه اطمینان برای تصمیمگیری درباره اینکه نتیجه بهصورت خودکار اجرا شود یا به لایه بعدی، یعنی انسان یا LLM، ارجاع شود.
RLCD: مخفف Reinforcement Learning for Calibrated Decisions؛ الگوریتم آموزشی TypeSafe برای کالیبره کردن تصمیمها.
Prompt Injection: تلاش برای دستکاری مدل از طریق ورودی مخرب، بهگونهای که رفتار ناخواستهای انجام دهد.
ModernBERT: مدل encoder-only با context تا ۸۱۹۲ token، مناسب classification متنهای طولانی.
SetFit: روش few-shot classification که sentence-embedding را با چند مثال برچسبدار fine-tune میکند.
Non-autoregressive: مدلی که خروجی را یکجا تولید میکند، نه token به token؛ سریعتر است، اما معمولاً برای تصمیمگیری نه تولید متن آزاد.
Model Routing: هدایت یک درخواست به مدل مناسب، کوچک یا بزرگ یا تخصصی، بر اساس تصمیم یک لایه ارزانقیمت.


