
در تکنولوژی های مدرن، یکپارچگی و امنیت داده ها به اولویت اصلی تبدیل شده است. به خصوص اگر در مورد پروژه های بزرگ صحبت کنیم که نیازمند نگهداری صدها یا هزاران بلوک اطلاعاتی در یک مکان امن هستند. بنابراین، انتخاب یک پایگاه داده مناسب برای پروژه بعدی شما چیز حاشیه ای نیست. این نیاز به دانستن همه گزینه ها، مزایا و معایب آنها و درک اینکه کدام یک برای شما مناسب است.
در چندین دهه گذشته، PostgreSQL پیشرو در میان گزینه های پایگاه داده رابطه ای منبع باز بوده است. این یک سیستم object-relational پیشرفته است که از زبان SQL استفاده می کند. Postgres به شما اجازه می دهد تا داده های بزرگ و پیچیده را با خیال راحت ذخیره کنید. این به توسعه دهندگان کمک می کند تا پیچیده ترین برنامه ها را بسازند، administrative tasks را اجرا کنند و محیط های یکپارچه ایجاد کنند.
در این بخش با مفهوم رپلیکیشن و اینکه رپلیکیشن بر روی دیتابیس پستگرس چگونه کار می کند آشنا خواهیم شد:
در پستگرس رپلیکیشن را می توان به 3 روش اصلی زیر ارائه کرد:
1. مبتنی بر فایل یا دیسک
2. مبتنی بر WAL
3. مبتنی بر SQL
این پایگاه داده ابتدا تغییرات را در حافظه ثبت میکند تا بتواند تغییرات را سریع ضبط کند. دسترسی به حافظه بسیار سریع اما بی ثبات است به این معنی که اگر سرور crash شود تغییرات اخیر داده های ما پس از راه اندازی مجدد سرور ناپدید میشوند.
مفهوم WAL یک رکورد از تمامی مقادیر و متغیرات پایگاه داده است، به طوری که ما میتوانیم تمامی تغییراتی که در حافظه به وجود آمده است اما به خاطر خرابی سرور هنوز به دایرکتوری اصلی داده ها نوشته نشده است را دوباره بازیابی کنیم.
در صورت خرابی یا ری استارت شدن سرور به کار می آید اما یک محدودیت بزرگ هم دارد. زمانی که دیسکی خراب شود و یا یک امر غیرقابل بازگشت دیگری پیش بیاید WAL نمی تواند به ما کمک کند. فرض کنید که تمام دیتای ما بر روی یک سرور است و به خاطر خرابی برای دیسک ممکن است از بین برود، بنابراین ما به چیزی نیاز داریم که ما را در مقابل خرابی های این چنینی مقاوم کند. اینجا است کهreplication به کمک می آید. در اینجا PostgreSQL از یک رویکرد زیرکانه استفاده میکند، و از WAL به عنوان یک ابزار استفاده کرده و آن را برای بقیه سرورها میفرستد، حالا ما یک رپلیکیشن کامل از دیتابیس خود بر روی یک سرور دیگر داریم.
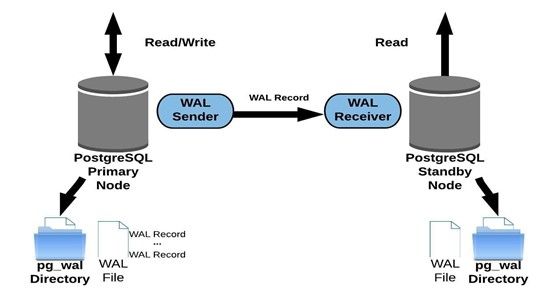
این نوع رپلیکیشن تضمینی در رابطه با اینکه اطلاعات به رپلیکیشن های مختلف ارسال شده یا نه، ندارد.
دیتا زمانی که بر روی WAL سرور اصلی نوشته شد، نوشته شده در نظر گرفته میشود. فرستنده WAL تمام دیتای WAL را بر روی رپلیکیشن های متصل شده پیاده میکند اما این اتفاق به صورت asynchronous و بعد از اینکه WAL نوشته شد می افتد.
رپلیکیشن به صورت async معروف ترین نوع برای انجامinsert ها است. کلاینت ها فقط بایستی منتظر سرور اصلی برای نوشتن WAL باشند.
از آنجایی که تضمینی وجود ندارد که داده ها پس از نوشتن به صورت موفقیت آمیز به رپلیکیشن منتقل شوند، این حالت ممکن است منجر به ناسازگاری موقت داده ها بین سرور اصلی و سرور رپلیکیشن شود.
تا زمانی که WAL مربوطه به رپلیکیشن نپیوندد و به دیتابیس آن اعمال نشود، مشتریانی که از این رپلیکیشن ها میخوانند، اطلاعات جدید را در کوئری خود نخواهند دید.
از دست دادن داده در این نوع رپلیکیشن اگر که سرور اصلی قبل از رسیدن WAL به سرور رپلیکیشن دچار خرابی شود یک احتمال به شمار میرود. هرچند که اگر سرور اصلی دچار کرش شود و دوباره شروع به کار کند، سرور رپلیکیشن از جایی که داده ها به خاطر خرابی متوقف شده بود دوباره ادامه به کار میدهد.
این نوع رپلیکیشن تضمین میکند که تمامی مقادیر مشخص شده برای رپلیکیشن، داده ی خود را قبل از اینکه سرور اصلی به مشتری اعلام موفقیت کند بر روی WAL مینویسند.
عملکرد write در این نوع رپلیکیشن حرکت کندتری نسبت بهasynchronous دارد.
از دست دادن دیتا در این حالت هنوز امکان پذیر است هرچند که نسبت به اجرای async کم تر شده است، در اکثر موارد synchronous هر دو سرور هم اصلی و هم رپلیکیشن دچار کرش میشوند.
نه تنها تضمین میکند که WAL برای همه رپلیکیشن ها به صورت مشخص نوشته شده است بلکه تمام بخش های WAL در پایگاه داده اعمال میشوند.
از آنجایی که مشتری باید منتظر بماند تا کلیه عملیات نوشتن در سرور اصلی و رپلیکیشن انجام شود، این حالت کندترین نوع ممکن است.
تضمین میکند که هر رپلیکیشن مشخص شده به طور کامل با سرور اصلی سازگار باشد و عملیات write تاز مانی که در پایگاه داده اعمال نشود موفقیت آمیز تلقی نخواهد شد.
در مورد از دست دادن دیتا، این نوع از رپلیکیشن حتی تضمین بهتری نسبت به 2 مورد قبلی است.


