
درود به همگی: تو بخش اول درباره اینکه وب اسکرپینگ چی هست، چه کتابخونه هایی برای کار باهاش نیاز هست و همین طور درباره کتابخونه Requests براتون توضیح دادم. امروز می خوام راجع به یکی دیگه از کتابخونه های مهم که تو وب اسکرپینگ استفاده میشه بنویسم، به اسم Beautiful Soup.
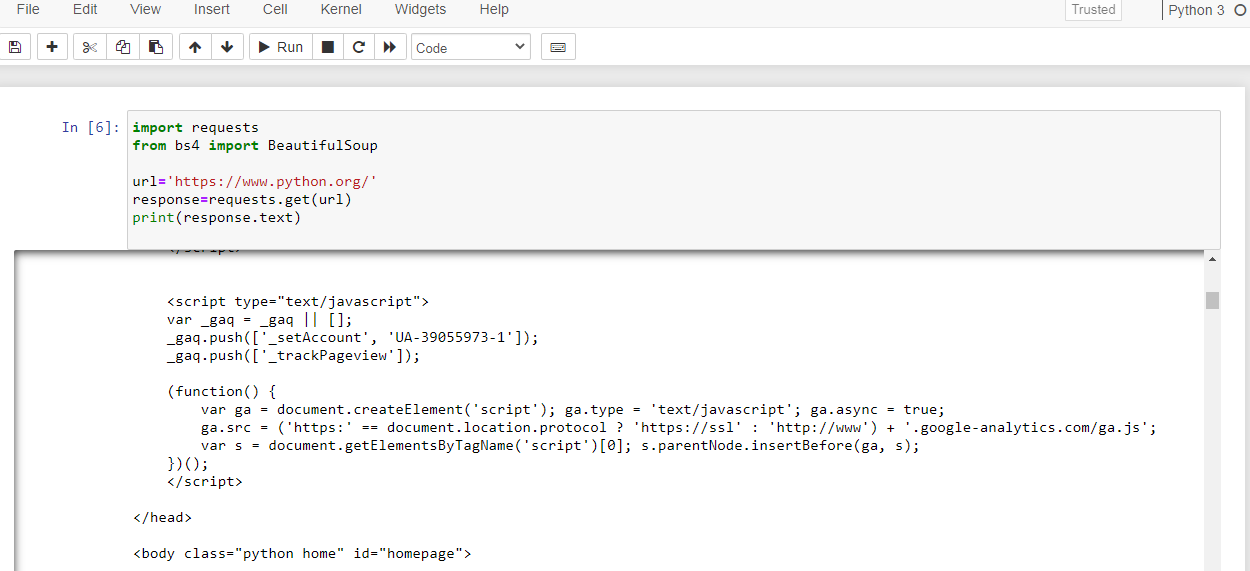
خب حالا یه بار دیگه کد جلسه قبلی رو اجرا می گیرم ببینید نتیجه چه درهم برهم و شلوغه!!!
خب اینجا میایم از کتابخونه beautiful soup استفاده می کنیم تا بتونیم اینا رو مرتب داشته باشیم:
from bs4 import BeautifulSoup
حالا یه متغیر می سازیم و به کمک اون کتابخونه رو صدا می زنیم (باکلاسش میشه کال می کنیم؛)
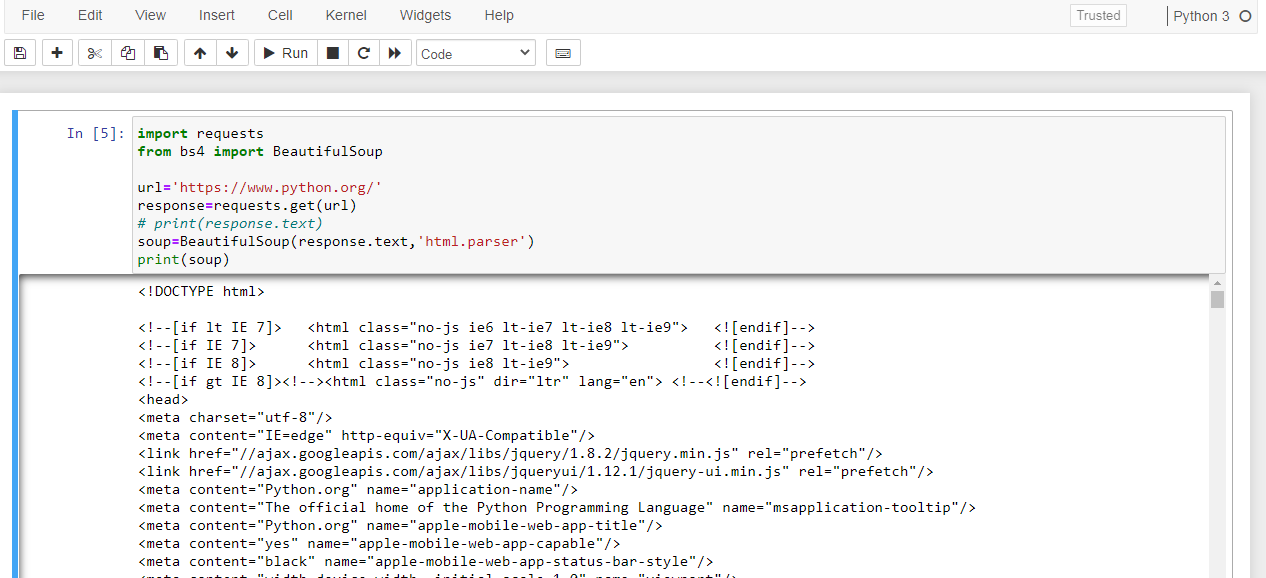
soup=BeautifulSoup(response.text,'html.parser')
این کتابخونه دو تا مقدار می گیره، اولی همون درخواستی هست که فرستادیم به سایتی که میخایم داده ها رو ازش استخراج کنیم و مقدار دوم تجزیه کننده یا paerser هست (تو این آموزش من از پارسر html استفاده می کنم، موردای دیگه ای هم هستن مثل lxml)، کار این تجزیه کننده هم که دیگه خیلی واضح هست تجزیه می کند))) . حالا یه پرینت می گیرم نتیجه رو ببینید و مقایسه کنید با قبلی: می بینید که همه چی خیلی با نظم و ترتیب یه جا نشسته.
خب خب خب همین دیگه) حالا براتون چند تا از متدهایی که به کمک این کتابخونه استفاده میشه رو توضیح میدم:
متد ()find: خروجی این متد اولین مقداری هست که ازش می خوایم. مثلا! می خوایم اولین تگ a رو بهمون برگردونه.
متد ()findAll()/find_all: خروجی این متد همه مقادیری هست که بهش درخواست میدیم. مثلا! تو مثال قبلی همه تگ های a رو می تونیم برگردونیم با کد زیر:
print(soup.findall('a')
print(soup.find_all('a')
مثلا! می خوایم همه لینکایی که توی سایت هست رو بهمون نشون بده از این کد می تونیم استفاده کنیم:
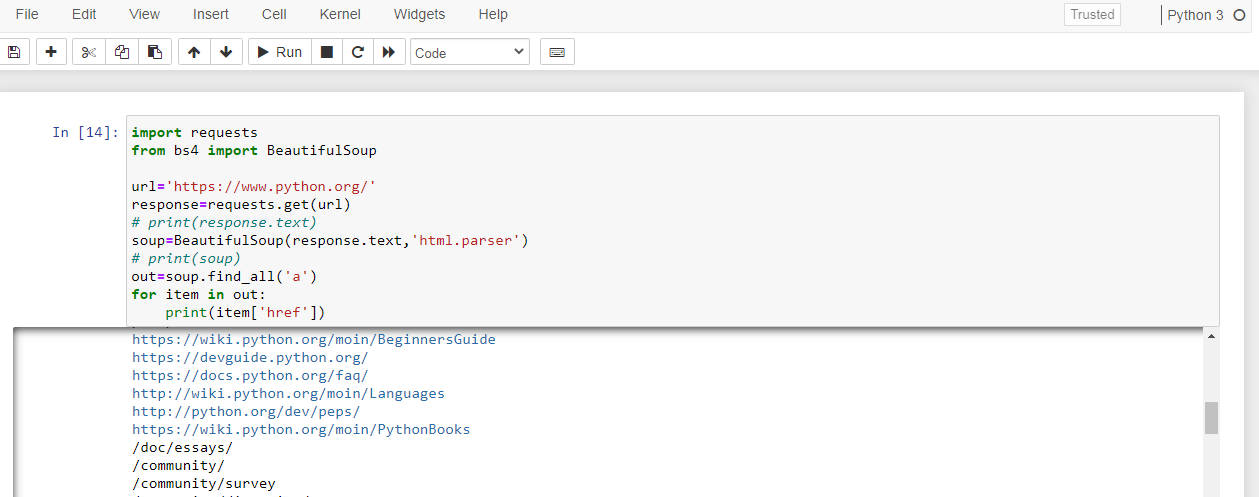
out=soup.find_all('a')
for item in out:
print(item['href'])
یعنی اینکه اومدیم ویژگی href مربوط به تگ a رو تو کل سات پیدا کردیم و لینکا رو تو خروجی بهمون نشون میده (یه سری ها هم لینک نیت خب دیگه طبیعتاً چون هرچی بعد href هست رو می بینیم):
متد ()select_one: مثل متد ()find هست که اولین مقدار درخواستی رو بر می گردونه.
متد ()select: مثل متد ()findAll هست و تمامی مقادیری که خواستیم رو بر می گردونه.
مثال:
اگر بخوایم از یه دکمه موجود توی سایت فقط قسمت متنیش رو داشته باشیم، مثلاً تو همین سایت متن مربوط به دکمه GO رو بدست بیاریم. اول که به کمک inspect element (F12) و با استفاده از نشانه گر روی دکمه نگه می داریم و می بینیم که توی چه تگی قرار گرفته ویژگی های مختلفی هم داره مثل id, class...
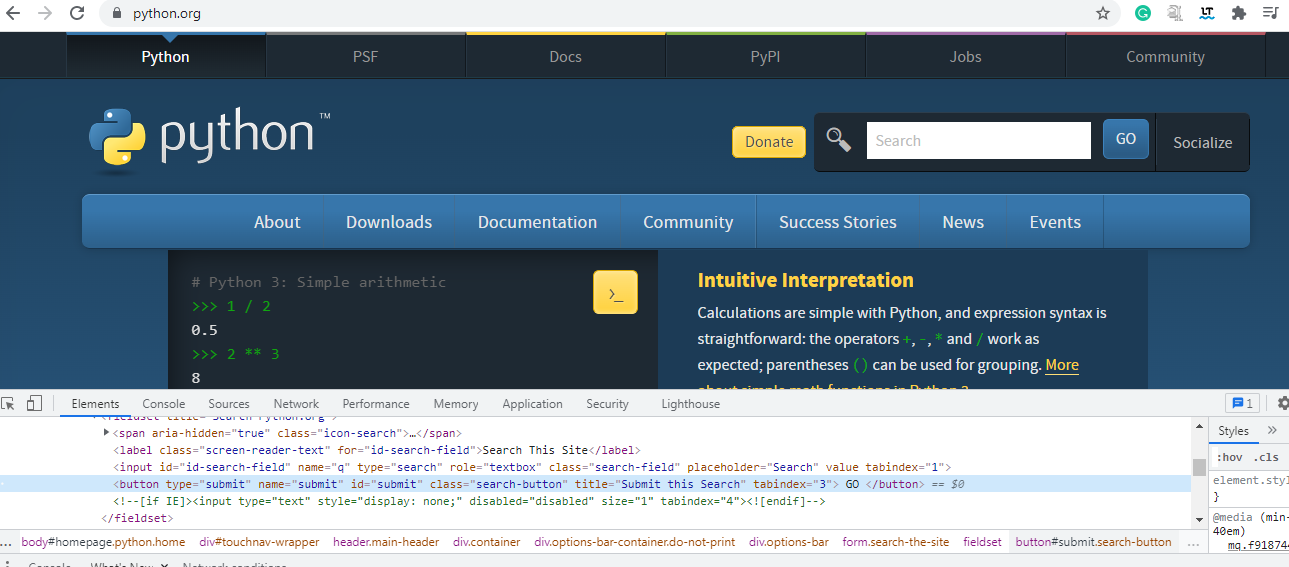
خب به کمک این ویژگیها می تونیم متن رو بدست بیاریم. (اینجا . به معنی کلاس و # یعنی id دقت کنید که اینا برای select و select_one هست)
out=soup.select_one('button.search-button')
print(out.text)
توی خروجی GO رو نشون میده.
همین دستور رو با find براتون می نویسم:
out=soup.find('button',{'id':'submit'})
print(out.text)
و آخر این بخش هم یه مثال دیگه براتون میارم. فرض کنید وارد سایت chess-Result شدیم و می خایم اطلاعات یه جدول رو به دست بیاریم. اول کپی می کنیم آدرس سایت رو:
import requests
from bs4 import BeautifulSoup
url='https://chess-results.com/tnr589226.aspx?lan=1&art=4'
response=requests.get(url)
soup=BeautifulSoup(response.text,'html.parser')
حالا باید ببینیم جدول توی چه تگی قرار داره (با همون روش F12) .
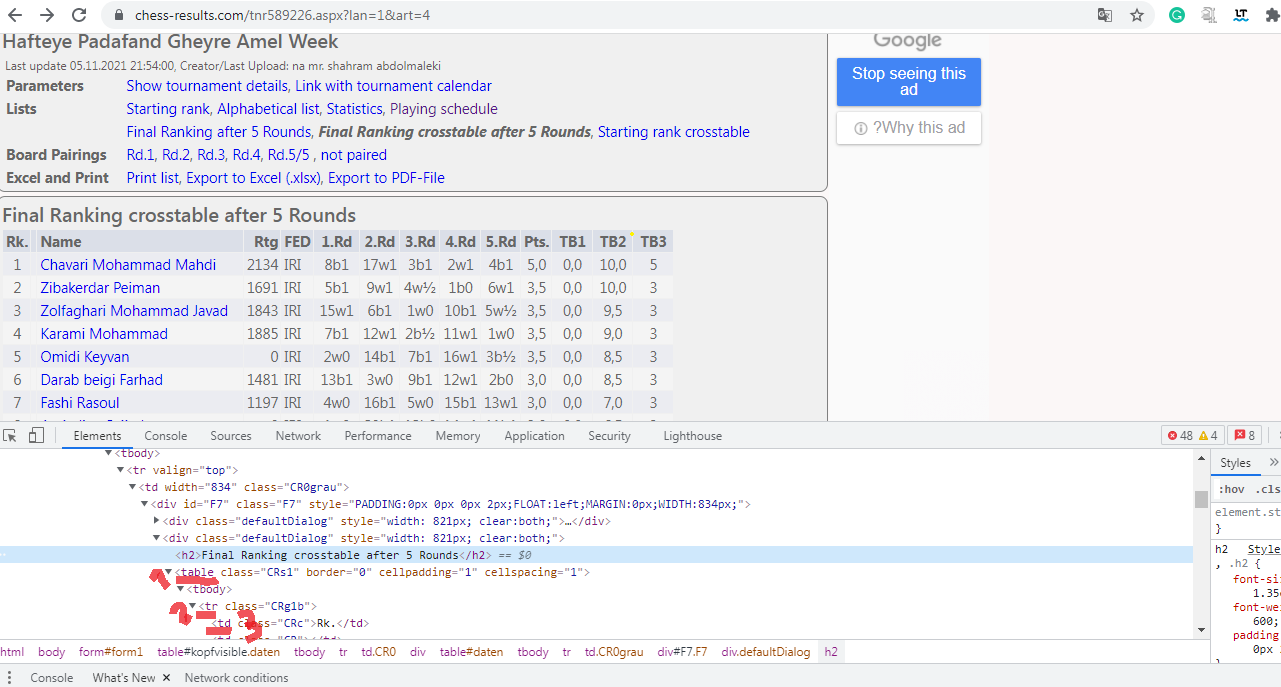
می بینیم که توی تگ table بعد tr و بعدم td اطلاعات مربوط به این جدول قرار گرفته. حالا به شکلی که توی کد براتون توضیح میدم می تونید اطلاعات رو استخراج کنید:
table=soup.find('table')
rows=table.findAll('tr')
for item in rows:
data=[]
for body in item.find_all('td'):
items=body.text.replace('\n',' ')
data.append(items)
print(data)
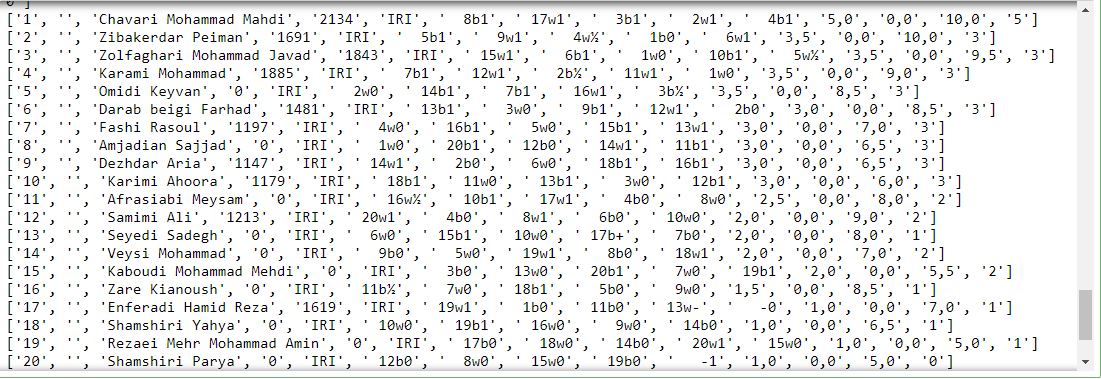
نکته آخر اینکه توی کد .replace('\n',' ') یعنی n\ ها رو با یه فضای خالی جایگزین کن.
امیدوارم که این بخش هم براتون مفید بوده باشه. تا جلسه بعدی ...

