
هوش مصنوعی چیزی است که:
· منطقی فکر کند.
· منطقی رفتار کند.
· مانند انسان فکر کند.
· مانند انسان رفتار کند.
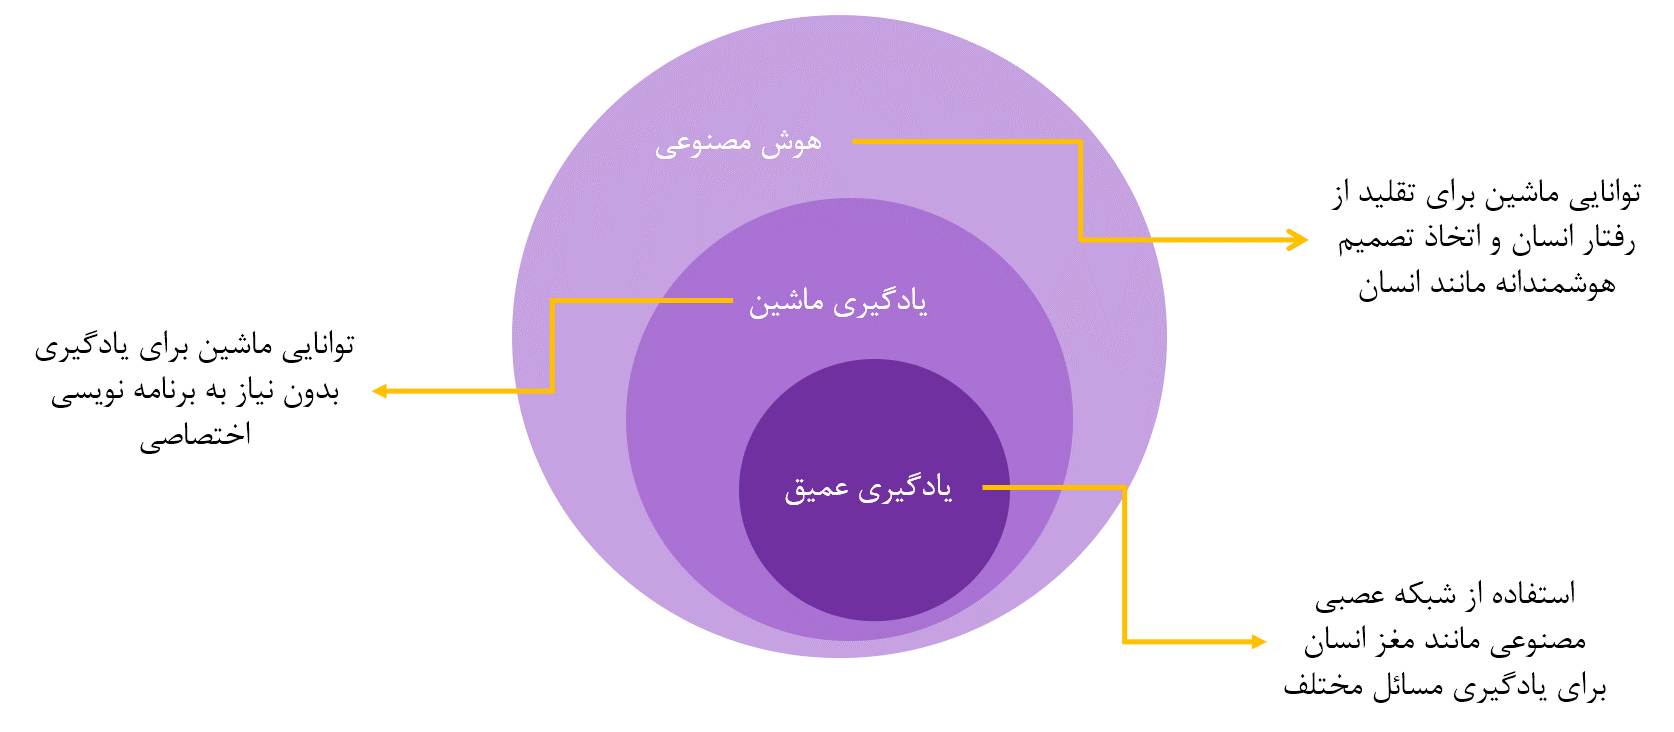
ساخت عامل هوشمند (intelligent agent) : عامل میتواند سختافزاری یا نرمافزاری باشد و بر حسب محیطی که عامل قرار است در آن مورد استفاده قرار گیرد، میتواند دارای اجزای مختلفی باشد. برای مثال، عاملی که با انسان در ارتباط است باید توانایی دریافت و درک زبان طبیعی را داشته باشد و عامل فیزیکی ممکن است نیازمند بازوهای حرکتی برای انجام اعمال انتخابی باشد.
در آیندهای نه چندان دور، رباتهایی که از انسان، قابل تشخیص نیستند افزایش خواهند یافت. خودتان را آماده کنید! هر برنامهای که هوشمندی داشته باشد یا به نوعی رفتار انسان را تقلید کند، به عنوان هوش مصنوعی پذیرفته میشود.یادگیری ماشین بعد از هوش مصنوعی موضوعیت پیدا کرد و آن را میتوان زیر مجموعهی هوش مصنوعی در نظر گرفت.
یکی از مهمترین ویژگیهای یادگیری ماشین، یادگیری با استفاده از داده و بدون استفاده از دستورات مستقیم است. ویژگی دیگر یادگیری ماشین، تغییر خود با دیدن دادههای جدید است؛ یعنی همانند انسان با کسب تجربیات جدید رفتار خود را تغییر میدهد.
یکی از اولین کاربردهای یادگیری ماشین در تشخیص ایمیل هایspam بود. امروزه ماشینهای بدون راننده در سطح شهرها در حال حرکت هستند، صاحبانمحصول از سیستمهای پیشنهاد دهنده برای پیشنهاد محصول استفاده میکنند، اقتصاددانان برای پیشبینی روند بازار از آن استفاده میکنند و همچنان کاربردهای بیشتری در حال ایجاد شدن است.
زبان پایتون و R از محبوبترین زبانهای قابل استفاده برای یادگیری ماشین هستند و کتابخانههای بسیار قدرتمندی در این زبانها برای رفع نیازهای علاقهمندان این حوزه در حال گسترش است. افرادی که قصد ورود به این زمینه را دارند با دریایی از زبانها و کتابخانهها و ابزارها روبرو میشوند و متناسب با نیاز خود میتوانند از آنها بهره ببرند.
تحلیل گر سیستم:
دادههای خام قبل از تبدیل شدن به دانش نیازمند ذخیره سازی مناسب و آمادهسازیهایی میباشد. تحلیلگر داده، معماری مناسب برای جمعآوری اطلاعات یک سازمان را طراحی میکند و پایگاه داده مناسب برای این کار را انتخاب میکند. سپس دادهها را مورد بررسی قرار میدهد و از داده اطلاعات مفید استخراج میکند. او برای اینکار باید اطلاعاتی در مورد زمینه فعالیتهای سازمان و اهداف آن داشته باشد. نتیجه فعالیتهای تحلیلگر داده میتواند گزارشهای کلی یا روابط بین دادهها باشد و معمولا در جهت اهداف سازمان است.
دانشمند داده:دانشمند داده سطح بالاتری از تحلیلگر داده دارد و نیازمند دانش آماری و ریاضیاتی و برنامهنویسی قویتری نسبت به تحلیلگر داده است. همهی اموری که تحلیلگر انجام میدهد، دانشمند هم میتواند انجام دهد و علاوه بر آن باید با مفاهیم یادگیری ماشین و دانش برنامهنویسی آشنا باشد تا بتواند ابزارهایی برای تحلیل عمیقتر داده طراحی کند.گاهی دانشمندان داده با حوزهی تجارت هم آشنایی دارند تا در مورد تصمیمات تجاری یک شرکت بتوانند یاری دهند.دانشمند داده امور دادهکاوی را معمولا با زبانهای برنامهنویسی و کتابخانههای آن انجام میدهد ولی تحلیلگر از پلتفرمها و نرمافزارها استفاده میکند. تحلیلگر با همه در ارتباط است و معمولا سوالات را دیگران برایش مطرح میکنند اما دانشمند داده خودش سوالات را طرح میکند، سوالاتی که در تصمیمات شرکت تاثیرگذار هستند.
مهندس داده:او پس از مشورت با دیگر اعضای شرکت انتخاب میکند که چه دادهای از میان سیل دادهی تولیدی در اختیار شرکت قرار بگیرد. پس از انتخاب منابع داده، دادههای منابع مختلف را یکپارچه میکند و برای نگهداری بهینهیآنها برنامهریزی میکند.
مهندس یادگیری ماشین:مهندس یادگیری ماشین نقاط مشترک فراوانی با مهندس داده دارد. دانش یادگیری ماشین برای مهندس داده اجباری نبود ولی برای مهندس یادگیری ماشین الزامی است.وظایف مهندس یادگیری ماشین جنبهینظری و عملیاتی دارند. به این صورت که او باید دانش کاملی از الگوریتمها و روشهای یادگیری ماشین داشته باشد. بعد از استقرار، مسئول نظارت و رسیدگی به آن خواهد بود.
بسیاری از کاربردهای جذاب یادگیری ماشین مانند سیستمهای پیشنهاد دهنده و دستیارهای صوتی و بسیاری کاربردهای دیگر توسط مهندسان یادگیری ماشین به مرحلهیعمل رسیدهاند و این اهمیت کار آنها را نشان میدهد.
یادگیری ماشین در اکثر کاربردهای فعلی، یک برنامه کامپیوتری است که به داده دسترسی پیدا میکند و از آن برای آموزش خود استفاده میکند.
یادگیری ماشین زمینهای از تحقیقات است که به کامپیوترها توانایی یادگیری بدون برنامهنویسی صریح را میدهد.
ویژگی اصلی یادگیری ماشین خود آموزشی میباشد که به معنی استفاده از مدلسازی آماری و عدم استفاده از دستورات مستقیم (یا صریح) میباشد. به عقیده بسیاری در آموزش الگوریتم یادگیری ماشین، نیازی به دخالت انسان برای یادگیری نیست.
داده چیست؟ داده، در نتیجه مشاهدات و اندازهگیریها شکل میگیرد و توصیف این وضعیت مشاهده شده به شمار میآید. انواع داده؟
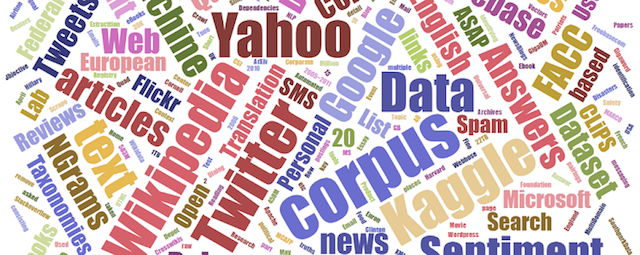
کلمات (زبان طبیعی): دادهای که پردازش زبان طبیعی با آن کار میکند، جملات و کلمات تولید شده توسط انسانها هستند، که ممکن است به صورت نوشتاری یا صوت در اختیار الگورتیمهای کامپیوتری قرار بگیرد.مانند : تشخیص گفتار ، دسته بندی نوشتار یا نظرات ، پاسخ دادن به سوالات .
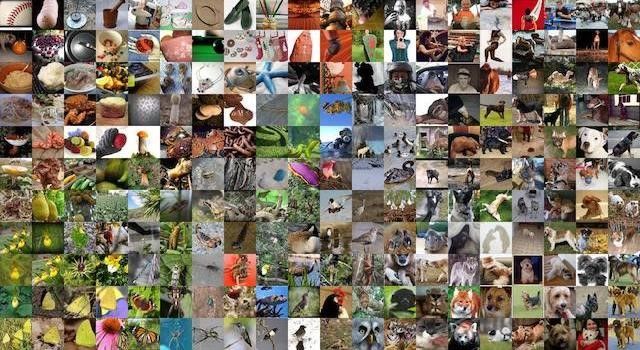
تصاویر: از کابردهای بینایی ماشین میتوان به تشخیص پلاک خودروها توسط پلیس، تشخیص اثر انگشت یا چهره برای باز کردن قفل گوشی، جستجو میان تصاویر در اجسام موجود در عکس، پردازش تصاویر ماهوارهای برای هواشناسی یا تشخیص وقایع زیستمحیطی و ماشینهای خودران اشاره کرد.همچنین میتواند نیاز به متخصص رادیولوژی را برای بررسی تصاویر پزشکی اشعه ایکس، MRI یا سونوگرافی را کاهش دهد.
جداول: یک بانک که نام و کدملی افراد، موجودی حسابها، مجموع مبلغ وامهایی که تا به حال دریافت کردهاند را در جدولی نگهداری میکند. بانک میتواند با کمک یادگیری ماشین از روی این دادهها پیشبینی کند که درخواست وام یک مشتری را قبول یا رد کند.به عنوان مثال سیستمهای توصیهگر در یک فروشگاه اینترنتی کمک کنند بر اساس خریدها و بازدیدهای یک فرد، کالاهایی که ممکن است یک فرد بخرد را به او پیشنهاد دهند و میزان فروش فروشگاه را زیاد کنند.
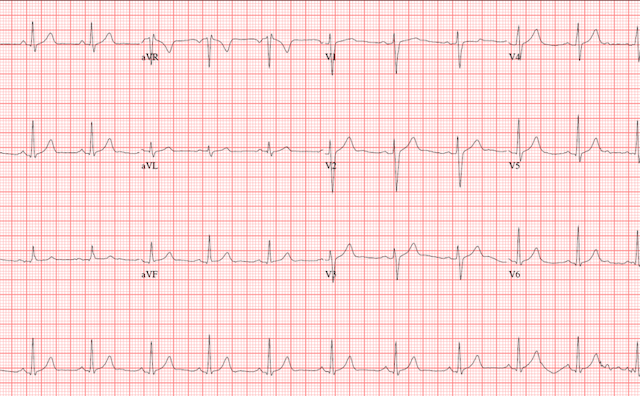
سری زمان : انواع داده که تغییرات آن در طول زمان اهمیت ویژه دارد. ماشین با دیدن تغییرات داده در طول زمان، الگوی تغییرات آن را یاد بگیرد و پیشبینی مقدار در یک زمان مشخص. مثلا اگر ارزش یک سهم در بازار بورس در یک بازه زمانی و از نمونه دیگر نوار قلبی است. و یا خریدهای یک فرد یا تراکنشهای بانکی است.
از انواع دیگر برای مثال صوت یک که با زبان طبیعی سر و کار دارد و فیلم که با مجموعهای از تصاویر ساخته میشود و هر دو نیز برحسب زمان هستند.
انواع یادگیری ماشین: یادگیری بانظاره ، یادگیری بدون نظارت ، یادگیری تقویتی
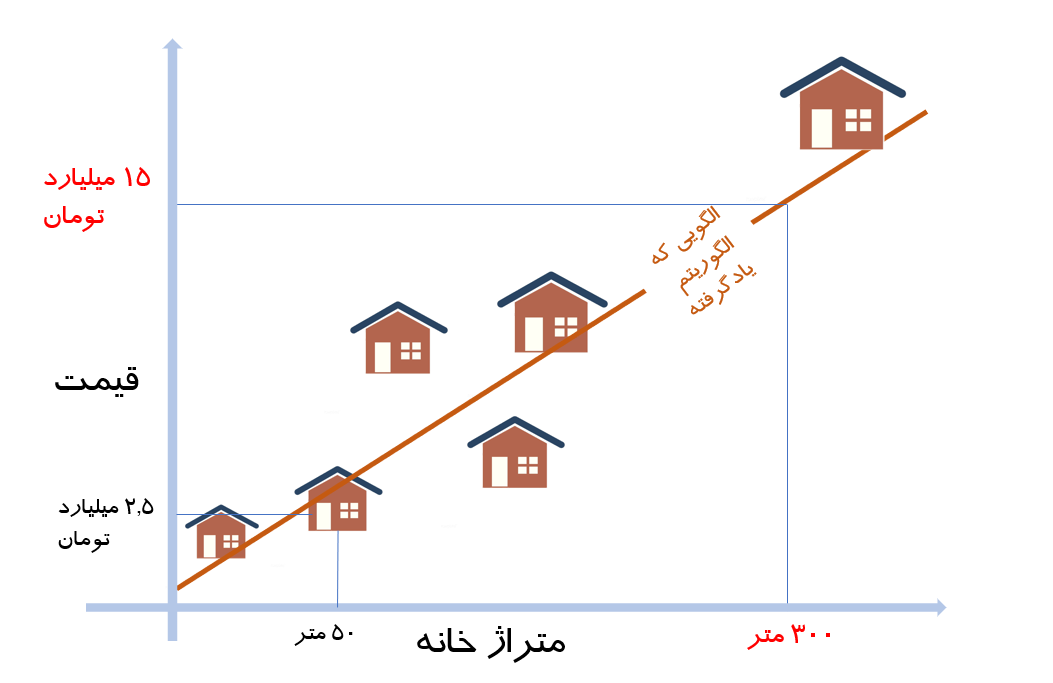
یادگیری بانظارت: در این نوع از یادگیری، نمونههایی که برای آموزش الگوریتم استفاده میشوند، دارای برچسب هستند. الگوریتمهای یادگیری نظارتشده، به دو دسته طبقهبندی(classification) و رگرسیون(regression) دستهبندی میشوند.
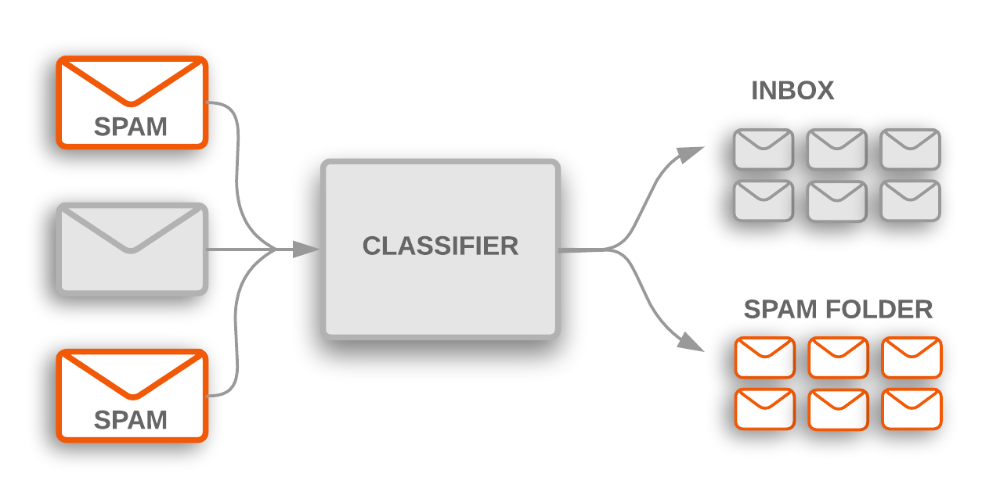
در مدل طبقه بندی شده هدف پیدا کردن برچسب یا دسته مناسب برای نمونههای بدون برچسب میباشد.مثل اسپم بودن یا نبودن ایمیل است.در الگوریتمهای طبقهبندی پیشبینی به صورت متغیری گسسته میباشد. در الگوریتمهای رگرسیونی، برخلاف طبقهبندی، برچسب پیشبینی به صورت متغیری پیوسته است.
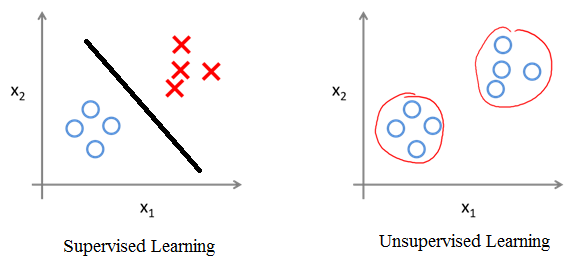
یادگیری بدون نظارت: تفاوت یادگیری بدون نظارت با یادگیری نظارتشده، تنها در نبودن برچسبها است. در این روش، مدل به تنهایی و بدون کمک برچسبهایی که در روش نظارتشده دیدیم، باید الگوهای پنهان را پیدا کند. از یادگیری بینظارت اکثرا برای تحلیل اکتشافی دادهها و خوشهبندی استفاده میشود. الگوریتم یادگیری بدون نظارت، به طور کلی به سه دسته خوشهبندی (clustering)، کاهش ابعاد (dimensionality reduction) و استخراج قانون وابستگی(association rule mining) تقسیمبندی میشود.
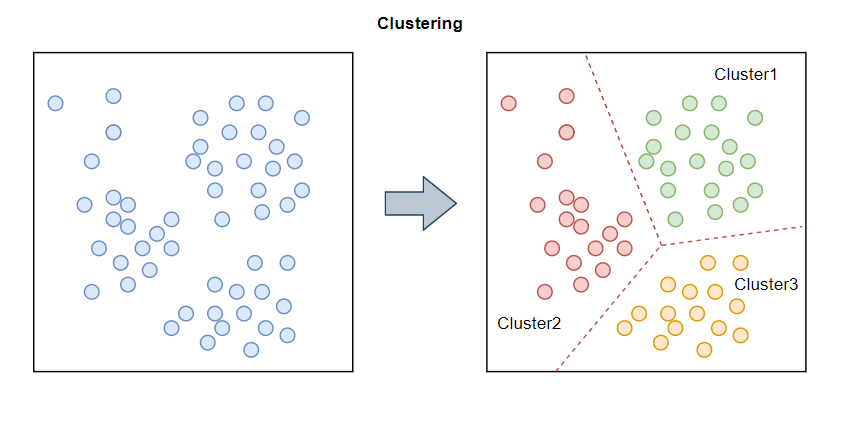
خوشه بندی: خوشهبندی به معنی دستهبندی اتوماتیک دادهها به خوشههای همگن است، باید دادههای هر خوشه، ویژگیهای یکسانی داشته باشند. اولین گام برای خوشهبندی دادهها، انتخاب کردن معیاری برای خوشهبندی است؛ به عنوان مثال برای سنجش فاصله بین داده ها باید معیاری انتخاب کنیم. فاصله اقلیدسی یکی از پرکاربردترین معیارهای سنجش فاصله است.
کاهش ابعاد: در ساده ترین حالت، کاهش دادن تعداد ویژگیهایی که برای آموزش مدل یادگیری ماشین خود استفاده میکنیم. به طور مثال، کاهش دادن تعداد ستونهای یک دیتاست جدولی، حالتی از کاهش ابعاد است.
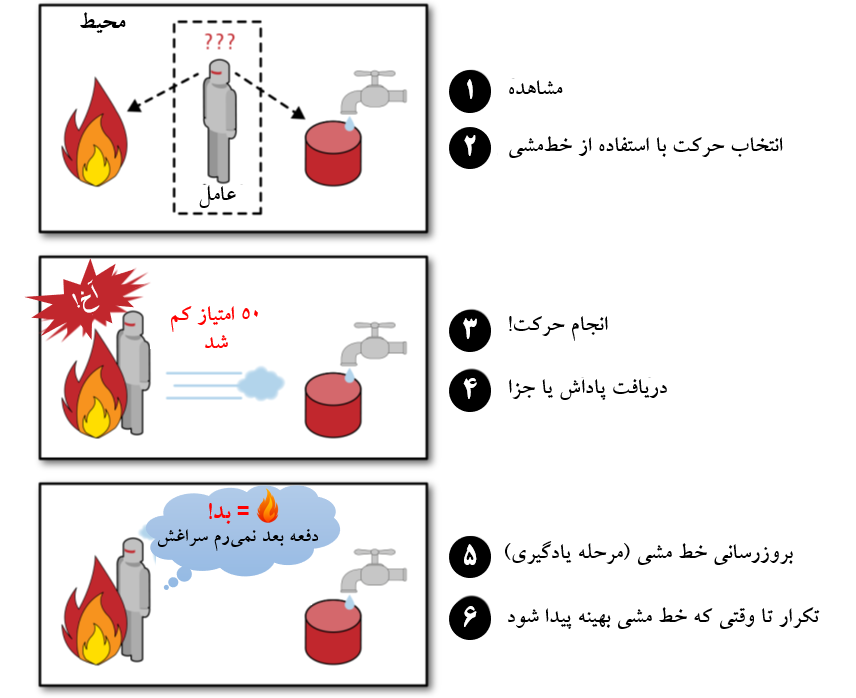
یادگیری تقویتی: با ذهنیت آزمون و خطا کار میکند. عامل هوشمند (agent) طبق حالت جاری (state) ، حرکتی (action) انجام میدهد و بر اساس آن حرکت بازخورد (reward) دریافت میکند؛ این بازخورد ممکن است مثبت یا منفی (پاداش یا تنبیه) باشد و عامل با این بازخورد خطمشی (policy) خود را تغییر میدهد. یادگیری تقویتی برخلاف یادگیری بانظارت و یادگیری بینظارت وابسته به داده نیست، بلکه به واسطه تعامل با محیط میآموزد.
سنجش یادگیری: برای بررسی دقت مدل آموزش داده شده (یا اصطلاحا سنجهp مدل)، باید پاسخهای آن را روی دادهی جدیدی تست کرد. به دادگانی که برای آموزش استفاده میشوند، دادگان آموزش(train) و به دادگانی که برای ارزیابی استفاده میشوند، دادگان آزمایش (test) میگوییم.
آشنایی کلیای با کتابخانههای محبوب هوش مصنوعی:
داده از منابع مختلفی جمعآوری میشود (عکس، متن، صدا و ...) اما در نهایت به شکل آرایهای از اعداد درمیآید. ذخیرهسازی و پردازش بهینهی آرایههای عددی از اهمیت بسیاری برخوردار است. کتابخانه مختص این کار در پایتون نامپای نام دارد که مخفف numeric python به معنی پایتون عددی میباشد. در نامپای اعضای یک آرایه همه از یک نوع میباشند و این ویژگی باعث میشود تا آرایهها حجم کمتری در رم اشغال کنند و پردازش و محاسبات روی آرایهها سریعتر انجام میشود.
پانداس از نامپای در بطن خود استفاده میکند. ساختار اصلی داده به شکل دیتافریم (data frame) است که در واقع یک آرایه دوبعدی است که در آن سطرها و ستونها عنوان دارند.
برای محاسبات سریع بر روی دادههای جدولی میتوان از آن استفاده کرد. اما هنگامی که ما انتظار انعطافپذیری بیشتری داریم، محدودیتهای نامپای به چشم میآید. با استفاده از ساختارهای داده و امکاناتی که در پانداس تعبیه شده، عملیات تحلیل و پاکسازی و آمادهسازی داده را در پایتون میتوان خیلی سریع و آسان انجام داد.
در تحلیل داده برای ساخت نمودارهایی که بتوانند اطلاعات را به خوبی انتقال دهند، استفاده می شود. برای مثال، مشاهده روند داده و تشخیص دادههای پرت از روی نمودار است. این کتابخانه بیشتر در ساخت نمودارهای ۲ بعدی کاربرد دارد.
سایکتلرن حاوی ابزارهای متنوعی برای یادگیری ماشین و مدلسازی آماری است و با کتابخانههایی که پیش از این معرفی کردیم، هماهنگی بسیار خوبی دارد. هدف از ساخت سایکتلرن تمرکز بر مدلسازی داده به جای دستکاری و مرتبسازی و خلاصه کردن داده میباشد.
علاوه بر موارد ذکر شده، میتوان از کتابخانه های پلاتلی (Plotly) و سیبورن (Seaborn) هم استفاده کرد. برای امور یادگیری عمیق، پایتورچ (Pytorch) ، تنسورفلو (TensorFlow) و کراس (Keras) بیشتر مورد استفاده قرار میگیرند. برای پردازش متن nltk و اسپیسی (Spacy) کارایی بیشتری دارند و در زمینه پردازش عکس میتوان از کتابخانههای اوپن سیوی (OpenCV) و سایکت ایمیج (scikit-image) نام برد.
چالش های داده و چالش های الگوریتمی:
چالش های مربوط به داده: داده اساس یادگیریماشین است و هیچ الگوریتم و مدلی با داده بد نمیتواند عملکرد خوبی داشته باشد. کمیت نامناسب داده، داده بیکیفیت و ویژگیهای نامربوط از جمله چالشهایی است که به داده مربوط میشوند.
تعداد ناکافی: اگر به تعداد کافی داده به الگوریتم تزریق نکنیم، نمیتوانیم انتظار عملکرد خوبی داشته باشیم.
داده بی کیفیت: داده بیکیفیت پر است از مقادیر اشتباه و گمشده.
ویژگی های نامناسب: باید سعی در انتخاب ویژگیهایی داشته باشیم که مدل بتواند از آنها بیاموزد و از دل آنها الگوهایی برای پیشبینی آینده استخراج کند.
چالش های الگوریتمی: بیشبرازش (Overfitting)، کمبرازش (Underfitting) و زمان نمونهای از چالشهای الگوریتمی می باشد.
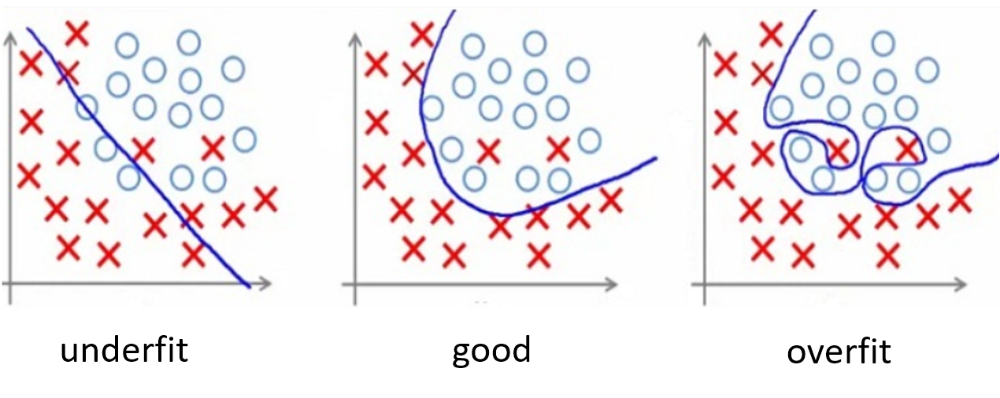
مسئله Overfitting: مدل نمیتواند آینده را به درستی پیشبینی کند. علت عدم توانایی در پیشبینی آینده این است که دادههای آموزش را زیاد از حد یاد گرفته است.
مسئله Underfitting: مدل نمی تواند به خوبی از دادگان آموزش، یاد بگیرد. داده نامناسب یکی از چندین دلیل کمبرازش است.منظور از داده نامناسب آن است که داده به قدری بیکیفیت است که اطلاعات دقیق و جامعی از هدفی که قصد مدل کردن آن را داریم به دست نمیدهد.
مسئله زمان: فرایند آموزش مدل به زمانبر بودن معروف است. الگوریتمها برای یادگیری زمان زیادی مصرف میکنند؛ بنابراین باید مدلی انتخاب کنیم که پیچیدگی زمانی خوبی داشته باشد.
گامهایی که در یک پروژه یادگیری ماشین طی می شود:
شرکت های پیشرو در هوش مصنوعی:
این شرکت، که در لندن و در سال 2010 پایه گذار شددر سال ۲۰۱۴ توسط گوگل خریداری شد. عامل هوشمند معروف AlphaGo که موفق به شکست قهرمان جهان در بازی Go که پیچیدگی خیلی بیشتری از شطرنج دارد توسط دیپمایند طراحی شد. یکی دیگر از محصولات این شرکت، AlphaFold است که پیشبینی دقیقی از ساختار سه بعدی پروتئینها ارائه میدهد و دستاورد ویژهای در حوزهی زیستشناسی به حساب میآید. از دیگر پروژههای دیپمایند میتوان به تشخیص بیماریهای چشمی از روی تصاویر، بهینه کردن انرژی در مراکز دادهی گوگل و بهبود محصولات گوگل با استفاده از هوش مصنوعی اشاره کرد.
در سانفرانسیسکوی آمریکا در سال ۲۰۱۵ تاسیس شد مدل زبانی GPT-3 و مدل ساخت تصاویر از روی متن DALL.E از محصولات این شرکت هستند که سر و صدای زیادی به پا کردهاند.
معروفترین محصول شرکت فیسبوک یک کتابخانهی متنباز یادگیری ماشین به نام PyTorch است که محبوبیت بسیاری پیدا کرده است. این ابزار به واسطهیسادگی در استفاده و امکانات زیادی که دارد در حال حاضر پذیرفتهترین بستر برای پیادهسازی الگوریتمهای هوش مصنوعی در جامعهیدانشگاهی به حساب میآید.
یک زیرمجموعه شرکت گوگل به نام Google Brain که قدمتی طولانی دارد و به تحقیق در زمینهی هوش مصنوعی مبادرت میورزد. جدیترین رقیب PyTorch که یکسال پیش از آن منتشر شد متعلق به Google Brain است و TensorFlow نام دارد. این کتابخانه همچنان در صنعت بیشترین استفاده را برای پیاده سازی الگوریتمهای یادگیری ماشین دارد.

