
معماری نرمافزار را میشود اینطور تعریف کرد: مجموعه تصمیمهایی که عوض کردنشان بعداً گران است. انتخاب زبان و فریمورک، نحوه تقسیم کد به ماژولها، مدل داده، روش احراز هویت و نحوه استقرار، همه از این جنساند. بقیه چیزها را معمولاً میشود در مسیر اصلاح کرد.
در این یادداشت یک وباپلیکیشن واقعی را لایهبهلایه میسازیم و در هر لایه توضیح میدهیم چه تصمیمی گرفته میشود و چرا. پشته فنی مثالها React و Django است، اما بیشتر اصول به پشتههای دیگر هم منتقل میشوند. این نوشته نسخهای «درست برای همه» نیست؛ هر بخش جایی که انتخاب به شرایط پروژه بستگی دارد، این را صریح گفته است.
یک سناریوی فرضی ولی معمول را در نظر بگیرید: یک شرکت پخش میخواهد مشتریانش (فروشگاهها) سفارشهایشان را آنلاین ثبت کنند. تیم فروش سفارشها را بررسی و تأیید میکند، انبار موجودی را میبیند و آمادهسازی را شروع میکند، و مدیر گزارش فروش میخواهد. سه نوع کاربر، چند فرایند بههموابسته و دادهای که نباید خراب شود. مثال خوبی است، چون تقریباً همه مسائل یک سیستم سازمانی در آن هست.
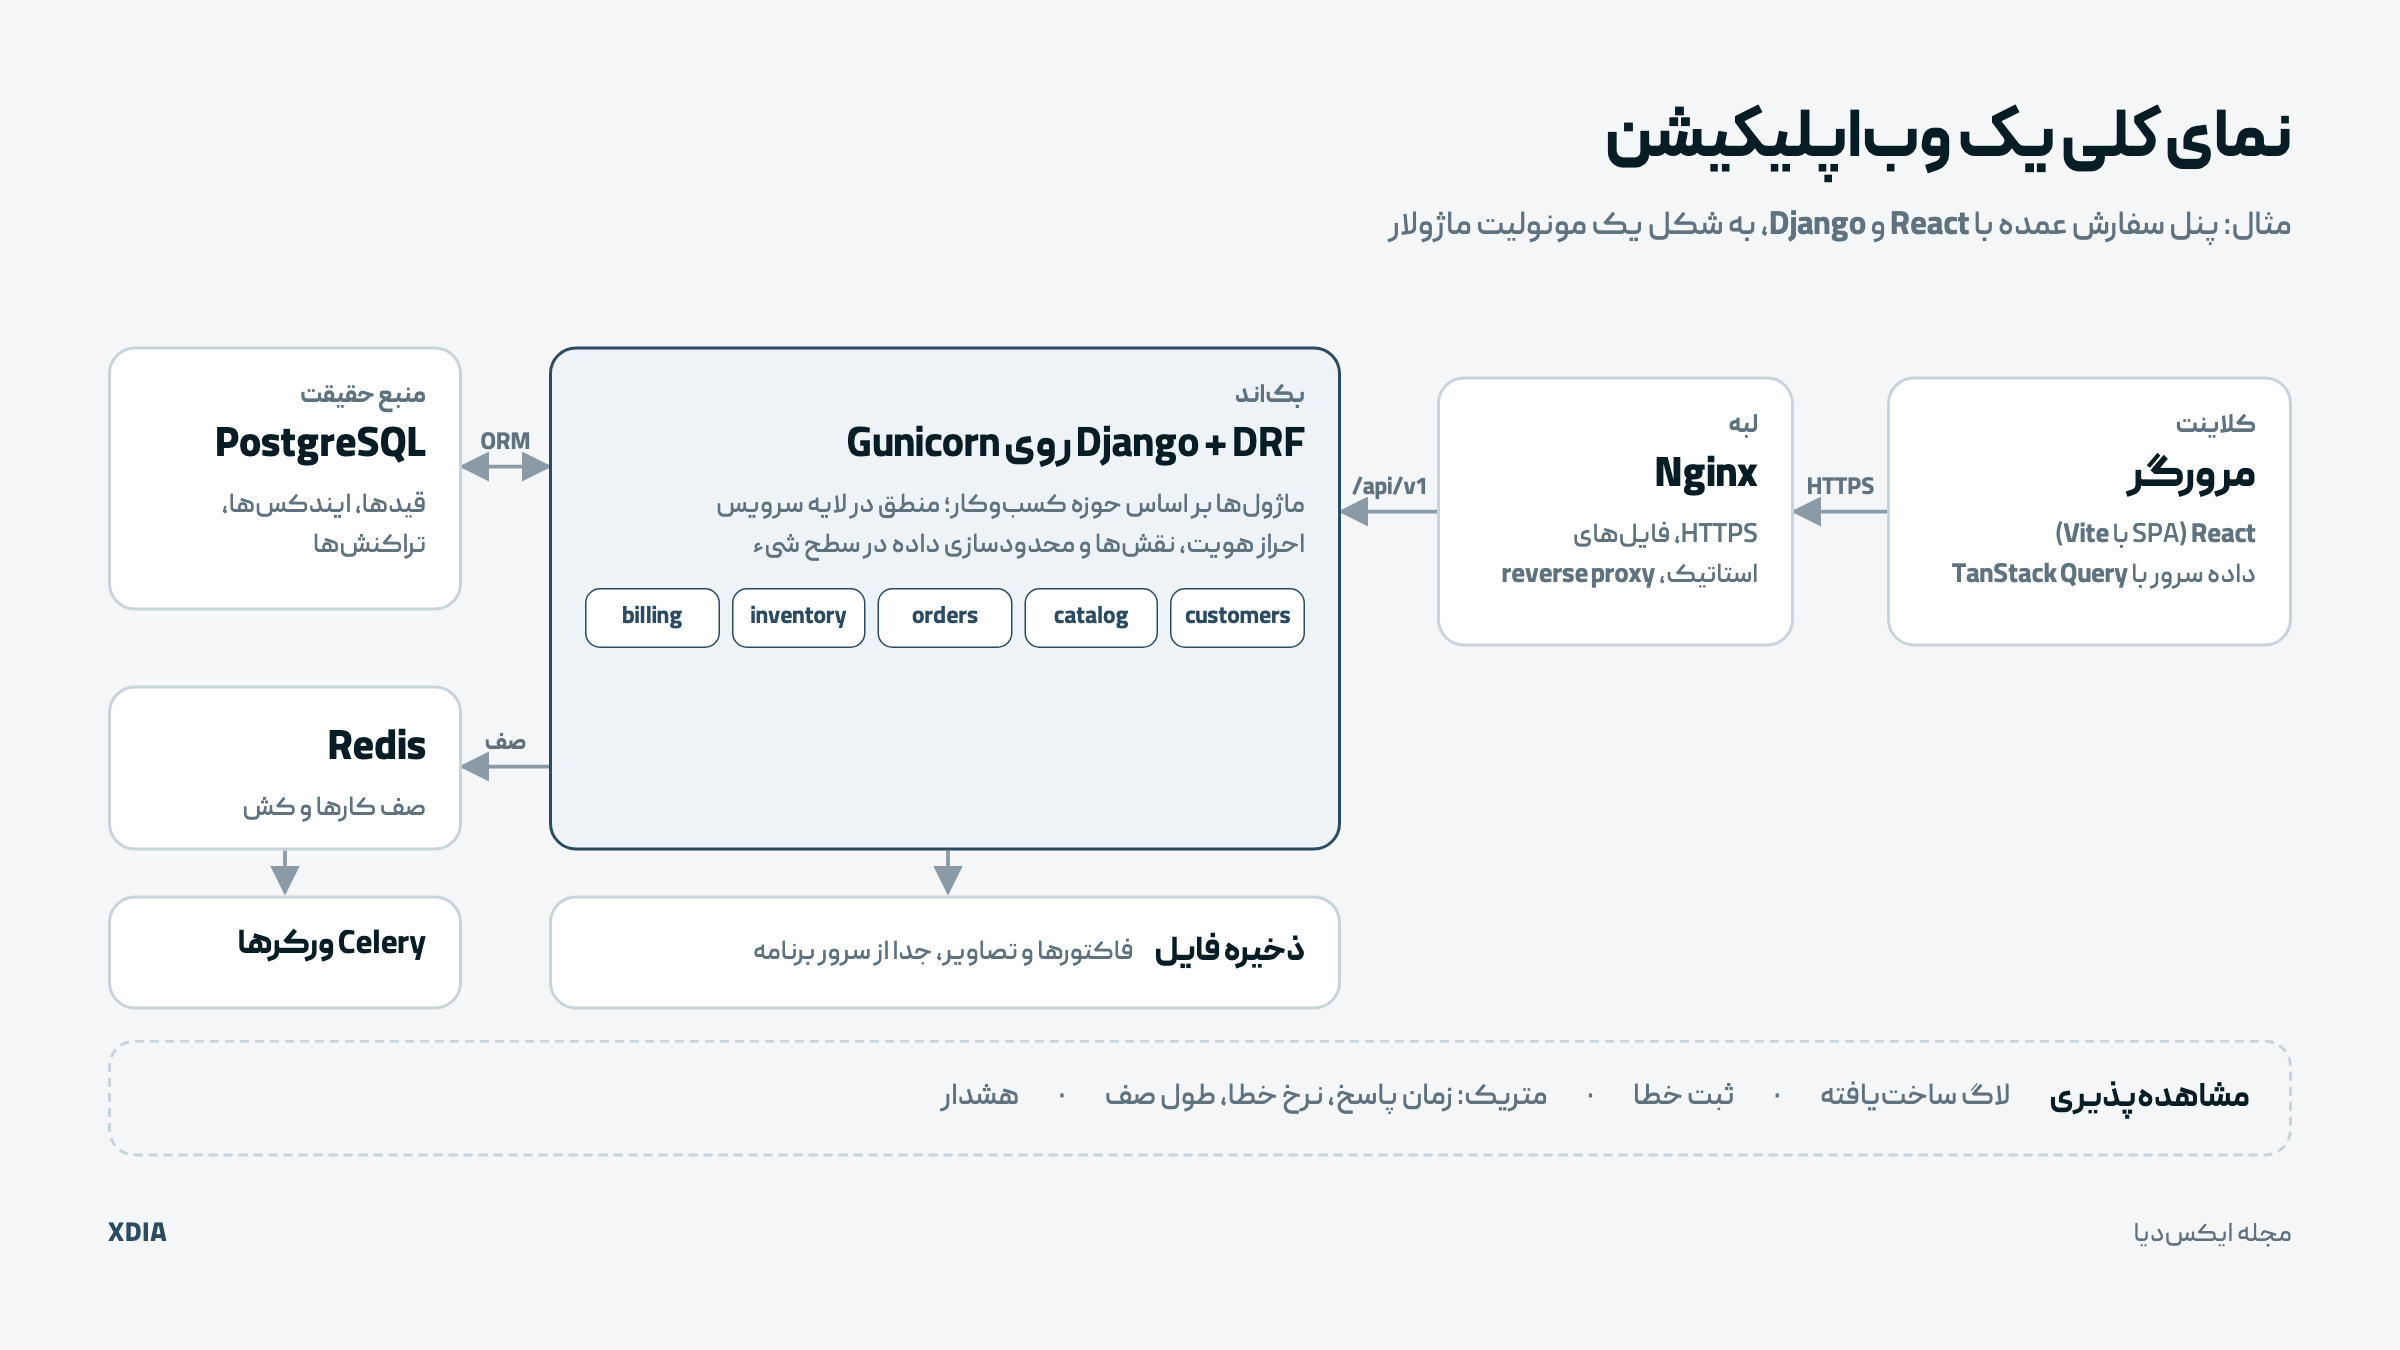
در سادهترین شکل حرفهای، اجزای سیستم اینها هستند:
کلاینت: اپلیکیشن React که در مرورگر اجرا میشود.
لبه: Nginx بهعنوان reverse proxy که HTTPS را مدیریت میکند، فایلهای استاتیک را سرو میکند و درخواستهای API را به بکاند میفرستد.
بکاند: Django و Django REST Framework که روی Gunicorn اجرا میشوند.
پایگاه داده: PostgreSQL بهعنوان منبع اصلی حقیقت.
کارهای پسزمینه: Celery با Redis بهعنوان صف، برای کارهایی مثل ارسال پیامک و ساخت گزارش.
ذخیره فایل: فضای ذخیرهسازی جدا از سرور برنامه، برای فاکتورها و تصاویر.
مشاهدهپذیری: لاگ، ثبت خطا و متریک، تا بدانیم سیستم در عمل چه میکند.
نکته مهم این است که همه اینها میتوانند داخل یک «مونولیت ماژولار» باشند: یک پروژه Django، یک پایگاه داده، یک بار استقرار. شروع با میکروسرویس برای چنین سیستمی معمولاً پیچیدگیای اضافه میکند که هنوز هیچ مسئلهای را حل نکرده است.
اولین تصمیم این است که صفحهها در مرورگر ساخته شوند (SPA) یا روی سرور (SSR). برای پنلی که پشت صفحه ورود است و موتور جستوجو قرار نیست آن را ببیند، یک SPA ساده با Vite کافی و کمهزینه است. اگر بخشی از سیستم عمومی است و باید در گوگل دیده شود، مثلاً کاتالوگ محصولات، فریمورکی مثل Next.js که رندر سمت سرور دارد منطقیتر است.
دو اصل در فرانتاند بیشترین اثر را روی نگهداریپذیری دارند:
داده سرور را از وضعیت رابط کاربری جدا کنید. لیست سفارشها مال سرور است و باید با ابزاری مثل TanStack Query کش، تازهسازی و هماهنگ شود. باز یا بسته بودن یک منو مال رابط کاربری است. قاطی کردن این دو، منشأ بخش بزرگی از باگهای «داده قدیمی» است.
قانون کسبوکار فقط در فرانتاند نباشد. اعتبارسنجی فرم در مرورگر برای تجربه کاربری خوب است، اما هر قانونی که اهمیت دارد، مثل سقف اعتبار مشتری، باید در بکاند هم بررسی شود. هر چیزی که در مرورگر است، قابل دور زدن است.
اپهای Django را بر اساس مفاهیم کسبوکار تقسیم کنید، نه لایههای فنی: customers، catalog، orders، inventory، billing. هر ماژول مدلها، منطق و API خودش را دارد و وابستگیهای بین ماژولها باید کم و آگاهانه باشد.
منطق کسبوکار را هم در view یا serializer پخش نکنید. یک لایه سرویس، یعنی توابع ساده پایتون که یک عملیات کامل کسبوکار را انجام میدهند، هم تست کردن را راحت میکند و هم اجازه میدهد همان منطق از API، پنل ادمین یا یک کار پسزمینه صدا زده شود. مثلاً ثبت سفارش و رزرو موجودی:
# orders/services.py from django.db import transaction from django.db.models import F from inventory.models import Stock from .models import Order class OutOfStock(Exception): pass def place_order(*, customer, items): with transaction.atomic(): # Lock the stock rows so two concurrent orders can't oversell stocks = { s.product_id: s for s in Stock.objects.select_for_update().filter( product_id__in=[i.product_id for i in items] ) } for item in items: stock = stocks.get(item.product_id) if stock is None or stock.quantity < item.quantity: raise OutOfStock(item.product_id) order = Order.objects.create(customer=customer) for item in items: order.lines.create(product_id=item.product_id, quantity=item.quantity) Stock.objects.filter(pk=stocks[item.product_id].pk).update( quantity=F("quantity") - item.quantity ) return order
دو نکته در همین چند خط هست: همه تغییرات در یک تراکنش انجام میشوند، پس یا کل سفارش ثبت میشود یا هیچچیز. و select_for_update ردیفهای موجودی را قفل میکند تا دو سفارش همزمان نتوانند آخرین کالای انبار را هر دو بخرند. این نوع خطا در محیط توسعه تقریباً هیچوقت دیده نمیشود و در محیط واقعی، در شلوغترین روز سال سر میزند.
API قرارداد بین فرانتاند و بکاند است و هرچه پایدارتر باشد، دو تیم مستقلتر کار میکنند. چند تصمیمی که ارزش دارد از روز اول گرفته شود:
منابع و افعال روشن: GET /api/v1/orders/ برای فهرست، POST /api/v1/orders/ برای ثبت. عملیاتهایی که در قالب CRUD نمیگنجند، مثل تأیید سفارش، میتوانند endpoint جدا داشته باشند: POST /api/v1/orders/{id}/approve/.
نسخهبندی: پیشوند v1 هزینهای ندارد و روزی که لازم شود قرارداد را بشکنید، کمکتان میکند.
صفحهبندی برای همه فهرستها: فهرستی که امروز پنجاه ردیف دارد، دو سال بعد پنجاه هزار ردیف دارد.
قالب خطای یکسان: فرانتاند باید بتواند همه خطاها را به یک شکل بخواند و نمایش دهد.
Idempotency برای عملیات حساس: اگر کاربر دکمه پرداخت را دو بار زد یا شبکه درخواست را تکرار کرد، نباید دو تراکنش ثبت شود. یک کلید یکتا که کلاینت همراه درخواست میفرستد، این مشکل را حل میکند.
مستندات خودکار: ابزاری مثل drf-spectacular از روی کد، مستند OpenAPI میسازد و مستندات را با واقعیت هماهنگ نگه میدارد.
کد عوض میشود، اما داده میماند. به همین دلیل قواعد مهم داده باید در خود پایگاه داده هم تعریف شوند، نه فقط در کد. اگر فردا اسکریپتی مستقیم روی دیتابیس اجرا شد یا باگی از اعتبارسنجی کد رد شد، دیتابیس جلوی داده نامعتبر را میگیرد:
class OrderLine(models.Model):
    order = models.ForeignKey(Order, related_name="lines", on_delete=models.CASCADE)
    product = models.ForeignKey("catalog.Product", on_delete=models.PROTECT)
    quantity = models.IntegerField()

    class Meta:
        constraints = [
            models.UniqueConstraint(
                fields=["order", "product"], name="uniq_product_per_order"
            ),
            # Django 5.1+; older versions use check= instead of condition=
            models.CheckConstraint(
                condition=models.Q(quantity__gt=0), name="line_quantity_positive"
            ),
        ]
چند اصل دیگر:
ایندکس را بر اساس کوئریهای واقعی بسازید، نه حدس. فیلترهای پرتکرار، مثل وضعیت سفارش و تاریخ، اولین نامزدها هستند.
مراقب مسئله N+1 باشید. نمایش صد سفارش همراه با نام مشتری نباید صد و یک کوئری بزند. select_related و prefetch_related در Django برای همین ساخته شدهاند.
حذف واقعی را با احتیاط انجام دهید. on_delete=PROTECT برای محصولی که در سفارشهای قبلی آمده، جلوی پاک شدن ناخواسته تاریخچه را میگیرد.
این یکی از بحثبرانگیزترین تصمیمهاست و جواب درست به نوع کلاینت بستگی دارد. اگر فرانتاند و API روی یک دامنه (یا زیردامنههای یک دامنه) هستند، سشنهای خود Django با کوکی HttpOnly و محافظت CSRF ساده و امن است؛ جاوااسکریپت به کوکی دسترسی ندارد و ابطال نشست هم ساده است.
توکنها، مثل JWT، وقتی مزیت دارند که کلاینتهای متنوع دارید: اپ موبایل، سرویسهای دیگر یا API عمومی. در این حالت عمر توکن دسترسی را کوتاه نگه دارید و توکن را در localStorage ذخیره نکنید، چون هر آسیبپذیری XSS میتواند آن را بخواند. انتخاب JWT فقط به این دلیل که «مدرنتر است»، معمولاً پیچیدگی ابطال و نوسازی توکن را بیدلیل به پروژه اضافه میکند.
برای ورود با کد یکبارمصرف پیامکی هم، محدودیت تعداد درخواست (rate limit) برای هر شماره و هر IP ضروری است؛ هم برای امنیت، هم برای قبض پنل پیامک.
احراز هویت میگوید کاربر کیست؛ مجوزدهی میگوید چه کاری مجاز است. در مثال ما، کنترل دسترسی مبتنی بر نقش (RBAC) نقطه شروع خوبی است: فروشنده، انباردار، مدیر. اما RBAC بهتنهایی کافی نیست. فروشندهای که اجازه دیدن سفارشها را دارد، فقط باید سفارشهای مشتریان خودش یا سازمان خودش را ببیند. این «دسترسی در سطح شیء» است و بهترین جایش، محدود کردن queryset در خود بکاند است:
class HasRole(BasePermission):
    """Roles per action are declared on the view; undeclared actions are denied."""

    def has_permission(self, request, view):
        allowed = getattr(view, "required_roles", {}).get(view.action, [])
        return request.user.groups.filter(name__in=allowed).exists()


class OrderViewSet(viewsets.ModelViewSet):
    serializer_class = OrderSerializer
    permission_classes = [IsAuthenticated, HasRole]
    required_roles = {
        "list": ["sales", "manager"],
        "retrieve": ["sales", "manager"],
        "create": ["sales", "manager"],
        "partial_update": ["manager"],
        "destroy": ["manager"],
    }

    def get_queryset(self):
        # Scope every query to the user's organization
        return (
            Order.objects.filter(organization=self.request.user.organization)
            .select_related("customer")
            .prefetch_related("lines__product")
        )
به پیشفرض این کد دقت کنید: اگر برای عملیاتی نقشی تعریف نشده باشد، دسترسی رد میشود. پیشفرض «بسته» یعنی فراموش کردن یک خط، بهجای حفره امنیتی، یک خطای ۴۰۳ میسازد که سریع دیده و اصلاح میشود. مخفی کردن دکمهها در فرانتاند خوب است، اما امنیت نیست.
هر کاری که کند است یا به سرویس بیرونی وابسته است، نباید کاربر را منتظر نگه دارد: ارسال پیامک تأیید سفارش، ساخت فایل گزارش ماهانه، همگامسازی با نرمافزار حسابداری. این کارها به صف Celery میروند. دو قاعده را فراموش نکنید: کارها باید قابل تکرار بدون اثر جانبی (idempotent) باشند، چون ممکن است دو بار اجرا شوند؛ و برای خطاهای موقت مثل قطعی سرویس پیامک، تلاش مجدد با فاصله رو به افزایش تعریف کنید.
هدف استقرار خوب این است که انتشار نسخه جدید یک کار عادی و کماسترس باشد، نه یک رویداد. چند جزء اصلی:
کانتینر: Docker محیط اجرای یکسان میسازد؛ چیزی که روی سیستم توسعهدهنده کار میکند، روی سرور هم کار میکند.
تنظیمات و رمزها بیرون از کد: رمز پایگاه داده، کلیدهای API و SECRET_KEY از متغیرهای محیطی یا یک مدیر رمز خوانده شوند و هیچوقت در مخزن کد نباشند.
CI: هر تغییر قبل از ادغام، تستها را پاس کند. استقرار از شاخه اصلی و با یک فرمان یا خودکار.
مهاجرتهای سازگار با عقب: اگر قرار است ستونی را تغییر نام دهید، اول ستون جدید را اضافه کنید، کد را طوری منتشر کنید که با هر دو کار کند، داده را منتقل کنید و در انتشار بعدی ستون قدیمی را حذف کنید. این الگو اجازه میدهد بدون قطعی منتشر کنید و در صورت نیاز به نسخه قبل برگردید.
پشتیبان و تست بازیابی: پشتیبانی که هیچوقت بازیابیاش آزمایش نشده، فقط یک فرض است.
بیشتر رخنهها از اشتباههای ساده میآیند، نه حملههای پیچیده. این فهرست جای ممیزی امنیتی را نمیگیرد، اما حداقلی است که هر وباپلیکیشنی باید داشته باشد:
HTTPS همهجا، و DEBUG = False و ALLOWED_HOSTS درست در محیط تولید.
اتکا به ORM برای کوئریها؛ هرجا SQL خام لازم شد، فقط با پارامتر، هرگز با چسباندن رشته.
React خروجی را بهطور پیشفرض escape میکند؛ هر استفاده از dangerouslySetInnerHTML باید دلیل و پاکسازی داشته باشد.
محدودیت نرخ درخواست برای ورود، فراموشی رمز و ارسال کد.
بهروزرسانی منظم وابستگیها و بررسی آسیبپذیریهای شناختهشده آنها.
ثبت رویدادهای حساس، مثل تغییر نقش کاربران، برای پیگیری بعدی.
بیشتر سیستمهای سازمانی هیچوقت به مرزی نمیرسند که یک سرور خوب و یک پایگاه داده تنظیمشده از پسش برنیاید. بیشتر پروژهها زیر بار پیچیدگی از پا درمیآیند، نه زیر بار ترافیک. پس بهجای طراحی برای میلیونها کاربر خیالی، سیستم را طوری بسازید که اگر روزی لازم شد، بشود مقیاسش را بالا برد:
سرورهای برنامه بیحالت (stateless) باشند تا بشود چند نسخه از آنها را پشت load balancer گذاشت.
فایلها روی دیسک سرور برنامه ذخیره نشوند.
کش فقط برای جاهایی که اندازهگیری نشان داده کند هستند؛ کش زودهنگام، باگ «داده قدیمی» میسازد.
پایگاه داده معمولاً آخرین گلوگاه است: اول کوئری و ایندکس، بعد سختافزار، بعد نسخههای فقطخواندنی.
هرم تست هنوز راهنمای خوبی است: تعداد زیادی تست واحد برای لایه سرویس، که سریع اجرا میشوند و منطق کسبوکار را پوشش میدهند؛ تستهای API با APIClient برای بررسی مجوزها و قرارداد پاسخها؛ و چند تست سرتاسری با ابزاری مثل Playwright فقط برای مسیرهای حیاتی، مثل ثبت و تأیید سفارش. تست مجوزها را جدی بگیرید: «فروشنده سازمان الف نباید سفارش سازمان ب را ببیند» دقیقاً همان تستی است که بعداً جانتان را نجات میدهد.
بعد از استقرار، مانیتورینگ جای تست را میگیرد. سه چیز لازم دارید: لاگ ساختیافته که بشود در آن جستوجو کرد، ثبت خطا با جزئیات (ابزاری مثل Sentry که نسخه خودمیزبان هم دارد)، و چند متریک کلیدی مثل زمان پاسخ، نرخ خطا و طول صف کارهای پسزمینه. هشدارها را هم فقط برای چیزهایی تعریف کنید که واقعاً باید کسی را بیدار کنند؛ هشداری که هر روز بیدلیل میآید، روزی که دلیل دارد هم نادیده گرفته میشود.
ساختار کلی: مونولیت ماژولار. وقتی تیمهای مستقل یا نیاز مقیاس جداگانه پیدا شد، سراغ جدا کردن سرویسها بروید.
فرانتاند: SPA برای پنلهای پشت ورود؛ SSR برای صفحههایی که باید در جستوجو دیده شوند.
احراز هویت: سشن روی دامنه یکسان؛ توکن وقتی کلاینت موبایل یا سرویس بیرونی دارید.
مجوزدهی: نقشها بهعلاوه محدود کردن داده در سطح شیء، با پیشفرض بسته.
پایگاه داده: یک PostgreSQL با قیدهای درست. نسخه فقطخواندنی وقتی اندازهگیری گفت لازم است.
کارهای کند: صف پسزمینه با کارهای idempotent.
استقرار: کانتینر، CI و مهاجرتهای سازگار با عقب، از همان نسخه اول.
معماری خوب، معماریای نیست که همه اینها را از روز اول داشته باشد. معماریای است که هر تصمیمش دلیل روشنی دارد، جاهایی که ممکن است عوض شوند را باز نگه میدارد و بقیه را تا جای ممکن ساده میگیرد. اگر قرار است فقط یک جمله از این نوشته در ذهنتان بماند، این باشد: پیچیدگی را وقتی اضافه کنید که مسئلهاش را دیدهاید، نه وقتی که تصورش را کردهاید.

