
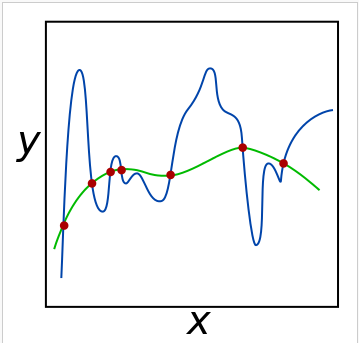
یکی از رایج ترین مشکلاتی که تحلیلگران داده با اون سر کار دارند، بحث Overfitting هست. به این معنی هست که مدل شما روی داده های train درست کار می کنه اما برای دیتاست تست درست کار نمی کنه.
چه زمانی Overfitting اتفاق میوفته ؟
زمانی اتفاق میوفته که یک مدل بیش از اندازه پیچیده است.
مدلی که Overfitting داره، در پیش بینی ضعیف عمل می کنه. مثل :
در تصویر زیر، مدل ما در دیتاست train خوب کار می کنند اما با داده های test مشکل پیدا می کنه.
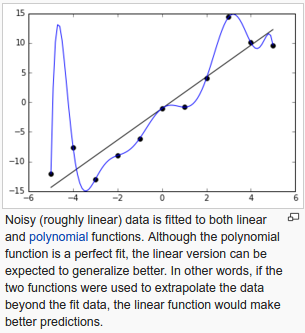
برعکس هم می تونه اتفاق بیوفته، یعنی مدل ها می تونن از underfitting هم رنج ببرند!!!
به این معنی هست که مدل ما به اندازه کافی پیچیدگی لازم رو نداره جهت بدست آوردن داده های train. پس مدل ما خوب آموزش ندیده.
برای اینکه جلو Overfitting رو بگیریم، لازم هست که از یکسری تکنیک های اضافی استفاده کنیم. مثل : cross-validation, regularization, early stopping, pruning, یا Bayesian priors
روش Regularization ، راهی برای پیدا کردن یک bias-variance tradeoff خوب هست که با تنظیم پیچیدگی مدل اتفاق میوفته. این یک روش فوق العاده مفیدی هست برای مدیریت کردن collinearity یا همبستگی (منظور همون همبستگی زیاد بین ویژگی هاست)، پیدا کردن نویز داده ها و در نهایت جلوگیری از Overfitting هست.
منطق پایه ای regularization، به معرفی اطلاعات اضافی یا (bias) جهت کم کردن وزن پارامتر های مهم می پردازه.
رایج ترین شکل regularization ، به اصطلاح L2 regularization نامیده می شه. که از فرمول زیر محاسبه می شه :
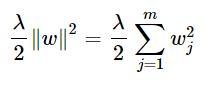
علامت لامبدا (لاندا) پارامتر regularization هست.
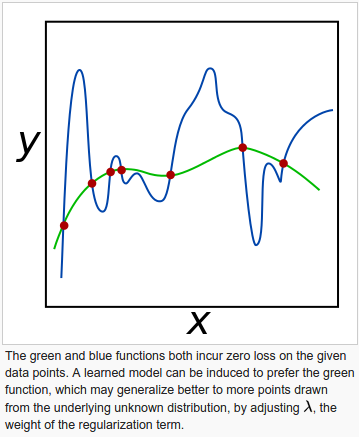
برای اعمال regularization در رگرسیون لوجستیک، ما فقط regularization رو به تابع هزینه باید اضافه کنیم. در نهایت وزن ها کم تر می شه.
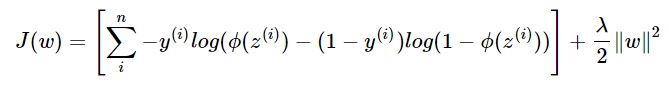
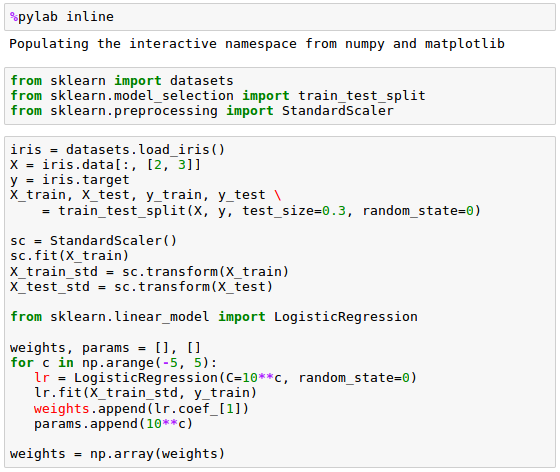
اگه بخوایم برنامه اش رو بنویسیم به این صورته :
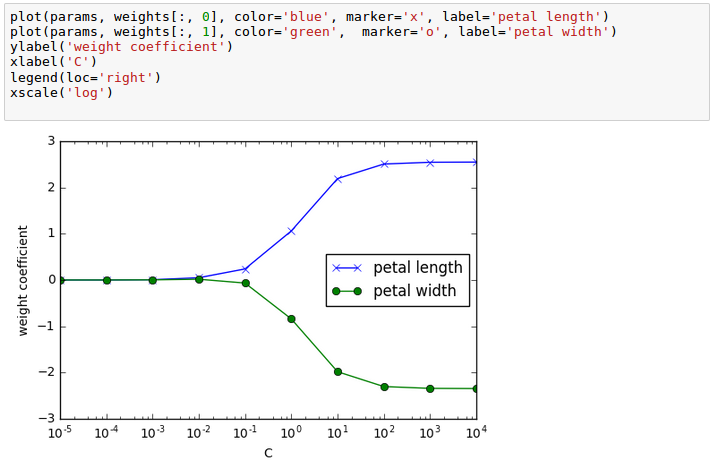
خب به انتهای این نوشته رسیدیم.
همچنین سورس این داکیومنت رو می تونید از اینجا ببینید.
امیدوارم این نوشته براتون مفید بوده باشه
از همراهیتون صمیمانه سپاسگزارم ...

