
نویسنده: وحید رستمی بانی، مشاور ارشد کسب و کار
آخرین بهروزرسانی: سپتامبر ۲۰۲۶
زمان مطالعه: ۳۰ دقیقه
دستهبندی: حاکمیت هوش مصنوعی، مدیریت ریسک، اعتبارسنجی خروجی، اعتماد سازمانی
خروجی هوش مصنوعی بهخودیخود «قابل اعتماد» نیست؛ اعتماد به آن باید با سه مکانیزم کنترلی «ساخته» شود:
اعتبارسنجی انسانی (Human-in-the-Loop): هیچ خروجی حساسی (مالی، حقوقی، پزشکی، عمومی) بدون تأیید یک انسانِ مسئول منتشر یا اجرا نشود.
تست مداوم و بررسی موردی (Continuous Auditing): نمونهگیری دورهای از خروجیها، اندازهگیری نرخ خطا، و اجرای تستهای قرمز (Red Teaming) برای کشف نقاط کور مدل.
تعریف «محدوده مجاز» (Authorized Scope): مشخص کردن دقیق اینکه ابزار در چه حوزههایی اجازه تصمیم مستقل دارد و در چه حوزههایی فقط حق «پیشنهاد» دارد.
مدل ذهنی درست: به هوش مصنوعی مثل یک کارآموز بسیار باهوش ولی بیتجربه نگاه کنید؛ آنقدر باهوش که کارها را سریع انجام دهد، اما آنقدر بیتجربه که هرگز نباید بدون نظارت، سند حساسی را امضا کند.
مقدمه: روزی که یک وکیل، پروندههای خیالی را به دادگاه برد
چرا نمیتوان به خروجی AI اعتماد کرد؟ مکانیزم توهم
طیف اعتماد: کجا مطمئن، کجا محتاط، کجا ممنوع؟
مکانیزم اول: اعتبارسنجی انسانی بدون ایجاد گلوگاه
مکانیزم دوم: تست مداوم و ممیزی خروجیها
مکانیزم سوم: تعریف «محدوده مجاز» تصمیمگیری
ابزارهای فنی اعتماد: از RAG با منبع تا امتیاز اطمینان
چکلیست عملیاتی اعتماد به خروجی AI
نتیجهگیری
پرسشهای متداول (FAQ)
سال ۲۰۲۳، استیون شوارتز، وکیل باتجربه نیویورکی، برای یک لایحه قضایی از ChatGPT کمک گرفت. خروجی، درخشان بود: استدلالهای منسجم، لحن حقوقی بینقص، و ارجاع به شش پرونده قضایی معتبر با شماره دادگاه و جزئیات دقیق. وکیل، با اعتماد به «دقت ماشین»، لایحه را ثبت کرد.
چند هفته بعد، وکیلِ طرف مقابل متوجه شد که هیچکدام از آن شش پرونده، در هیچ دادگاهی وجود خارجی ندارند. هوش مصنوعی، آنها را با اعتمادبهنفس کامل اختراع کرده بود. نتیجه؟ جریمه مالی، تحقیر حرفهای، و پروندهای که برای همیشه در تاریخ حقوق بهعنوان «رسوایی توهم هوش مصنوعی» ثبت شد.
این داستان فقط درباره وکلا نیست. این داستانِ هر مدیری است که یک گزارش مالی، یک پاسخ به مشتری، یا یک تصمیم استخدام را بدون اعتبارسنجی از هوش مصنوعی گرفته و اجرا کرده است. سؤال این مقاله، دقیقاً همان درسی است که آن وکیل با گرانترین قیمت ممکن آموخت: از کجا بدانیم خروجی هوش مصنوعی امن و قابل اعتماد است؟
برای اعتمادسازی، اول باید بفهمیم چرا ماشین گاهی دروغ میگوید — و چرا دروغهایش اینقدر متقاعدکنندهاند.
هوش مصنوعی مولد، یک «موتور حقیقتیاب» نیست؛ یک «موتور احتمال» است. مدل، کلمه به کلمه، محتملترین ادامه جمله را پیشبینی میکند. وقتی داده کافی ندارد یا سؤال در منطقه خاکستری است، باز هم «محتملترین» جمله را میسازد — نه درستترین را. و چون ساختار زبانی خروجی همیشه روان و مقتدر است، شکلِ جواب، هیچ نشانهای از صحتِ جواب نمیدهد.
این پدیده سه ویژگی خطرناک دارد:
اعتمادبهنفس کاذب: مدل هرگز نمیگوید «نمیدانم» مگر اینکه آموزش داده شده باشد؛ پس خطا، با لحن قطعیت بیان میشود.
جزئیات ساختگی: توهمها معمولاً با اعداد، تاریخها و نامهای دقیق همراهاند — دقیقاً همان چیزهایی که ذهن انسان را قانع میکنند.
عدم خودآگاهی: مدل نمیداند که نمیداند؛ پس نمیتوانید با «حس ششم» مدل، خطا را کشف کنید.
نتیجه مدیریتی: اعتماد به خروجی AI، یک تصمیم مدیریتی است، نه یک ویژگی فنی. و تصمیم مدیریتی، چارچوب میخواهد.
همه خروجیها ریسک یکسانی ندارند. هنر مدیریت اعتماد، طبقهبندی کارها بر اساس هزینه خطا است:
سطح ریسک
مثالها
سطح اعتماد مجاز
الزام کنترلی
سبز (کمریسک)
ایدهپردازی، پیشنویس ایمیل داخلی، خلاصه اسناد غیرحساس، ترجمه عمومی
استفاده آزاد
بازبینی سریع چشمی
زرد (متوسط)
محتوای منتشرشده عمومی، گزارشهای تحلیلی، کد تولیدی
استفاده مشروط
اعتبارسنجی تخصصی + تست
قرمز (حساس)
تصمیم مالی، حقوقی، پزشکی، استخدام، پیام بحران
ممنوع بدون تأیید
تأیید مکتوب انسان مسئول + منبعدهی اجباری
این جدول باید روی دیوار هر تیمی که با AI کار میکند نصب شود. قاعده طلایی: هرچه هزینه خطا بالاتر، زنجیره تأیید بلندتر.
بزرگترین اعتراض مدیران به Human-in-the-Loop این است: «اگر قرار است انسان همهچیز را چک کند، پس بهرهوری AI کجا رفت؟» راهحل، طراحی هوشمندانه است، نه حذف نظارت:
برای تصمیمهای حساس، تأیید یک نفر کافی نیست؛ تهیهکننده و تأییدکننده باید دو نفر متفاوت باشند — دقیقاً مثل سیستمهای مالی بانکی.
به جای خواندن کل خروجی، از اعتبارسنجکننده بخواهید فقط سه چیز را چک کند: اعداد، نامها، و ادعاهای علّی. اینها سه نقطهایاند که توهم بیشترین حضور را در آنها دارد.
یک تکنیک کمهزینه و مؤثر: قبل از تأیید، از خود هوش مصنوعی بپرسید: «این خروجی را نقد کن؛ کدام بخشها ممکن است نادرست باشند و چرا؟» مدلها در نقش منتقد، اغلب نقاط کور خودشان را آشکار میکنند.
هر خروجی تأییدشده باید یک «صاحب انسانی» داشته باشد که نامش پای آن است. وقتی مسئولیت شفاف شود، دقتِ بازبینی بهطور طبیعی بالا میرود.
اعتبارسنجی موردی کافی نیست؛ شما به یک سیستم اندازهگیری اعتماد نیاز دارید. سه لایه پیشنهاد میشود:
هفتهای درصد مشخصی از خروجیهای AI (مثلاً ۵ تا ۱۰ درصد) بهصورت تصادفی انتخاب و توسط متخصص بررسی شوند. نرخ خطای کشفشده، «دماسنج اعتماد» سازمان شماست. اگر نرخ خطا از آستانه تعریفشده (مثلاً ۲٪) عبور کرد، استفاده خودکار موقتاً متوقف میشود.
یک تیم داخلی یا خارجی، عمداً سعی میکند مدل را به خطا، توهم یا خروجی ناامن بکشاند — با پرامپتهای انحرافی، دادههای لبهای و سناریوهای فریب. این تستها باید بعد از هر بهروزرسانی مدل تکرار شوند.
مشتریان و کارکنان، اولین کسانیاند که خطای خروجی AI را در دنیای واقعی میبینند. یک کانال ساده «گزارش خطای AI» بسازید و هر گزارش را مثل یک Incident امنیتی ثبت و ریشهیابی کنید.
این مهمترین و کماجراترین مکانیزم است. بسیاری سازمانها میپرسند «آیا AI امن است؟» در حالی که سؤال درست این است: «AI در چه محدودهای امن است؟»
برای هر کاربرد AI، سه سطح اختیار تعریف کنید:
اختیار اجرا (Autonomous): ابزار خودش تصمیم میگیرد و اجرا میکند. فقط برای کارهای سبز و برگشتپذیر. مثل پیشنهاد موضوع ایمیل.
اختیار پیشنهاد (Recommendation): ابزار گزینه میسازد، انسان انتخاب و امضا میکند. برای کارهای زرد.
منع مطلق (Prohibited): ابزار حق ورود ندارد. مثل تصمیم نهایی استخدام، تأیید تراکنش مالی بزرگ، یا تشخیص پزشکی.
این ماتریس باید مکتوب، ابلاغشده و در سطح فنی اجراشده باشد؛ یعنی در خود سیستم، دسترسیها طوری تنظیم شود که AI نتواند از محدودهاش خارج شود — نه اینکه فقط روی کاغذ ممنوع باشد.
یک معیار ساده برای تعیین سطح اختیار: اگر این تصمیم اشتباه باشد، چقدر طول میکشد و چقدر هزینه دارد که برگردانیمش؟ هرچه برگشتپذیری سختتر، اختیار انسانی بیشتر.
اعتماد فقط فرهنگی نیست؛ فنی هم هست. چهار ابزار فنی که باید از ارائهدهنده AI خود مطالبه کنید:
RAG با ارجاع اجباری (Grounded Generation): مدل موظف شود هر ادعایی را فقط از اسناد داخلی شما و با ذکر منبع بیاورد. خروجی بدون منبع، بهصورت خودکار پرچمگذاری میشود.
امتیاز اطمینان (Confidence Score): سیستم برای هر پاسخ، یک سطح اطمینان گزارش کند و پاسخهای زیر آستانه، بهصورت خودکار به انسان ارجاع شوند.
فیلترهای خروجی (Output Guardrails): لایههایی که خروجی را از نظر نشت داده حساس، لحن نامناسب یا محتوای ممنوعه اسکن میکنند قبل از رسیدن به کاربر.
قابلیت ردیابی (Traceability): هر خروجی باید لاگ کامل داشته باشد: کدام مدل، کدام نسخه، کدام اسناد ورودی، کدام کاربر. بدون ردیابی، هیچ ممیزیای ممکن نیست.
وضعیت:
۱ آیا کارها بر اساس هزینه خطا، طبقهبندی سبز/زرد/قرمز شدهاند؟
🔲
۲ آیا برای خروجیهای قرمز، تأیید دونفره انسانی الزامی است؟
🔲
۳ آیا نرخ خطا با نمونهگیری هفتگی اندازهگیری و گزارش میشود؟
🔲
۴ آیا تست قرمز بعد از هر تغییر مدل اجرا میشود؟
🔲
۵ آیا ماتریس اختیار (اجرا/پیشنهاد/منع) مکتوب و فنی اجرا شده است؟
🔲
۶ آیا خروجیهای حساس، منبعدهی اجباری دارند؟
🔲
۷ آیا کانال گزارش خطای AI برای کارکنان و مشتریان فعال است؟
🔲
۸ آیا هر خروجی تأییدشده، صاحب انسانی مشخص دارد؟
🔲
خروجی هوش مصنوعی، نه امن است و نه ناامن؛ به اندازه چارچوبی که دور آن ساختهاید، امن است. همان وکیل نیویورکی، اگر یک چکلیست ساده «بررسی اعداد و منابع» داشت، امروز نامش در تاریخ رسواییها نبود.
فرمول اعتماد در سال ۲۰۲۶ ساده و بیرحم است: انسان تأیید کند، سیستم اندازه بگیرد، و محدودهها شفاف باشد. و همیشه یادتان بماند: هوش مصنوعی یک کارآموز نابغه است — بگذارید بدود، بگذارید بسازد، اما هرگز، هرگز نگذارید بدون امضای شما، چیزی را امضا کند.
جمله پایانی: اعتماد به هوش مصنوعی، هدیهای نیست که ماشین بدهد؛ دستاوردی است که سازمان با نظم میسازد.
با سه تکنیک: اول، بررسی هدفمند اعداد، نامها و ادعاهای علّی که بیشترین محل توهماند. دوم، درخواست منبع اجباری و راستیآزمایی آن منبع. سوم، سؤال معکوس از خود مدل برای نقد خروجیاش. هیچ نشانه زبانیای در متن، توهم را لو نمیدهد؛ فقط فرآیند اعتبارسنجی آن را کشف میکند.
بله، اما فقط بهعنوان «پیشنویس و پیشنهاد»، نه تصمیم نهایی. این خروجیها در دسته قرمز قرار میگیرند و باید با تأیید مکتوب متخصص انسانی (حسابرس، وکیل) و با منبعدهی اجباری استفاده شوند. استفاده خودکار از AI در تصمیمهای مالی و حقوقی، یکی از بزرگترین ریسکهای سازمانی است.
یعنی مشخص کردن دقیق حوزههایی که ابزار اجازه تصمیم مستقل دارد (کارهای کمریسک و برگشتپذیر)، حوزههایی که فقط پیشنهاد میدهد (کارهای متوسط)، و حوزههایی که ورودش ممنوع است (تصمیمهای حساس). این محدوده باید هم مکتوب ابلاغ شود و هم بهصورت فنی در دسترسیهای سیستم اعمال گردد.
بهعنوان قاعده سرانگشتی، ۵ تا ۰ درصد خروجیها بهصورت تصادفی و دورهای توسط متخصص بررسی شود تا نرخ خطا اندازهگیری شود. اگر نرخ خطا از آستانه تعریفشده سازمان (مثلاً ۲٪) عبور کرد، استفاده خودکار باید موقتاً متوقف و مدل یا فرآیند بازبینی شود.
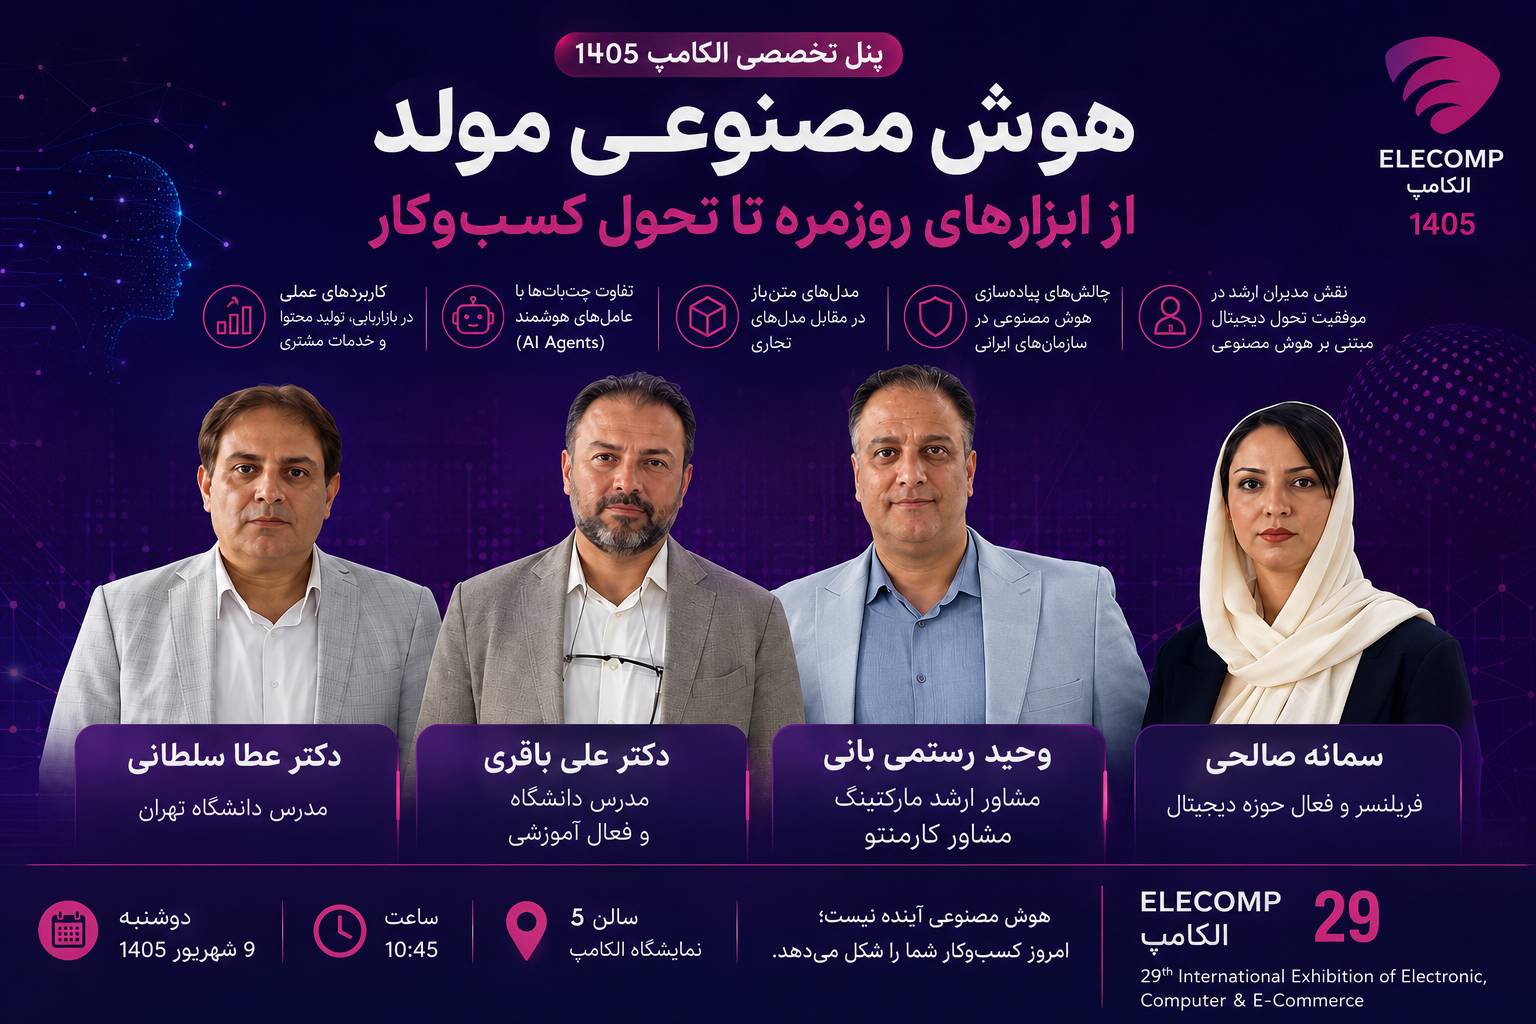
وحید رستمی بانی مشاور ارشد کسب و کار و استراتژیست تحول دیجیتال است. او به سازمانها کمک میکند تا با چارچوبهای حاکمیتی ساده و قابل اجرا، از هوش مصنوعی با حداکثر بهرهوری و حداقل ریسک استفاده کنند. وحید میزبان پنلهای تخصصی در رویدادهای ملی از جمله الکامپ ۲۰۲۶ است.
ارتباط با نویسنده:
LinkedIn: vahidrostamibani
Email: [email protected]

