
هوش مصنوعی شاخه ای از علوم کامپیوتر است که کامپیوتر(ماشین، سیستم) را قادر میسازد کارهایی که نیازمند هوش انسانی هست را انجام دهند.
هوش مصنوعی خود دارای زیر شاخه های فراوانیست:
سیستم های خبره، قانون محور، یادگیری ماشین
برای مثال قبل از اینکه یادگیری ماشین پا به میدان بگذارد، مهندسان و برنامهنویس ها فقط از سیستم های قانون محور برای حل مسائل استفاده میکردن. در سیستم های قانون محور به این صورت است که در شرایط خاص، عمل خاصی انجام شود.
ساده ترین حالتش استفاده از همان حالت های شرطی if/else است:
if input().lower() == "hello": print("hello! How are you?")
این سیستمها ساده و قابل درک هستن، ولی مشکلی اساسی دارن:
دنیای واقعی پیچیده است! و نوشتن تمام قوانین تقریباً غیرممکن! مثلاً اگه بخواهی سیستم تشخیص چهره بسازی، نمیتونی با قوانین ساده بگی "اگر بینی این شکلی بود و چشم اونجوری بود، آنگاه این شخص، سیناست:))" چون تنوع ویژگیها خیلی خیلی زیاده!
و اینجاست که روش جدیدی متولد میشه با نام: یادگیری ماشین!
در یادگیری ماشین اجازه میدهیم خود سیستم با دیدن دادهها، قوانین رو یاد بگیره. یعنی یک تغییر پارادایم بزرگ:
دیگه سیستم بهجای پیروی از قانون هایی که ما مینویسیم، با الگوریتم های مشخص از داده ها یاد میگیرد.
حالا اینکه چطور کامپیوتر از داده ها یاد بگیره بحث مفصلیه...
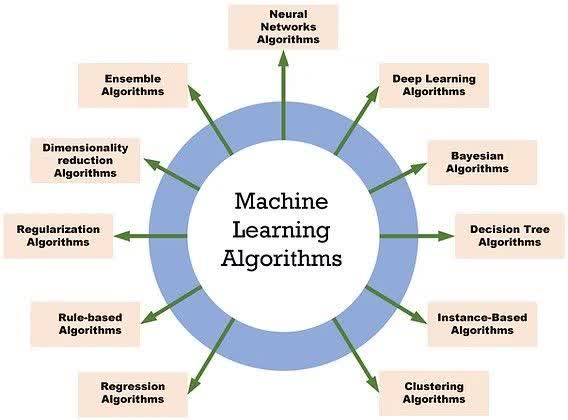
الگوریتم های مختلفی برای اینکار وجود داره که فعلا زیاد واردش نمیشیم مثل درخت تصمیم، رگرسیون خطی، ماشین بردار پشتیبان، شبکه عصبی، k نزدیک ترین همسایه و...
بعدا کامل درباره این الگوریتم ها صحبت میکنیم. فعلا بیشتر خود یادگیری ماشین و نحوه ایجاد مدل ها رو بررسی کنیم.
در حل مسائل معمولا با یکی از دو نوع زیر مواجه هستیم:
🔹 مسئله مستقیم: ما ورودی و قوانین سیستم رو داریم و میخوایم خروجی رو حساب کنیم. مثلاً در فیزیک، اگر موقعیت و سرعت اولیه یک توپ و نیروی وارد شده بهش رو بدونیم، میتونیم مسیر حرکتش رو با استفاده از قوانین نیوتن محاسبه کنیم.
مثال:
y = 2x+3
خب با این فرمول میتونیم راحت خروجی رو محاسبه کنیم، برای مثال اگر x=5:
y=2×5+3=13
🔹 مسئله معکوس، ما خروجی رو داریم، ورودی هایی که به اون خروجی منتهی شدند را هم داریم، اما میخوایم بفهمیم با چه فرمولی این ورودیها باعث تولید اون خروجی شدن.
مثال:
فرض کنید کلی داده ورودی و خروجی داریم و دنبال رابطه بینشون هستیم.
x=2
y=4
_ _ _
x=3
y=9
_ _ _
x=4
y=16
خب از این داده های بالا میتونیم یه فرمولی کشف کنیم، اینکه:
y=x²
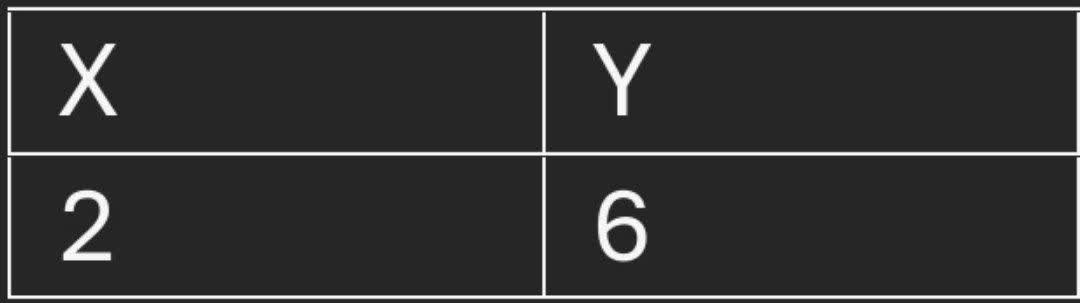
خب حالا فرض کنید این 👆 یک مسئله معکوسه و ما میخوایم ببینیم که چجوری میتونیم از x به y برسیم؟
فقط هم همین یک نمونه داده رو داریم!
خب با توجه به این دیتا من چندتا فرمول به دست میارم:
y = 2x+2
y = 3x
y = 4x-2
y = x² + 2
.
.
.
و هر کسی هم میتونه یه فرمول دیگه برای این مسئله ارائه بده 🙂
پس مسائل معکوس فقط یک جواب ندارن و ممکنه به چندین جواب برای یک مسئله برسیم. اما حالا این یکی رو ببینید:
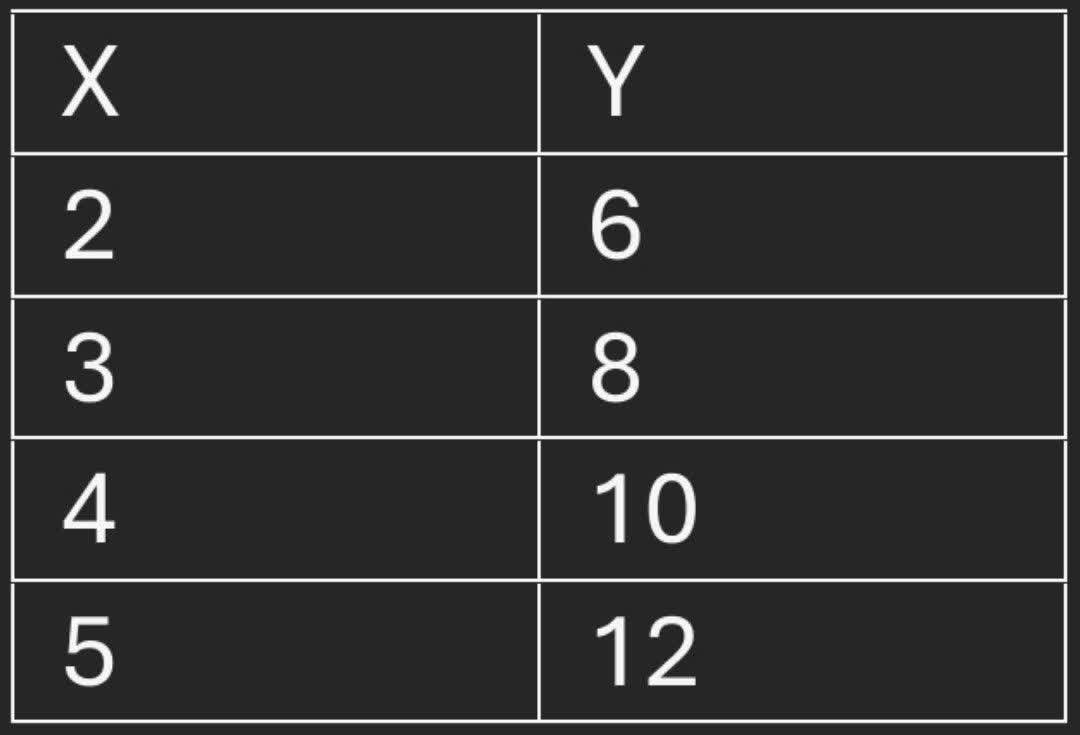
چند نمونه داده ی دیگه به همون اضافه کردم...
حالا آیا میتونیم از تمام اون فرمول هایی که بالاتر به دست آوردیم استفاده کنیم؟ خیر
از بین فرمول هایی که بالا نوشتیم الان فقط این درسته:
y = 2x + 2
باز هم این مسئله جواب های زیادی داره اما تعداد جواب ها خیلی محدود تر شده، چون دیگه فقط یک نمونه داده نداریم.
پس در یک مسئله معکوس هرچه تعداد نمونه داده ها بیشتر بشه، تعداد جواب های اون مسئله کمتر و محدودتر و دقیق تر میشه.
خب حالا اینا چه ربطی به هوش مصنوعی و یادگیری ماشین دارن؟ 🤨
مسائل معکوس دقیقا مسائل یادگیری ماشین هستن:)
یعنی ماشین از داده ها یاد میگیره و الگو های پنهان رو شناسایی میکنه. و بعد با الگو هایی که کشف کرده به تشخیص یا پیشبینی موارد مختلف میپردازد.
زمانی که حجم داده مناسبی داریم(متناسب با سختی مسئله)
داده هایمان دارای الگو باشند
با ریاضیات نتوانیم الگو ها را پیدا کنیم
مراحل ایجاد یک مدل یادگیری ماشین به این صورت هست:
۱. جمع آوری داده (Data collection)
۲. پیش پردازش داده (Data preprocessing)
۳. انتخاب ویژگی Feuture engineering
۴. انتخاب مدل Model selection
۵. آموزش مدل(یادگیری مدل از داده) Training
۶. استفاده از مدل inference
در آینده همه رو بیشتر توضیح خواهم داد:)

