
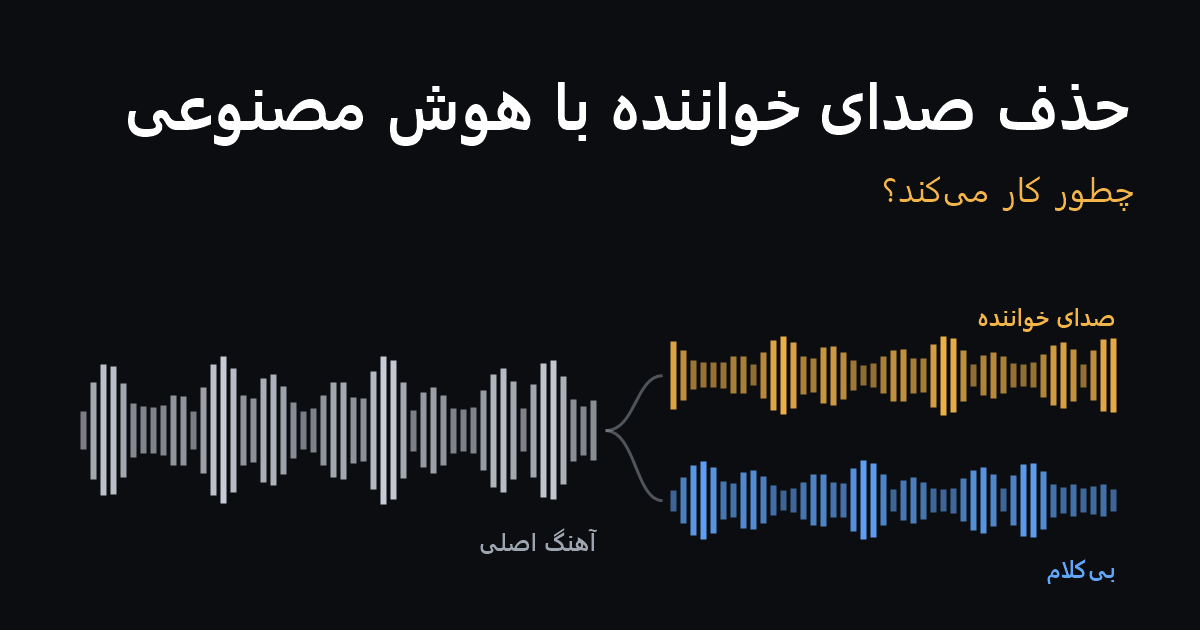
شاید شما هم دیده باشید که این روزها با چند کلیک میشود صدای خواننده را از یک آهنگ جدا کرد و نسخهی بیکلام یا آکاپلا گرفت. چند سال پیش این کار تقریباً غیرممکن بود. در این نوشته توضیح میدهم این کار چطور انجام میشود، چرا گاهی نتیجه بینقص نیست و چطور بهترین خروجی را بگیریم.
قبل از هوش مصنوعی، رایجترین روش این بود که کانال چپ و راست را از هم کم کنند. منطقش ساده است: در بیشتر آهنگها صدای خواننده دقیقاً وسط میکس است، یعنی در هر دو کانال یکسان است، پس وقتی یکی را از دیگری کم کنید حذف میشود.
مشکل اینجاست که بیس، کیک و اسنیر هم معمولاً وسط میکساند و همراه صدای خواننده حذف میشوند. از طرف دیگر، اکو و ریورب روی صدای خواننده استریو است و باقی میماند. نتیجه معمولاً یک بیکلام توخالی با سایهای از صدای خواننده است، و روی آهنگهای مونو اصلاً کار نمیکند.
مدلهای هوش مصنوعی جداسازی صدا (به انگلیسی Source Separation) با هزاران آهنگ آموزش دیدهاند که هر بخششان (وکال، درام، بیس و بقیه) جداگانه موجود بوده. مدل یاد میگیرد صدای انسان چه شکلی دارد و آن را از بقیه تشخیص میدهد، نه فقط بر اساس جایگاهش در میکس.
دو مدل معروف متنباز در این زمینه وجود دارد:
Spleeter: ساخت شرکت Deezer. روی طیف فرکانسی (اسپکتروگرام) کار میکند و برای هر بخش یک «ماسک» میسازد که میگوید هر نقطه از طیف چقدر مال وکال است. سریع است ولی گاهی صدایی کمی فلزی و آبکی در خروجی میگذارد.
Demucs (نسخهی HTDemucs): ساخت آزمایشگاه هوش مصنوعی Meta. همزمان هم روی خود موج صدا و هم روی طیف فرکانسی کار میکند و بخشی به نام Transformer دارد که کل آهنگ را در نظر میگیرد. کندتر و سنگینتر است، ولی خروجی تمیزتری میدهد و بیشتر ابزارهای حرفهای امروز از همین خانواده استفاده میکنند.
نکتهی جالب این است که امروز هر دوی این مدلها را میشود مستقیم داخل مرورگر اجرا کرد. فناوری WebGPU در Chrome و Edge اجازه میدهد مدل روی کارت گرافیک خودتان اجرا شود، پس دیگر لازم نیست فایل را روی سرور کسی آپلود کنید.
حتی بهترین مدلها هم گاهی اشتباه میکنند. چند دلیل اصلی:
سازهایی که شبیه صدای انساناند: ویولن، ساکسفون یا سنتیسایزرهای پد ممکن است با وکال اشتباه گرفته شوند.
بکوکال و همخوانی: صداهای پسزمینه و کر گاهی کامل حذف نمیشوند.
ریورب سنگین: دنبالهی اکوی صدای خواننده ممکن است کمرنگ در بیکلام بماند.
فایل کمکیفیت: فشردهسازی MP3 با بیتریت پایین جزئیاتی را از بین میبرد که مدل برای تشخیص لازم دارد.
۱. باکیفیتترین نسخهی آهنگ را پیدا کنید: FLAC یا دستکم MP3 با ۳۲۰ کیلوبیت. فایلی که از ویدیوی یوتیوب گرفته شده معمولاً نتیجهی ضعیفتری میدهد.
۲. مراقب فایلهای «لاسلس تقلبی» باشید: بعضی FLACها در واقع MP3 تبدیلشدهاند. اگر در طیف فرکانسی فایل، بالای ۱۶ یا ۱۹ کیلوهرتز ناگهان بریده باشد، احتمالاً از MP3 ساخته شده.
۳. اگر ابزار شما دو حالت دارد، برای کارائوکهی ساده حالت سریع کافی است؛ برای ریمیکس یا گرفتن آکاپلای تمیز، حالت کیفیت بالا (مثل HTDemucs) ارزش صبر کردن دارد.
۴. خروجی را با هدفون گوش کنید. باقیماندهی صدای خواننده روی اسپیکر گوشی معمولاً شنیده نمیشود.
۵. برای انتشار عمومی نسخهی بیکلام یا کاور، حواستان به حق نشر آهنگ اصلی باشد. جدا کردن صدا، مالکیت آهنگ را عوض نمیکند.
جداسازی صدا با هوش مصنوعی در چند سال از یک کار آزمایشگاهی به ابزاری رسیده که روی لپتاپ معمولی و حتی داخل مرورگر کار میکند. نتیجه هنوز کامل نیست، ولی برای کارائوکه، تمرین ساز و آواز، و حتی ریمیکس کاملاً قابل استفاده است.
اگر خواستید امتحان کنید، من نسخهای از همین دو مدل را در سایت ساندبنچ ساختهام که رایگان و بدون آپلود، داخل مرورگر اجرا میشود. لینکش در بیوی پروفایلم هست.

