
درود
این پست در رابطه با فراخوان زیر تهیه شده است ( لینک ):
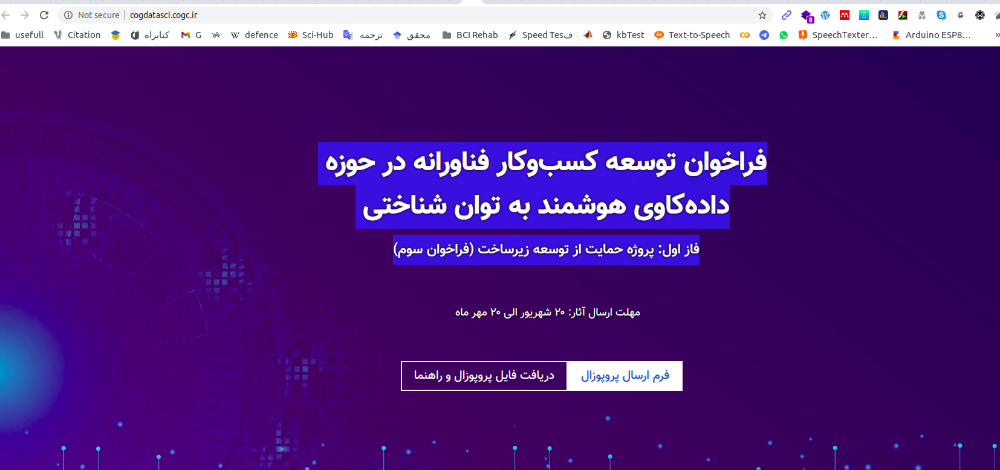
محورهای این فراخوان در زیر قابل مشاهده می باشند:
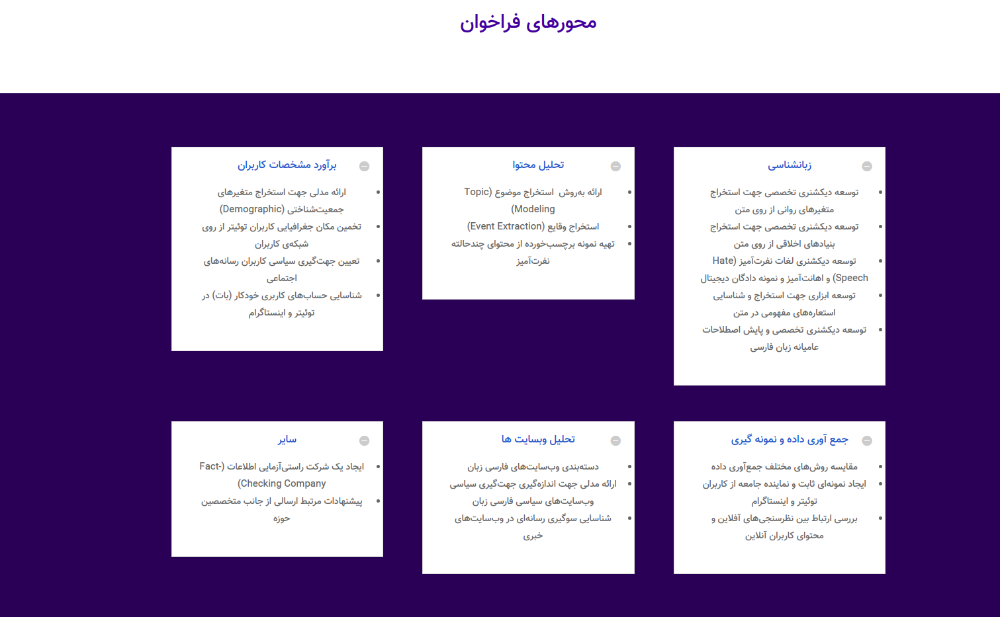
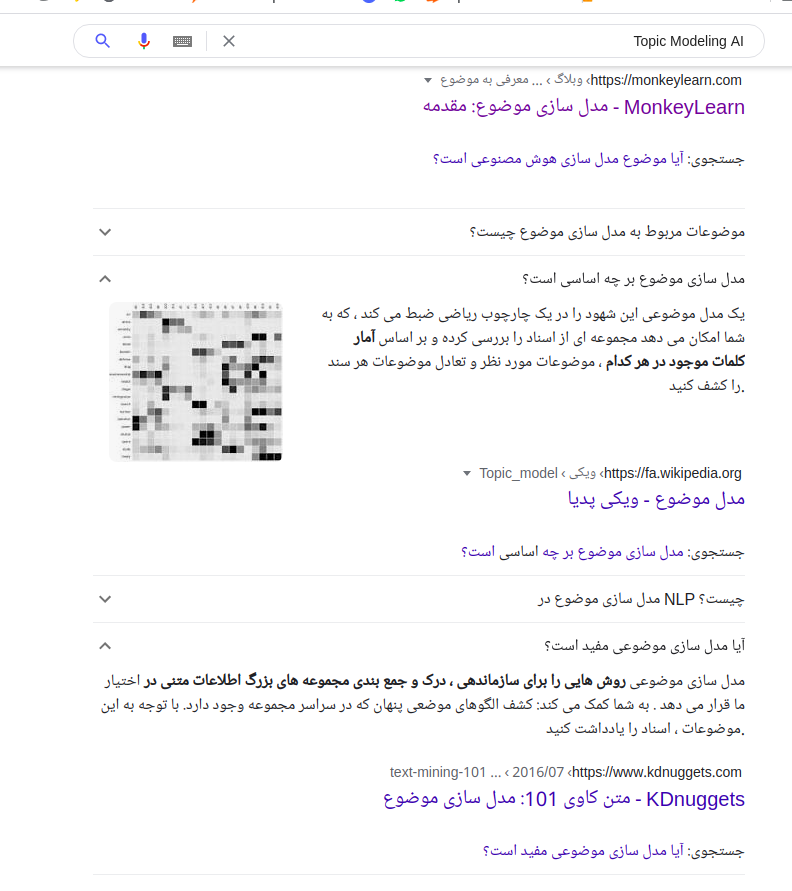
یکی از این محورها استخراج عناوین از متن می باشد. استخراج عناوین از متن بر اساس ترجمه گوگل و جستجوی سریع در زیر توضیح داده شده :
برای آشنایی با موضوع جداسازی عنوان از متن، ۲ ویدیوی زیر قابل توجه می باشد ( لینک ۱ و ۲ ):
یک مدل موضوعی این شهود را در یک چارچوب ریاضی ضبط می کند ، که به شما امکان می دهد مجموعه ای از اسناد را بررسی کرده و بر اساس آمار کلمات موجود در هر کدام ، موضوعات مورد نظر و تعادل موضوعات هر سند را کشف کنید (لینک).
مدل عناوین
از ویکیپدیا، دانشنامهٔ آزاد
مدل عناوین مدل توسعه یافتهٔ آنالیز پنهان مفهومی احتمالی است که دارای ساختاری بیزوی با توزیع پیشین دیریکله روی کلمات است.[۱]
در یادگیری ماشین و پردازش زبان طبیعی، یک مدل عنوان، یک نوع از مدل آماری برای کشف "عنوانهای" چکیده که در یک مجموعه از اسناد رخ میدهند میباشد. مستقیماً، با توجه به اینکه یک سند در مورد یک عنوان خاص است، کسی انتظار لغتهای خاص برای ظاهر شدن غالباً ببیشتر یا کمتر را در سند خواهد داشت: "سگ" و "استخوان" در اسناد در مورد سگها غالباً ظاهر میشوند، "گربه" و "میو" در اسناد در مورد گربهها در اسناد در مورد گربه ظاهر خواهند شد، "the" و "is" به طور مساوی در هر دو ظاهر خواهند شد. یک سند به طور معمول به چندین عنوان در نسبتهای مختلف مربوط میشود؛ بنابراین، در یک سند که 10% در مورد گربهها و 90% در مورد سگهاست، احتمالاً حدود 9 مرتبه بیشتر لغات سگ از لغات گربه خواهند بود. یک مدل عنوان این بصیرت را در یک چهارچوب ریاضی تسخیر میکند، که آزمایش یک مجموعه از اسناد و کشف را بر اساس آمار لغات در هر کدام، که عنوانها ممکن است چه باشند و هر موازنهی سند عنوان چیستند، اجازه میدهد.
اگرچه مدلهای عنوان در ابتدا در محتوای پردازش زبان طبیعی توصیف و پیادهسازی شدند، آنها کاربرهایی در دیگر زمینهها از قبیل بیوانفورماتیک(تحقیقات زیستی) دارند.
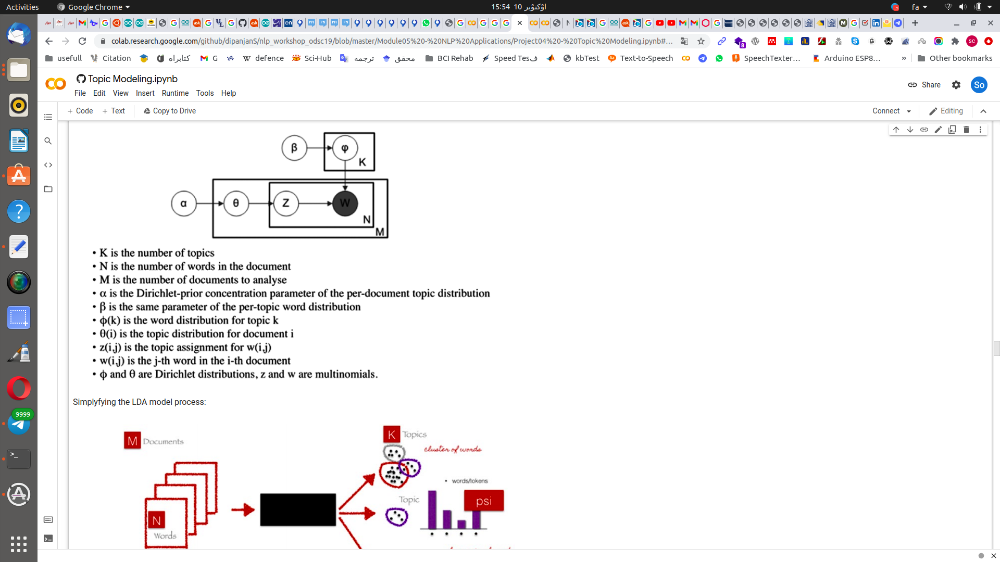
آیا مدل سازی موضوعی مفید است؟<br/>مدل سازی موضوعی روش هایی را برای سازماندهی ، درک و جمع بندی مجموعه های بزرگ اطلاعات متنی در اختیار ما قرار می دهد . به شما کمک می کند: کشف الگوهای موضعی پنهان که در سراسر مجموعه وجود دارد. با توجه به این موضوعات ، اسناد را یادداشت کنید
Topic Modeling site:colab.research.google.com:
1-1 Topic Modeling on Research Papers: (Working!)
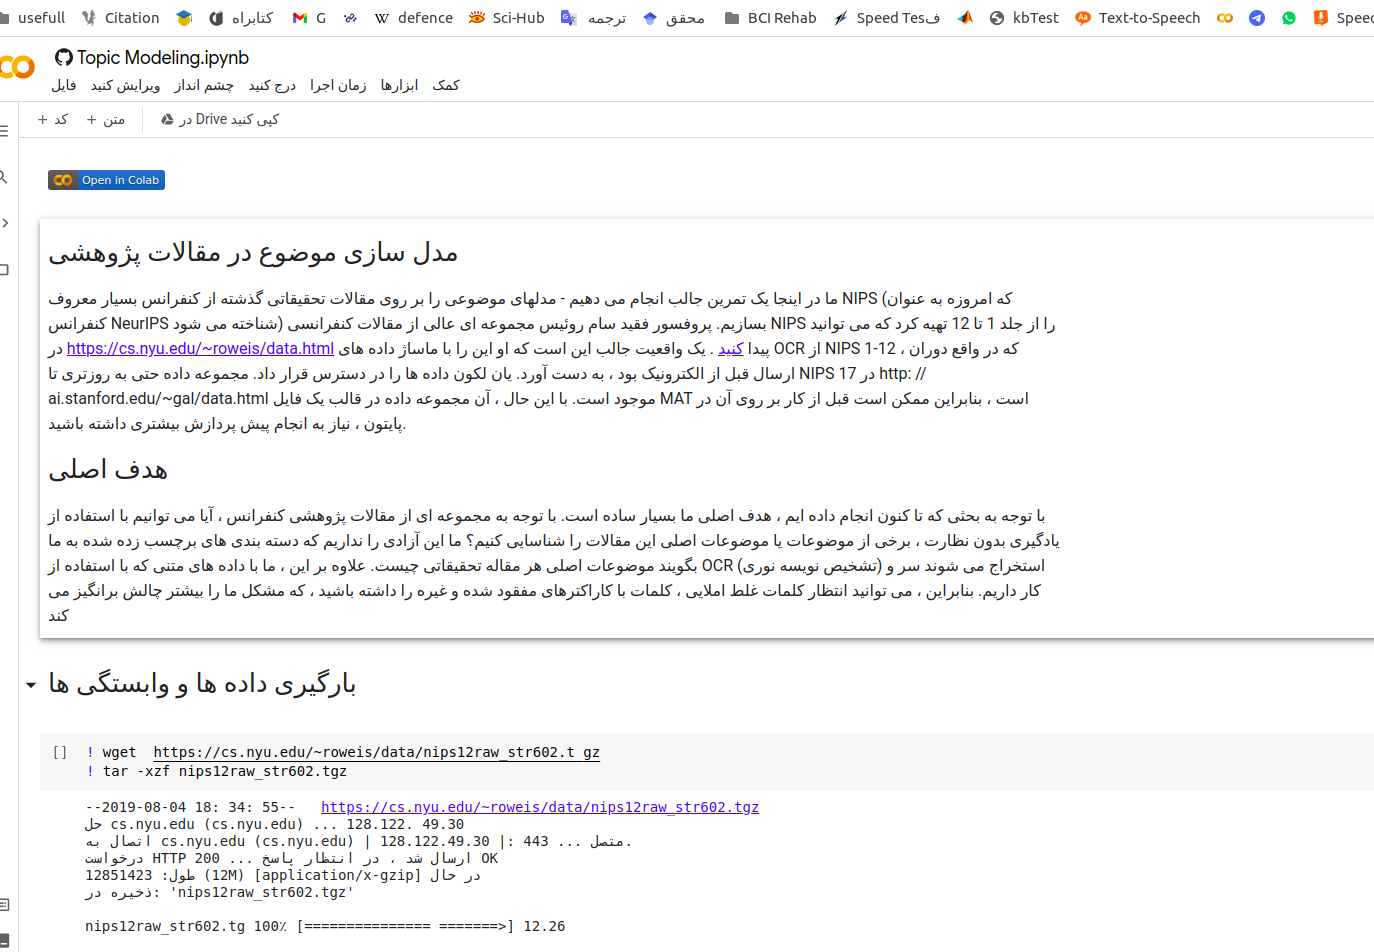
مدل سازی موضوع در مقالات پژوهشی
ما در اینجا یک تمرین جالب انجام می دهیم - مدلهای موضوعی را بر روی مقالات تحقیقاتی گذشته از کنفرانس بسیار معروف NIPS (که امروزه به عنوان کنفرانس NeurIPS شناخته می شود) بسازیم. پروفسور فقید سام روئیس مجموعه ای عالی از مقالات کنفرانسی NIPS را از جلد 1 تا 12 تهیه کرد که می توانید در https://cs.nyu.edu/~roweis/data.html پیدا کنید . یک واقعیت جالب این است که او این را با ماساژ داده های OCR از NIPS 1-12 ، که در واقع دوران ارسال قبل از الکترونیک بود ، به دست آورد. یان لکون داده ها را در دسترس قرار داد. مجموعه داده حتی به روزتری تا NIPS 17 در http: // ai.stanford.edu/~gal/data.html موجود است. با این حال ، آن مجموعه داده در قالب یک فایل MAT است ، بنابراین ممکن است قبل از کار بر روی آن در پایتون ، نیاز به انجام پیش پردازش بیشتری داشته باشید.
هدف اصلی
با توجه به بحثی که تا کنون انجام داده ایم ، هدف اصلی ما بسیار ساده است. با توجه به مجموعه ای از مقالات پژوهشی کنفرانس ، آیا می توانیم با استفاده از یادگیری بدون نظارت ، برخی از موضوعات یا موضوعات اصلی این مقالات را شناسایی کنیم؟ ما این آزادی را نداریم که دسته بندی های برچسب زده شده به ما بگویند موضوعات اصلی هر مقاله تحقیقاتی چیست. علاوه بر این ، ما با داده های متنی که با استفاده از OCR (تشخیص نویسه نوری) استخراج می شوند سر و کار داریم. بنابراین ، می توانید انتظار کلمات غلط املایی ، کلمات با کاراکترهای مفقود شده و غیره را داشته باشید ، که مشکل ما را بیشتر چالش برانگیز می کند
1-2 ODSC India 2019 - NLP Workshop:
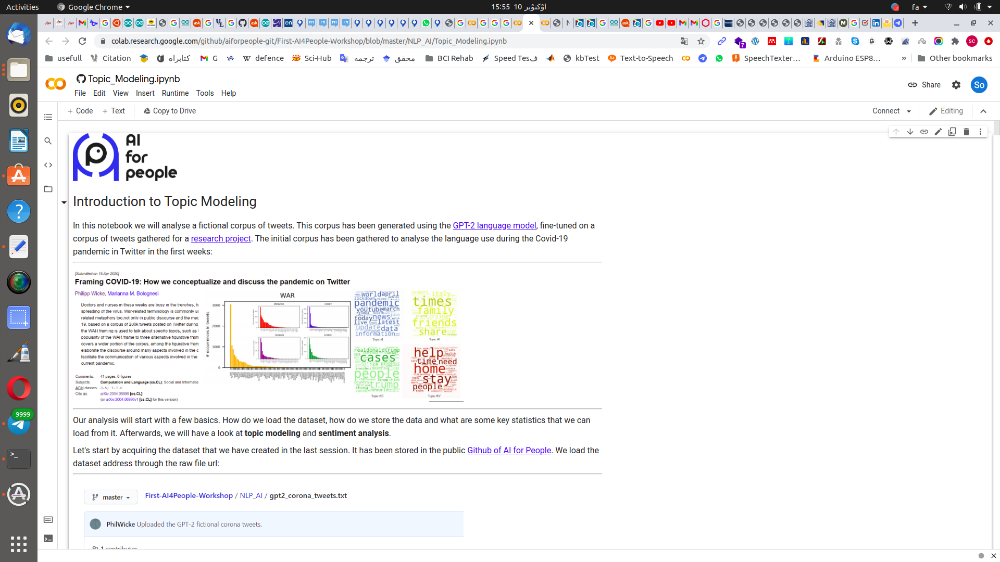
2-Introduction to Topic Modeling: ( Working !)
3-Picking the "right" number of topics for a scikit-learn topic model:
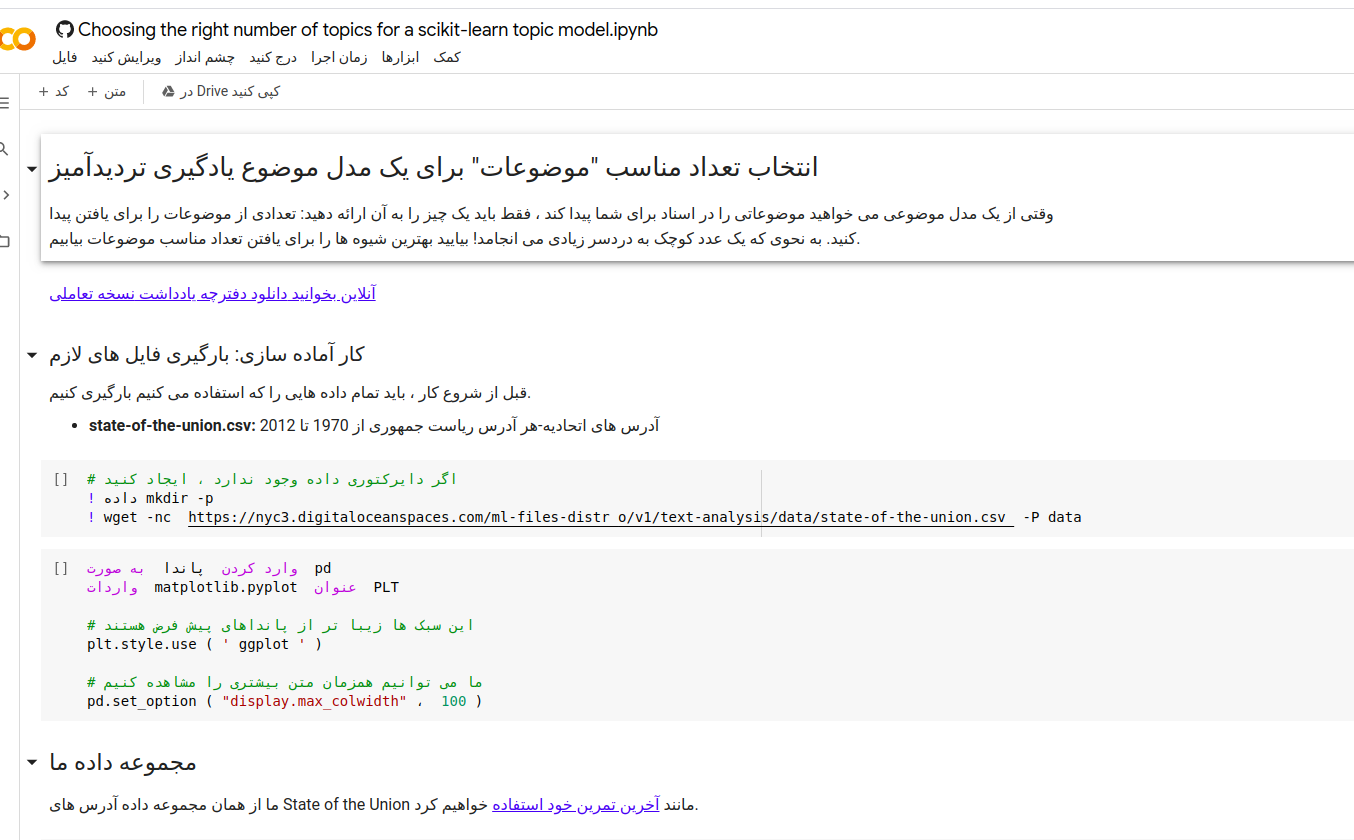
انتخاب تعداد مناسب "موضوعات" برای یک مدل موضوع یادگیری تردیدآمیز
وقتی از یک مدل موضوعی می خواهید موضوعاتی را در اسناد برای شما پیدا کند ، فقط باید یک چیز را به آن ارائه دهید: تعدادی از موضوعات را برای یافتن پیدا کنید. به نحوی که یک عدد کوچک به دردسر زیادی می انجامد! بیایید بهترین شیوه ها را برای یافتن تعداد مناسب موضوعات بیابیم.
آنلاین بخوانید دانلود دفترچه یادداشت نسخه تعاملی
4-Transformer-based Encoder-Decoder Models:
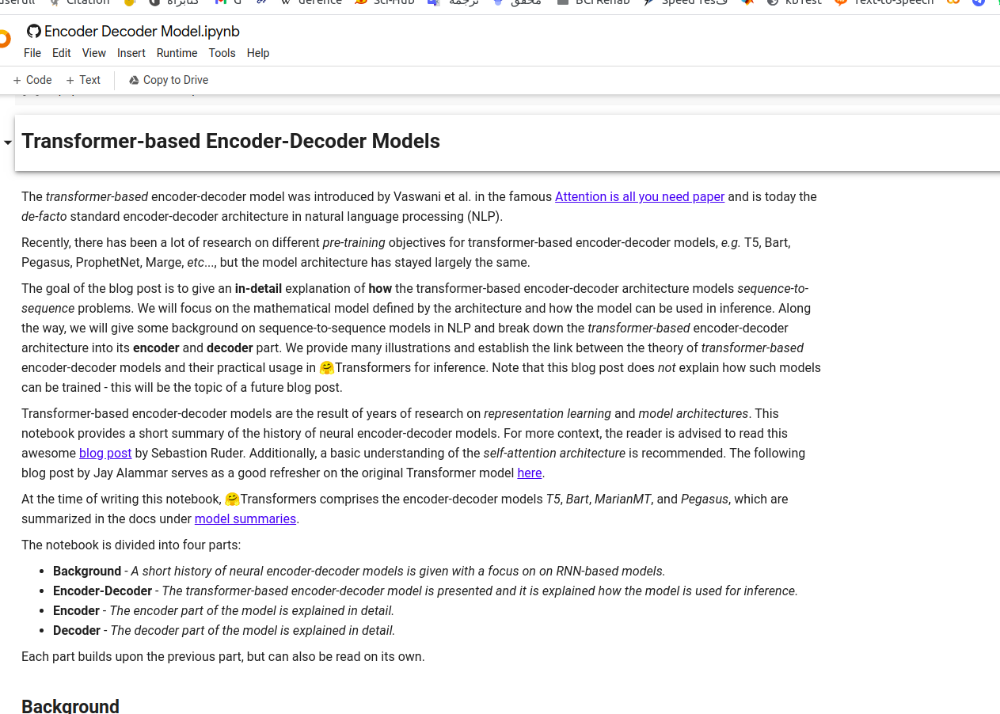
ترانسفورماتور مبتنی بر مدل رمزگذار-رسیور های Vaswani و همکاران معرفی شد. در معروف توجه همه شما نیاز به کاغذ و امروز است ، به طور بالفعل معماری استاندارد رمزگذار-رسیور در پردازش زبان طبیعی (NLP).
به تازگی ، تحقیقات زیادی در مورد اهداف مختلف پیش از آموزش برای مدل های رمزگذار رمزگذار مبتنی بر ترانسفورماتور ، مانند T5 ، بارت ، Pegasus ، ProphetNet ، Marge و غیره ... انجام شده است ، اما معماری مدل تا حد زیادی ثابت مانده است.
هدف از پست وبلاگ این است که توضیحی مفصل در مورد چگونگی مدل سازی معماری رمزگذار رمزگشای مبتنی بر ترانسفورماتور مشکلات دنباله به دنباله ارائه دهد . ما بر مدل ریاضی تعریف شده توسط معماری و نحوه استفاده از مدل در نتیجه گیری تمرکز می کنیم. در طول راه ، ما برخی از مدلهای دنباله به دنباله در NLP را ارائه می دهیم و معماری رمزگذار-رمزگشای مبتنی بر ترانسفورماتور را به قسمت رمزگذار و رمزگشای آن تقسیم می کنیم. ما تصاویر زیادی ارائه می دهیم و بین نظریه مدل های رمزگذار رمزگشای مبتنی بر ترانسفورماتور و کاربرد عملی آنها در ترانسفورماتورها برای استنتاج پیوند ایجاد می کنیم. توجه داشته باشید که این پست وبلاگ این کار را می کندتوضیح ندهید که چگونه می توان چنین مدلهایی را آموزش داد - این موضوع یک پست وبلاگ آینده خواهد بود.
مدل های رمزگذار-رمزگشای مبتنی بر ترانسفورماتور نتیجه سال ها تحقیق در مورد یادگیری نمایشی و معماری های مدل است . این نوت بوک خلاصه ای کوتاه از تاریخچه مدل های رمزگذار عصبی-رمزگشایی ارائه می دهد. برای درک بیشتر ، به خواننده توصیه می شود که این پست وبلاگ عالی توسط سباستین رودر را بخواند. علاوه بر این ، درک اساسی از معماری خود توجه توصیه می شود. پست وبلاگ زیر توسط Jay Alammar به عنوان طراوت خوبی در مدل اصلی Transformer در اینجا عمل می کند .
در زمان نگارش این دفترچه ، ransTransformers شامل مدل های رمزگذار T5 ، Bart ، MarianMT و Pegasus است که در اسناد خلاصه شده در خلاصه مدل ها خلاصه شده است .
دفترچه یادداشت به چهار قسمت تقسیم می شود:
سابقه و هدف - تاریخچه کوتاهی از مدل های رمزگشایی عصبی با تمرکز بر مدل های مبتنی بر RNN ارائه شده است.
رمزگذار-رسیور - مدل رمزگذار-رسیور ترانسفورماتور مبتنی بر ارائه شده و لازم به توضیح است که چگونه مدل برای استنتاج استفاده می شود.
رمزگذار - قسمت رمزگذار مدل با جزئیات توضیح داده شده است.
رسیور - بخش رسیور مدل است که در جزئیات توضیح داده شده است.
هر قسمت بر اساس قسمت قبلی ساخته شده است ، اما همچنین می تواند به تنهایی خوانده شود.
5-Domain DPAPI Backup Key Extraction:
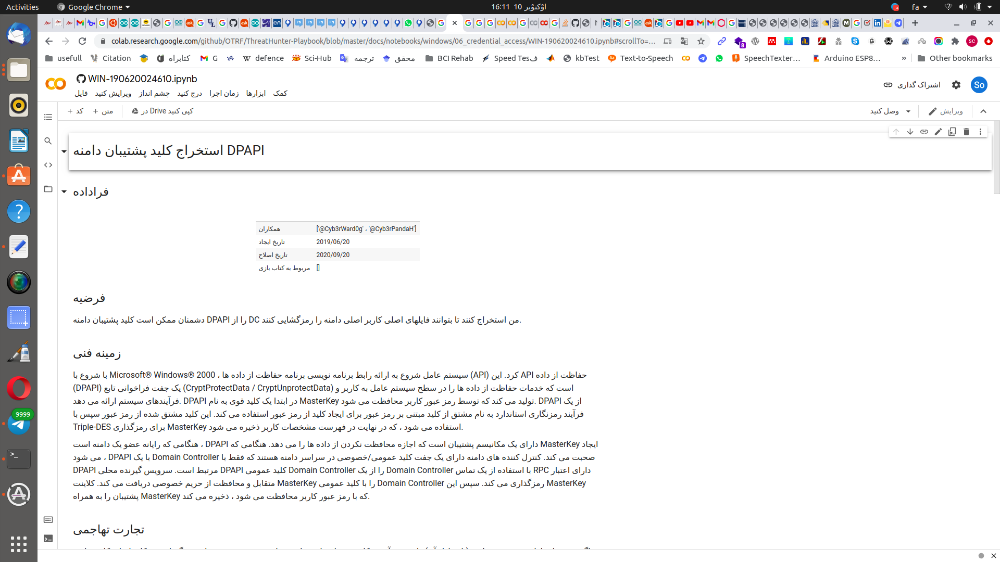
فرضیه
دشمنان ممکن است کلید پشتیبان دامنه DPAPI را از DC من استخراج کنند تا بتوانند فایلهای اصلی کاربر اصلی دامنه را رمزگشایی کنند.
با شروع با Microsoft® Windows® 2000 ، سیستم عامل شروع به ارائه رابط برنامه نویسی برنامه حفاظت از داده ها (API) کرد. این API حفاظت از داده (DPAPI) یک جفت فراخوانی تابع (CryptProtectData / CryptUnprotectData) است که خدمات حفاظت از داده ها را در سطح سیستم عامل به کاربر و فرآیندهای سیستم ارائه می دهد. DPAPI در ابتدا یک کلید قوی به نام MasterKey تولید می کند که توسط رمز عبور کاربر محافظت می شود. DPAPI از یک فرآیند رمزنگاری استاندارد به نام مشتق از کلید مبتنی بر رمز عبور برای ایجاد کلید از رمز عبور استفاده می کند. این کلید مشتق شده از رمز عبور سپس با Triple-DES برای رمزگذاری MasterKey استفاده می شود ، که در نهایت در فهرست مشخصات کاربر ذخیره می شود.
هنگامی که رایانه عضو یک دامنه است ، DPAPI دارای یک مکانیسم پشتیبان است که اجازه محافظت نکردن از داده ها را می دهد. هنگامی که MasterKey ایجاد می شود ، DPAPI با یک Domain Controller صحبت می کند. کنترل کننده های دامنه دارای یک جفت کلید عمومی/خصوصی در سراسر دامنه هستند که فقط با DPAPI مرتبط است. سرویس گیرنده محلی DPAPI کلید عمومی Domain Controller را از یک Domain Controller با استفاده از یک تماس RPC دارای اعتبار متقابل و محافظت از حریم خصوصی دریافت می کند. کلاینت MasterKey را با کلید عمومی Domain Controller رمزگذاری می کند. سپس این MasterKey پشتیبان را به همراه MasterKey که با رمز عبور کاربر محافظت می شود ، ذخیره می کند.
در رابطه با جذب همکاری هایی برای جذب تیم جهت کار بر روی پروژه های متن باز, مطرح شده در این اکانت (مانند این و این), نیز سؤال زیر را پرسیدم (لینک):
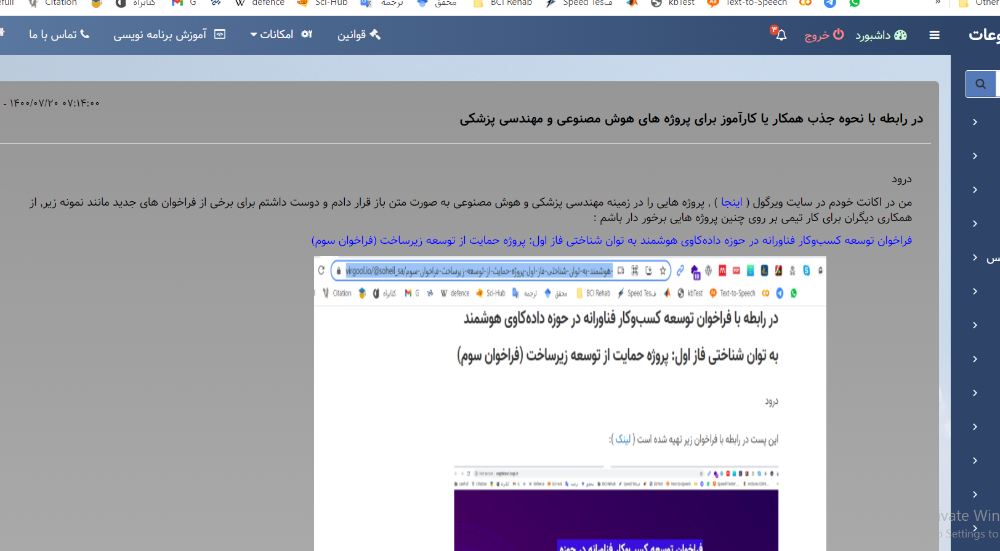
همچنین بخش های جالب سوال بالا در زیر قابل مشاهده می باشد:
بر اساس تصویر زیر فراخوان بالا امکان حمایتی هایی تا حدود 250 میلیون تومان را برای تیم های پذیرش شده, دارد که فرصت خوبی برای تمرین کار تیمی و کار بر روی پروژه های متن باز می باشد (لینک فایل: 1 , 2 و 3):
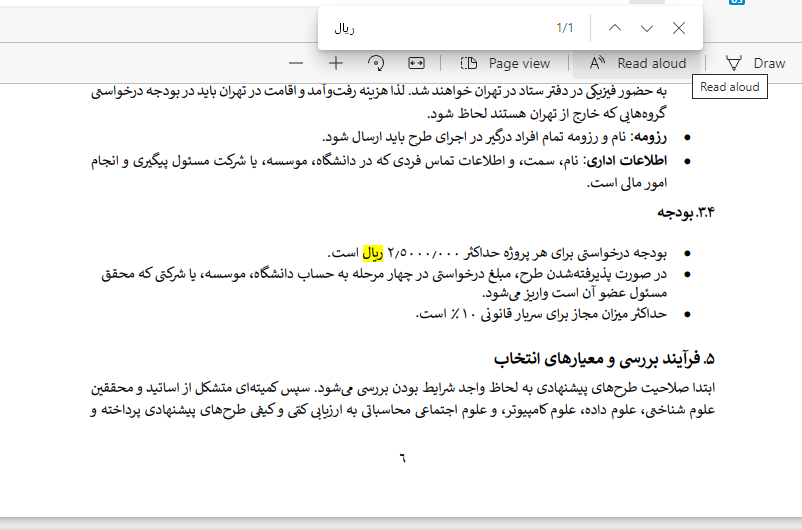
با این وجود به نظر میرسد که تمایل جامعه ایرانی برای بستن کدهای پروژه و ایجاد انحصار تا حدی مشل ساز باشد و آگهی هایی که د راین زمینه برای حذب همکاری تا به این زمان در سایت دیوار یا شیپور درج شده سات چندان موفق نبوده است.
بر این اساس دوست داشتم نظر شما را برای شرکت در پروژه های متن بازی که در اینجا قرار دادم و در صورت تمایل می توانید از طریق این لینک تلگرام با من در این باره در تماس باشید.
همچنین در صورت تمایل دوست داشتم در مورد احتمال میزان استقبلا جامعه فراسی زبان در این منطقه و یا تجربه و ایراداتی که در این نوع از همکاری ها می شناسید نیز نظر شما را جویا باشم.
با تشکر

