
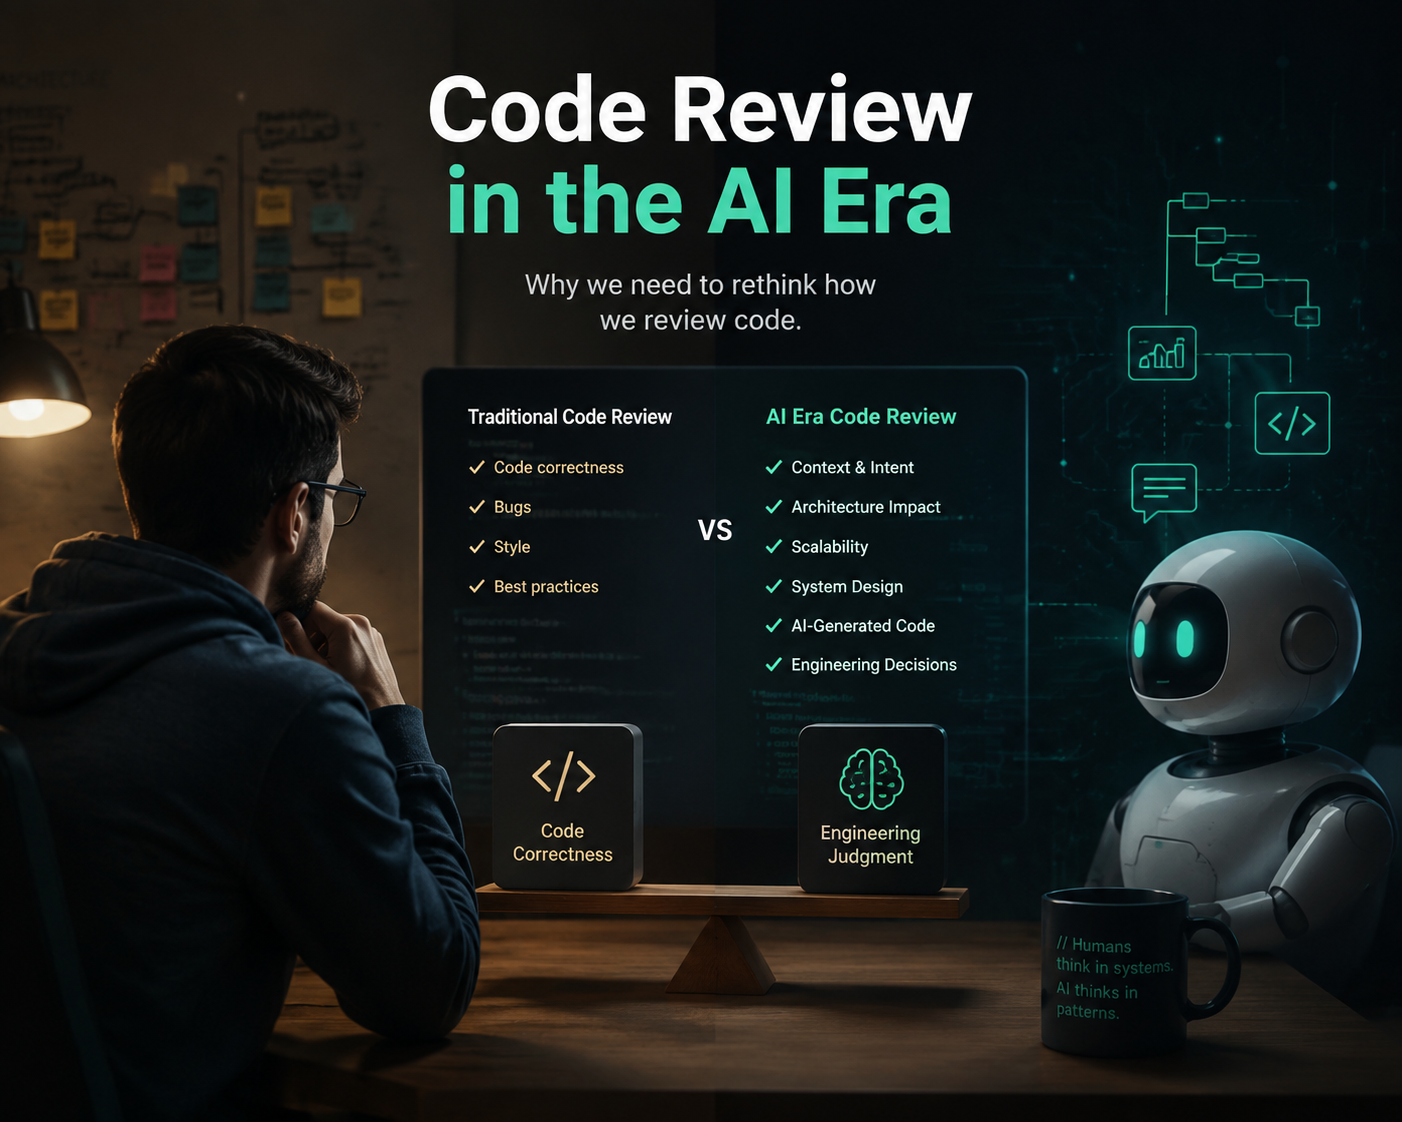
یکی از چیزهایی که این روزها خیلی بهش فکر میکنم اینه که AI فقط روش کدنویسی ما رو تغییر نداده؛ به نظرم مجبور شدیم یکی از مهمترین Engineering Practices هامون یعنی Code Review رو هم از نو تعریف کنیم.
چند سال قبل وقتی درباره Code Review صحبت میکردیم، معمولاً چند هدف اصلی داشتیم:
مطمئن شویم کیفیت کد (Code Quality) حفظ شود.
استانداردها و Coding Conventionهای پروژه رعایت شوند.
دانش و تجربه بین اعضای تیم (Knowledge Sharing) منتقل شود.
به رشد افراد (Developer Growth) از طریق feedback روی کد واقعی کمک شود.
در واقع Code Review فقط یک مرحله قبل از Merge نبود؛ یکی از مکانیزمهایی بود که کمک میکرد یک تیم بزرگ بتواند روی یک محصول بزرگ با کیفیت قابل قبول حرکت کند.
این موضوع برای من از تجربه چند سال کار در اسنپفود شفافتر شد؛ جایی که چندین تیم با تعداد زیادی Developer با سطح تجربه، سبک کاری و دیدگاههای متفاوت روی بخشهای مختلف محصول کار میکنند.
در چنین محیطی اگر هر کسی با سلیقه خودش کد بزند، بعد از مدتی یک Codebase داریم که بیشتر شبیه مجموعهای از تصمیمهای جدا از هم است تا یک سیستم یکپارچه.
برای همین در طول این سالها در اسنپفود تلاش کردیم Code Review را تبدیل به یک فرایند مهندسی کنیم:
Layered Code Review رو سروشکل دادیم.
برای تغییرات مهم چند Approval ایجاد کردیم.
Reviewer Rotation رو جدی گرفتیم تا دانش بین افراد پخش شود.
با کمک CI/CD Pipeline و Automated Checks، مشکلات تکراری مثل lint، formatting، type error و بعضی ruleهای پروژه را قبل از رسیدن به انسان حل کردیم.
اما حالا یک سوال مهم وجود دارد:
وقتی بخش بزرگی از کدی که تولید میکنیم دیگر مستقیماً توسط انسان نوشته نمیشود، آیا همان مدل Code Review هنوز کافی است؟
تجربهای که در این مدت با استفاده گستردهتر از AI داشتیم، چند نکته جالب برای من داشت:
یکی از اولین چیزهایی که بعد از استفاده جدیتر از AI دیدیم این بود که حجم کد تولیدی بیشتر شده.
Pull Requestها بزرگتر شدند، تغییرات سریعتر اتفاق میافتند و پیدا کردن Side Effectها سختتر شده.
اما به نظرم خود این موضوع الزاماً مشکل نیست.
حتی میتواند نشانه این باشد که تیم سریعتر شده و توانسته کار بیشتری Delivery کند.
مشکل جایی شروع میشود که حجم تغییری که تولید میکنیم از میزان درکی که از آن داریم جلو میزند.
یعنی ممکن است یک تغییر بزرگ داشته باشیم که:
Testها Pass شدهاند.
کد Clean به نظر میرسد.
حتی Review هم شده است.
اما سوال اینجاست:
چقدر دقیق میدانیم چه بخشهایی از سیستم تحت تاثیر قرار گرفته؟
چقدر مطمئنیم چیزی که AI ساخته دقیقاً همان چیزی است که نیاز داشتیم؟
چقدر مطمئنیم یک مشکل کوچک را به جای دیگری منتقل نکردهایم؟
به نظرم اولین Paradigm Shift در عصر AI این است که هدف ما نباید فقط Writing More Code باشد.
باید بیشتر روی این تمرکز کنیم که:
مسئله را دقیق تعریف کنیم.
Context کافی به AI بدهیم.
Scope تغییر را کنترل کنیم.
Feedback Loopهای سریعتری برای پیدا کردن مشکل بسازیم.
افزایش سرعت Delivery وقتی ارزشمند است که همراه با افزایش Visibility و کنترل روی تغییرات باشد؛ وگرنه فقط حجم بیشتری از ریسک را سریعتر وارد سیستم میکنیم.
یکی از رفتارهای جالبی که خودم بارها با AI دیدم این است که اگر راه سادهتری برای انجام یک کار وجود داشته باشد، معمولاً به سمت آن میرود.
مثلاً در پروژههای ما ابزارهایی مثل Husky و lint-staged بخشی از Developer Workflow هستند.
این ابزارها کمک میکنند قبل از Commit:
خطاهای TypeScript مشخص شوند.
Ruleهای Lint بررسی شوند.
Testها خراب نباشند.
Quality Gateهای اولیه همان ابتدا بررسی شوند.
اما جالب است که بعضی وقتها مدلها ترجیح میدهند این مسیر را دور بزنند؛ مثلاً با پیشنهادهایی مثل --no-verify.
این اتفاق برای من یک نکته مهم داشت:
ما نباید فقط به AI بگوییم چه چیزی بسازد؛ باید مشخص کنیم در چه چارچوبی اجازه دارد حرکت کند.
همانطور که برای یک Developer جدید:
Project Context را توضیح میدهیم.
Constraintها را مشخص میکنیم.
مسیرهای اشتباه را نشان میدهیم.
برای AI Agentها هم باید همین کار را انجام دهیم.
ساختن Guardrail، محدود کردن دسترسیها و تعریف Workflow مشخص، بخشی از Engineering استفاده از AI خواهد بود.
یکی از چیزهایی که کار با AI را جذاب و البته خطرناک میکند این است که Output آن معمولاً خیلی قابل اعتماد به نظر میرسد.
Code مرتب است.
Naming خوب است.
Structure منطقی است.
اما یک مشکل اساسی وجود دارد:
AI فقط با Contextی که به آن دادهایم تصمیم میگیرد.
یک مثال واقعی:
در یکی از کارها نیاز داشتیم یک سری Data را به جای URL داخل Codebase نگه داریم و در عین حال با Refresh صفحه دیتا از بین نرود.
AI خیلی راحت یک Solution با Session Storage پیشنهاد داد و از نظر Implementation هم درست کار میکرد.
اما چیزی که نمیدانست این بود که ما در اسنپفود با هزاران Vendor کار میکنیم.
اگر قرار باشد برای هر Vendor یک Record در Session Storage ایجاد شود، ممکن است در Scale واقعی باعث مشکل Performance شود یا Bugهایی ایجاد کند که پیدا کردنشان بسیار سخت باشد.
مشکل AI این نبود که Code بد نوشته بود.
مشکل این بود که مسئله را در محدوده Code دید، نه در محدوده System.
اینجا جایی است که هنوز ارزش Engineer مشخص میشود.
Engineer باید بتواند:
Scale سیستم را ببیند.
Impact تصمیمها را پیشبینی کند.
Edge Caseها را پیدا کند.
سوالهایی بپرسد که AI نمیپرسد.
در دنیای AI، مسئله فقط این نیست که چقدر سریع میتوانیم Code تولید کنیم؛ مسئله این است که چقدر خوب میفهمیم چیزی که ساختهایم چه اثری روی سیستم میگذارد.
یکی از دغدغههای قدیمی Code Review این بود که مطمئن شویم Code:
Clean است.
Standardها را رعایت میکند.
از Patternهای درست استفاده میکند.
اما با AI، بخش زیادی از این موارد میتواند توسط Toolها بهتر و سریعتر بررسی شود.
چیزی که هنوز نیاز به فکر مهندسی دارد:
آیا مسئله درست فهمیده شده؟
آیا این Solution با Architecture ما هماهنگ است؟
چه Trade-offهایی داریم؟
چه Side Effectهایی ممکن است ایجاد شود؟
اگر سیستم ۱۰ برابر بزرگتر شود چه اتفاقی میافتد؟
به نظرم Code Review در آینده باید بیشتر به سمت:
Engineering Decision Review
حرکت کند.
یکی از ارزشمندترین بخشهای Code Review همیشه برای من بخش یادگیری آن بوده.
وقتی یک Developer کد خودش را توضیح میدهد یا درباره یک Solution بحث میکنیم، فقط کیفیت همان تغییر بهتر نمیشود؛ افراد هم رشد میکنند.
حالا که AI بخش زیادی از Code را تولید میکند، یک سوال مهم داریم:
فرآیند یادگیری چه میشود؟
تجربه شخصی من این است که نباید فقط از AI بخواهیم Task را انجام دهد.
باید از آن برای بهتر فکر کردن استفاده کنیم:
چرا این Approach را انتخاب کردی؟
چه Alternativeهایی وجود داشت؟
Trade-off این تصمیم چیست؟
اگر Scale تغییر کند چه اتفاقی میافتد؟
AI باید سرعت فکر کردن ما را بیشتر کند، نه اینکه جای فکر کردن ما را بگیرد.
به نظرم فرایند Code Review در آینده رو به کمرنگ شدن نمیرود.
اتفاقاً شاید مهمتر هم بشود.
اما سوالی که باید از خودمان بپرسیم تغییر کرده:
قبلاً میپرسیدیم:
"Is this code written well?"
شاید امروز سوال مهمتر این باشد:
"Is this the right engineering decision?"
چون وقتی تولید Code سریعتر و ارزانتر میشود، ارزش اصلی Engineerها در توانایی دیدن تصویر بزرگتر، فهمیدن مسئله و گرفتن تصمیمهای بهتر خواهد بود.
خیلی دوست دارم تجربه شما رو هم بدونم.
در تیم شما بعد از ورود AI چه چیزهایی در فرآیند Coding یا Code Review تغییر کرده؟
چه چیزهایی بهتر شده و چه چالشهایی هنوز حل نشده؟

